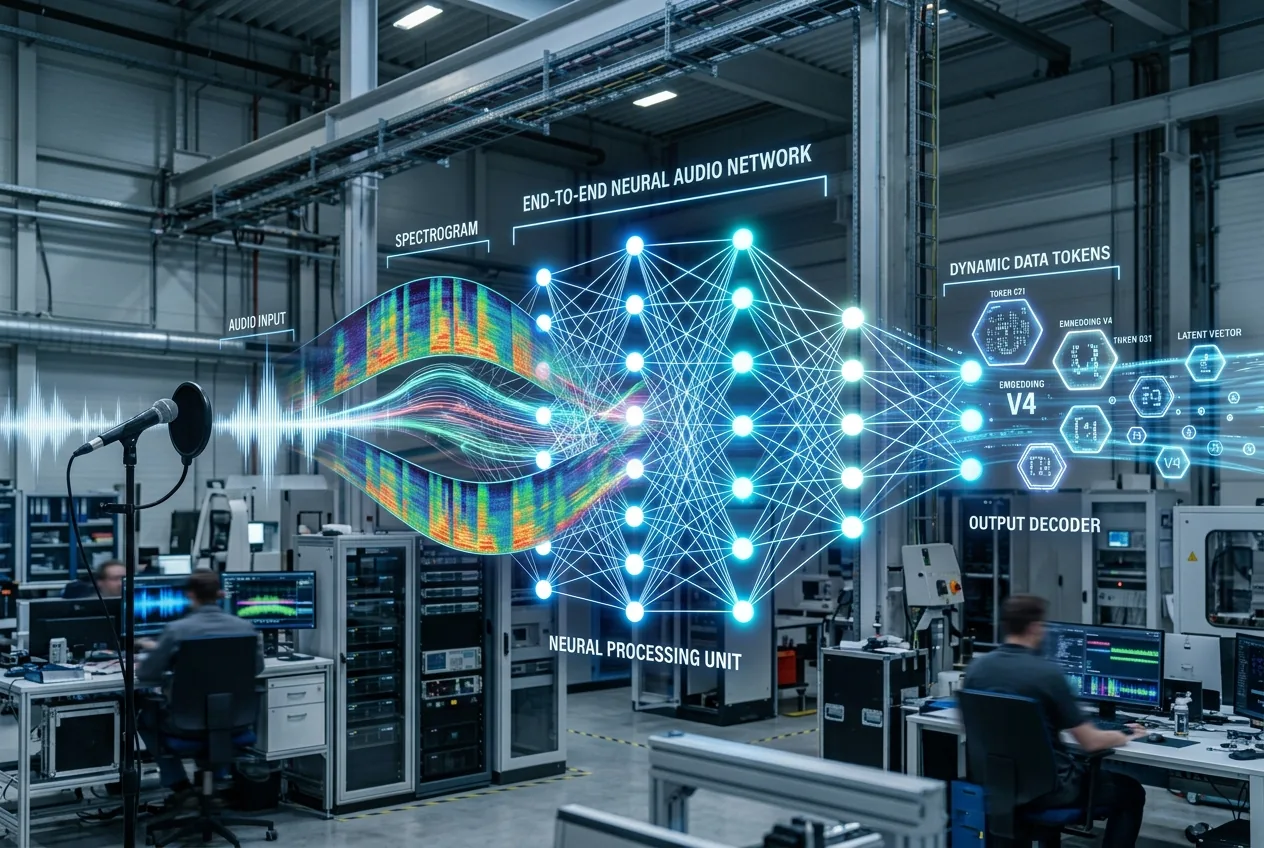
Mehr als ein Jahrzehnt lang folgte die Interaktion zwischen Mensch und computergestützten Sprachschnittstellen einem vorhersehbaren, abgehackten Rhythmus. Man sprach, wartete während einer unangenehmen mechanischen Stille und erhielt eine synthetisch aufbereitete Antwort. Diese Reibung war nicht nur ein ästhetisches Ärgernis, sondern die thermodynamische Realität verketteter Rechenarchitekturen. Herkömmliche Sprachassistenten arbeiteten über drei getrennte, isolierte Subsysteme: eine Spracherkennungs-Engine (ASR), um Audiowellenformen in Text zu transkribieren, ein Kern-Sprachmodell zur Verarbeitung und Generierung einer textuellen Antwort sowie eine Text-to-Speech-Engine (TTS), um die endgültige Antwort wieder in eine hörbare Wellenform umzuwandeln.
Der Latenz-Flaschenhals herkömmlicher Sprach-Kaskaden
Um zu verstehen, warum natives Sprach-Reasoning einen Wendepunkt darstellt, muss man die Latenzmathematik herkömmlicher Sprachsysteme betrachten. In einer klassischen Pipeline führt die ASR-Phase zu einem unvermeidlichen Sammelfenster. Das System muss eingehende Audio-Frames puffern, akustische und sprachliche Dekodierungsschritte durchführen und auf Interpunktionsmarker oder Algorithmen zur Erkennung des Satzendes warten, um sicherzustellen, dass der Benutzer aufgehört hat zu sprechen. Allein diese anfängliche Transkriptionsphase verbrauchte unter Standardnetzwerkbedingungen häufig zwischen 400 und 900 Millisekunden.
Die menschliche Konversationsdynamik bricht bei diesen Zeitabläufen völlig zusammen. Soziolinguistische Forschungen zeigen, dass natürliche menschliche Konversationen mit einer durchschnittlichen Sprecherwechselpause von etwa 200 bis 250 Millisekunden ablaufen. Wenn ein automatisiertes System mehr als eine halbe Sekunde Funkstille aufweist, registriert die menschliche Psychologie Zögern, Verwirrung oder ein Kommunikationsversagen. Durch die Zusammenführung der drei unterschiedlichen Phasen in einen einheitlichen End-to-End-Transformer konnte OpenAI nach eigenen Angaben die medianen Antwortlatenzen auf etwa 320 Millisekunden senken – was dem biologischen menschlichen Konversationstempo nahezu entspricht.
Akustisches Reasoning jenseits von Texttranskripten
Die Geschwindigkeitsvorteile von nativem Audio sind beeindruckend, aber der Sprung bei der kognitiven Leistungsfähigkeit ergibt sich aus dem, was verloren geht, wenn Sprache auf Text reduziert wird. Wenn ein ASR-System ein Audiosignal in ASCII-Zeichen umwandelt, werden große Mengen an Daten mit hoher Entropie entfernt. Ein Texttranskript kann weder das schnelle, flache Atmen eines Sprechers, noch stimmliche Zittrigkeit als Anzeichen von Stress, sarkastische Tonhöhenveränderungen oder die akustische Signatur schwerer Maschinen im Hintergrund kodieren.
In einem nativen, multimodalen End-to-End-Netzwerk werden Audiowellenformen direkt durch kontinuierliche oder diskrete akustische Repräsentationen tokenisiert – ähnlich wie bei neuronalen Audio-Codecs wie EnCodec oder SoundStream – und direkt in die Attention-Layer des Transformers eingespeist. Das Modell lernt gemeinsame Repräsentationen, bei denen linguistische Semantik und akustische Prosodie denselben latenten Raum teilen. Wenn ein Benutzer mit steigender Intonation spricht oder seine Lautstärke auf ein Flüstern senkt, benötigt das Modell kein explizites Metadaten-Tag, das ihm ein entsprechendes Verhalten vorschreibt; die Attention-Mechanismen gewichten diese akustischen Parameter bei der Generierung auf natürliche Weise.
Diese architektonische Änderung ermöglicht eine dynamische Echtzeit-Unterbrechung, in der Kommunikationstechnik oft als Vollduplex-Konversationsfluss oder „Barge-in“-Handling bezeichnet. Bei herkömmlichen Kaskaden-Pipelines erforderte eine Unterbrechung des Systems einen externen Sprachaktivitätsdetektor (VAD), um den ausgehenden TTS-Audiostrom abrupt zu unterbrechen, den LLM-Generierungspuffer zu leeren und die Zustandsmaschine zurückzusetzen. Bei der nativen multimodalen Verarbeitung verarbeitet das Netzwerk eingehende Audio-Token gleichzeitig, während es seine eigenen ausgehenden Token generiert. Wenn der eingehende akustische Strom anzeigt, dass der Benutzer dazwischengefunkt hat, passt das Modell seine internen Attention-Weights im laufenden Betrieb an, stoppt seine eigene Ausgabe oder ändert seinen verbalen Pfad innerhalb von Bruchteilen einer Silbe.
Inferenz-Ökonomie und Rechendichte
Das Erreichen von nativem Sprach-Reasoning erfordert tiefgreifende Kompromisse bei Rechenaufwand, Netzwerkbandbreite und der Nutzung der Speicherbandbreite. Während Text-Token diskrete, niederfrequente Repräsentationen menschlicher Sprache darstellen – etwa vier Zeichen pro Token –, erfordern Audiosignale deutlich höhere Token-Dichten, um die zeitliche Wiedergabetreue und phonetische Kohärenz zu bewahren. Der Betrieb eines Audio-Codecs mit 12 bis 24 Kilobit pro Sekunde ergibt einen kontinuierlichen Strom von zehn bis hundert diskreten Audio-Token pro Sekunde Sprache.
Die kontinuierliche autoregressive Generierung über Sequenzen mit einer derart hohen zeitlichen Auflösung stellt hohe Anforderungen an den High Bandwidth Memory (HBM) der GPU. Die Größen des Key-Value (KV)-Cache nehmen bei der Aufnahme hochfrequenter multimodaler Token rasch zu, was die gleichzeitige Sitzungsanzahl begrenzt, die ein einzelner Inferenzserver unterstützen kann. Für Unternehmensbetreiber und Cloud-Hyperscaler verschiebt dies das wirtschaftliche Kalkül: Das Angebot von nativer Audio-Inferenz ist aufgrund der pro Sekunde Live-Interaktion benötigten Gleitkommaoperationen (FLOPs) deutlich teurer als bei reinen Text-API-Endpunkten.
Darüber hinaus toleriert Echtzeit-Sprachstreaming praktisch kein Paket-Jitter. Bei der Textgenerierung tolerieren Benutzer eine burstartige Token-Zustellung; solange Wörter innerhalb eines angemessenen Zeitrahmens auf einem Bildschirm erscheinen, bleiben kleine Verzögerungen im Mikrosekundenbereich unbemerkt. Beim nativen Audio-Streaming führt jede Netzwerkstörung oder Verzögerung in der GPU-Warteschlange zu hörbaren Aussetzern, roboterhafter Verzerrung oder Pufferunterläufen. Um menschenähnliches Sprach-Reasoning im globalen Maßstab bereitzustellen, sind Edge-nahe Inferenz-Cluster, ultra-optimierte kontinuierliche Batching-Algorithmen und spezielle speculative Decoding-Techniken erforderlich, die speziell auf akustische Token-Ströme zugeschnitten sind.
Implikationen für industrielle Robotik und Feldeinsätze
Während verbraucherorientierte Konversationsagenten die öffentlichen Demonstrationen dominieren, liegt der wahre Nutzen von latenzarmem, akustisch fundiertem Reasoning in der industriellen Automatisierung, der Wartung vor Ort und der autonomen Robotik. In Fertigungsumgebungen oder logistischen Verteilzentren haben menschliche Bediener selten die Hände oder die visuelle Aufmerksamkeit frei, um mit Tastaturen, Tablets oder Touchscreens zu interagieren. Herkömmliche Sprachsteuerung in diesen Umgebungen scheiterte in der Vergangenheit, da Fabrikhallen akustische Minenfelder aus Umgebungsnachhall, Druckluftabgasen und dem Lärm motorisierter Transporte sind.
Ein End-to-End-Modell, das den akustischen Kontext der Umgebung versteht, kann zwischen einem Bediener, der einen dringenden Befehl über eine pneumatische Presse hinweg ruft, und einem Bediener, der sich beiläufig mit einem Kollegen in einem Meter Entfernung unterhält, unterscheiden. Da das Modell auditive Hinweise verarbeitet, könnte ein Techniker, der eine defekte Hydraulikpumpe diagnostiziert, ein Mikrofon in die Nähe des Ventilblocks halten und das System bitten, das mechanische Kavitationsgeräusch zu identifizieren, woraufhin er eine sofortige verbale Diagnose erhält, ohne Fehlercodes manuell transkribieren zu müssen.
Ähnlich verhält es sich bei kollaborativen Industrierobotern (Cobots): Der Wegfall der Konversationslatenz verändert den Sicherheitsrahmen. Ein Arbeiter, der einen mechanischen Arm mit hoher Nutzlast steuert, benötigt sofortiges Feedback. Wenn ein Befehl zum Anhalten oder zur Änderung der Flugbahn eine zweisekundenlange Pipeline-Verzögerung mit sich bringt, könnte der mechanische Betrieb bereits beeinträchtigt sein. Ein System, das stimmliche Hinweise nativ in Zeitfenstern von unter 300 Millisekunden verarbeitet, bringt natürliche Sprache in den Bereich deterministischer Steuerungsschnittstellen und schließt die Lücke zwischen biologischen Arbeitskräften und automatisierten schweren Maschinen.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!