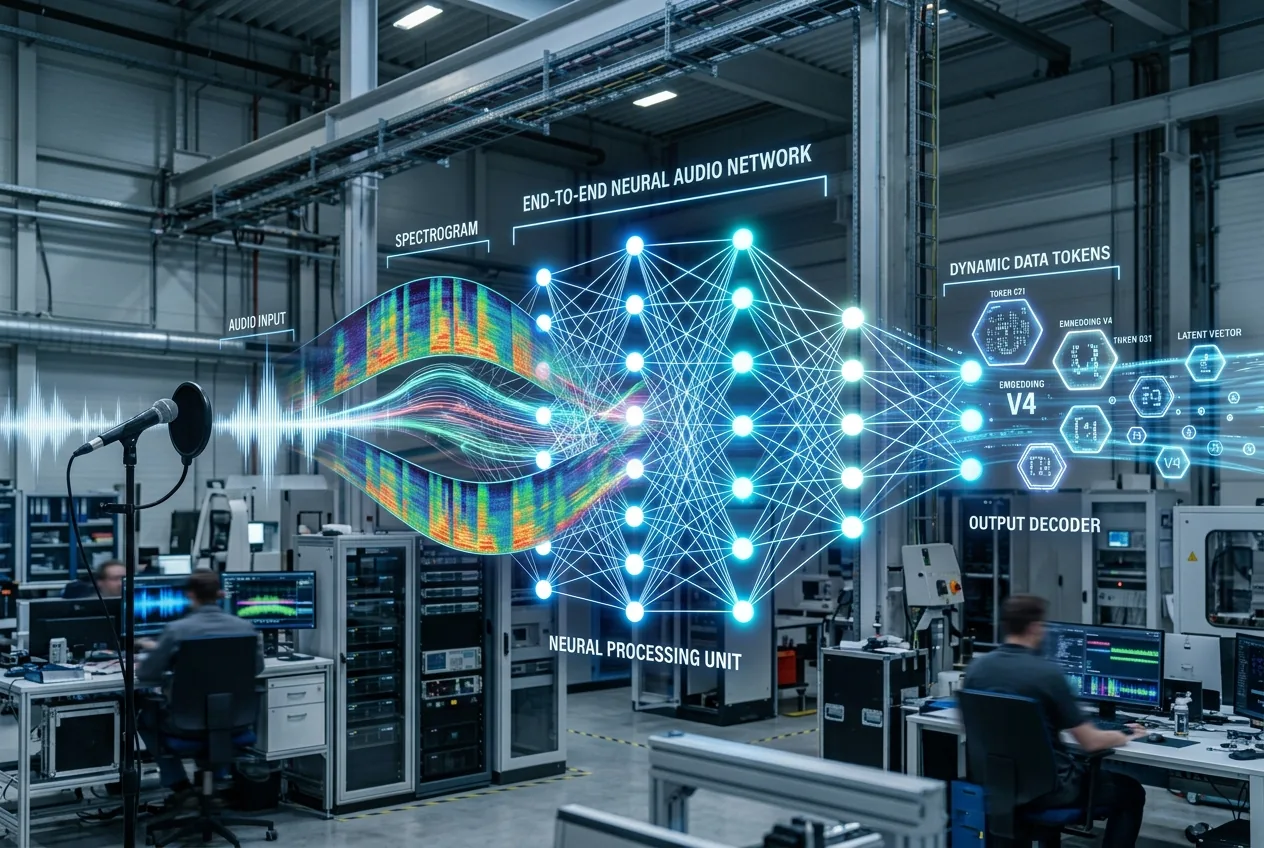
Per oltre un decennio, l'interazione umana con le interfacce vocali computerizzate ha seguito una cadenza prevedibile e frammentata. Si parlava, si attendeva attraverso un imbarazzante silenzio meccanico e si riceveva una risposta elaborata in modo sintetico. Tale attrito non era solo una scocciatura estetica; era la realtà termodinamica delle architetture computazionali a catena. Gli assistenti vocali tradizionali operavano attraverso tre sottosistemi distinti e isolati: un motore di riconoscimento automatico del parlato (ASR) per trascrivere le onde sonore in testo, un modello linguistico centrale per elaborare e generare una risposta testuale e un motore di sintesi vocale (TTS) per convertire la replica finale in un'onda sonora udibile.
Il collo di bottiglia della latenza nelle cascate vocali legacy
Per comprendere perché il ragionamento vocale nativo rappresenti un punto di svolta, occorre osservare la matematica della latenza dei sistemi vocali tradizionali. In una pipeline classica, lo stadio ASR introduce una finestra di raccolta inevitabile. Il sistema deve memorizzare i fotogrammi audio in arrivo, eseguire passaggi di decodifica acustica e linguistica e attendere marcatori di punteggiatura o algoritmi di fine frase per verificare che l'utente abbia smesso di parlare. Questa sola fase di trascrizione iniziale consumava spesso dai 400 ai 900 millisecondi in condizioni di rete standard.
Le dinamiche della conversazione umana si interrompono completamente su tali scale temporali. La ricerca sociolinguistica dimostra che una conversazione umana naturale opera con un divario medio tra i turni di circa 200-250 millisecondi. Quando un sistema automatizzato supera il mezzo secondo di silenzio, la psicologia umana registra esitazione, confusione o un fallimento comunicativo. Comprimendo i tre stadi distinti in un trasformatore end-to-end unificato, OpenAI ha riportato una latenza di risposta mediana scesa a circa 320 millisecondi, avvicinandosi alla parità con il ritmo conversazionale umano biologico.
Ragionamento acustico oltre le trascrizioni testuali
I guadagni di velocità dell'audio nativo sono impressionanti, ma il salto nella capacità cognitiva deriva da ciò che si perde quando il parlato viene ridotto a testo. Quando un sistema ASR converte un segnale audio in caratteri ASCII, elimina enormi quantità di dati ad alta entropia. Una trascrizione testuale non può codificare il respiro affannoso di un interlocutore, i tremori vocali che indicano stress, i cambiamenti di tono sarcastici o la firma acustica di macchinari pesanti in funzione sullo sfondo.
In una rete multimodale end-to-end nativa, le forme d'onda audio vengono tokenizzate direttamente attraverso rappresentazioni acustiche continue o discrete — simili ai codec audio neurali come EnCodec o SoundStream — e inserite direttamente nei livelli di attenzione del trasformatore. Il modello apprende rappresentazioni congiunte in cui la semantica linguistica e la prosodia acustica condividono lo stesso spazio latente. Quando un utente parla con un'intonazione ascendente o abbassa il volume fino a sussurrare, il modello non richiede un tag di metadati esplicito che gli indichi di comportarsi di conseguenza; i meccanismi di attenzione ponderano naturalmente tali parametri acustici durante la generazione.
Questo cambiamento architettonico abilita l'interruzione dinamica in tempo reale, spesso definita nell'ingegneria delle comunicazioni come flusso conversazionale full-duplex o gestione del barge-in. Nelle pipeline a cascata legacy, interrompere un sistema richiedeva un rilevatore di attività vocale (VAD) esterno per interrompere bruscamente il flusso audio TTS in uscita, svuotare il buffer di generazione dell'LLM e resettare la macchina a stati. Con l'elaborazione multimodale nativa, la rete elabora i token audio in arrivo simultaneamente mentre genera i propri token in uscita. Se il flusso acustico in entrata indica che l'utente è intervenuto, il modello regola al volo i propri pesi di attenzione interni, bloccando la propria emissione o deviando la propria traiettoria verbale nel giro di frazioni di sillaba.
Economia dell'inferenza e densità di calcolo
Raggiungere un ragionamento vocale nativo richiede profondi compromessi in termini di spesa computazionale, larghezza di banda della rete e utilizzo della larghezza di banda della memoria. Mentre i token testuali rappresentano rappresentazioni discrete e a bassa frequenza del linguaggio umano — circa quattro caratteri per token — i segnali audio richiedono densità di token significativamente più elevate per preservare la fedeltà temporale e la coerenza fonetica. Far funzionare un codec audio a 12-24 kilobit al secondo produce un flusso continuo di decine o centinaia di token audio discreti al secondo di parlato.
Eseguire una generazione autoregressiva continua su sequenze con una risoluzione temporale così elevata pone forti richieste alla memoria ad alta larghezza di banda (HBM) delle GPU. Le dimensioni della cache Key-Value (KV) si espandono rapidamente durante l'acquisizione di token multimodali ad alto tasso, limitando la concorrenza delle sessioni simultanee che un singolo server di inferenza può supportare. Per gli operatori aziendali e gli hyperscaler cloud, questo sposta il calcolo economico: servire l'inferenza audio nativa comporta un premio sostanziale rispetto agli endpoint API di solo testo, a causa delle operazioni in virgola mobile (FLOP) grezze richieste per ogni secondo di interazione dal vivo.
Inoltre, lo streaming vocale in tempo reale tollera praticamente zero jitter dei pacchetti. Nella generazione di testo, gli utenti tollerano un recapito dei token a raffica; finché le parole appaiono su uno schermo entro un lasso di tempo ragionevole, piccoli ritardi di pochi microsecondi passano inosservati. Nello streaming audio nativo, qualsiasi intoppo di rete o ritardo nella coda della GPU causa interruzioni udibili, distorsione robotica o buffer underrun. Fornire un ragionamento vocale simile a quello umano su scala globale richiede cluster di inferenza adiacenti all'edge, algoritmi di batching continuo ultra-ottimizzati e tecniche specializzate di decodifica speculativa adattate specificamente ai flussi di token acustici.
Implicazioni per la robotica industriale e le operazioni sul campo
Mentre gli agenti conversazionali rivolti ai consumatori dominano le dimostrazioni pubbliche, la vera utilità del ragionamento a bassa latenza e basato sull'acustica risiede nell'automazione industriale, nella manutenzione sul campo e nella robotica autonoma. Negli ambienti di produzione o nei centri di distribuzione logistica, gli operatori umani raramente hanno mani o attenzione visiva libere per interagire con tastiere, tablet o touchscreen. Il controllo vocale tradizionale in questi contesti ha fallito storicamente perché i piani di fabbrica sono campi minati acustici fatti di riverbero ambientale, scarichi di aria compressa e rumore del trasporto motorizzato.
Un modello end-to-end in grado di comprendere il contesto acustico ambientale può distinguere tra un operatore che grida un comando urgente sopra una pressa pneumatica e un operatore che confabula casualmente con un collega a un metro di distanza. Poiché il modello ragiona su segnali uditivi, un tecnico che diagnostica una pompa idraulica malfunzionante potrebbe tenere un microfono vicino al blocco valvole e chiedere al sistema di identificare il passo di cavitazione meccanica, ricevendo una diagnostica verbale immediata senza trascrivere manualmente i codici di errore.
Analogamente, per i robot industriali collaborativi (cobot), la rimozione della latenza conversazionale cambia l'involucro di sicurezza. Un lavoratore umano che dirige un braccio meccanico ad alto carico utile necessita di feedback istantaneo. Se un comando per mantenere la posizione o alterare una traiettoria subisce un ritardo di pipeline di due secondi, l'operazione meccanica potrebbe essere già compromessa. Un sistema che elabora segnali vocali nativamente in finestre inferiori ai 300 millisecondi porta il linguaggio naturale nel regno delle interfacce di controllo deterministiche, colmando il divario tra lavoratori biologici e macchinari pesanti automatizzati.



Comments
No comments yet. Be the first!