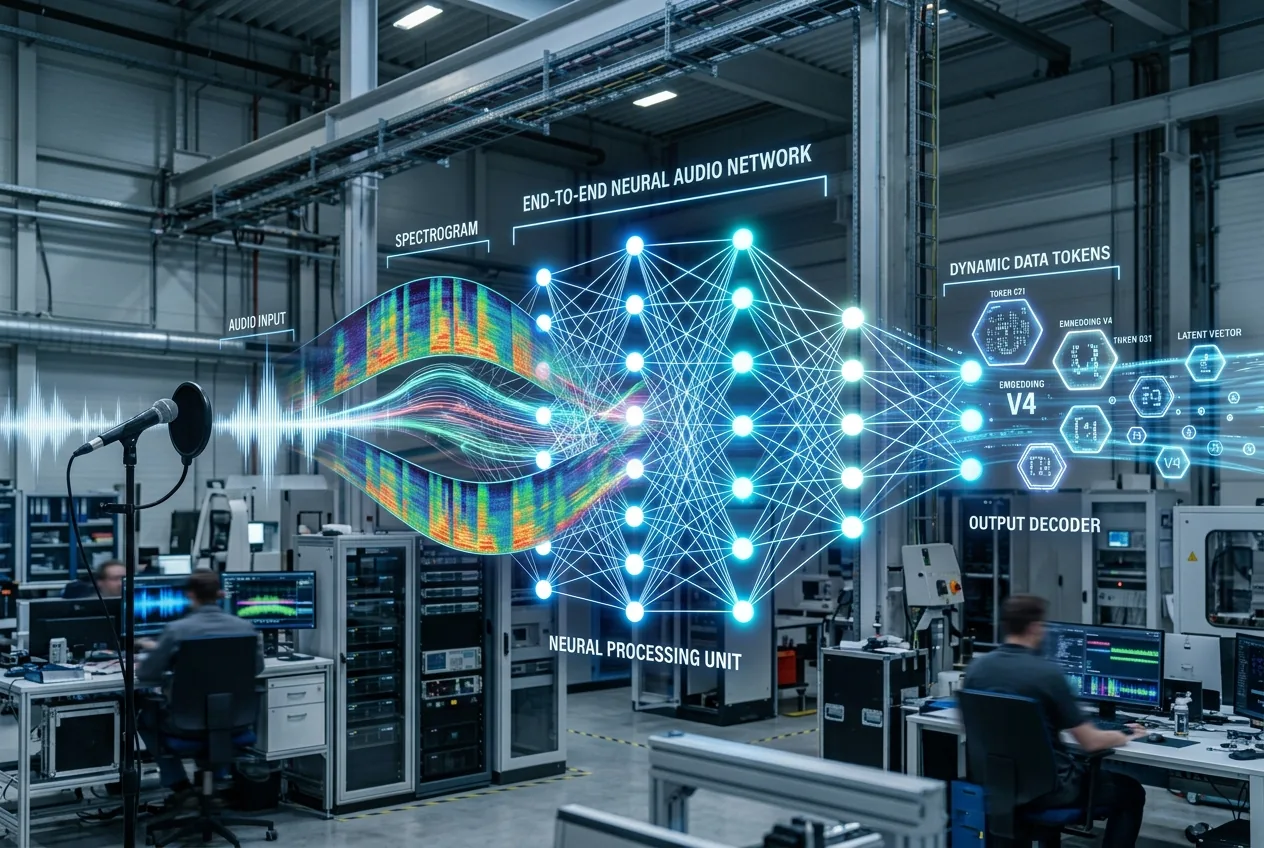
十多年来,人类与计算机语音界面的交互一直遵循着一种可预测且脱节的节奏。你说话,在尴尬的机械沉默中等待,然后收到一个经过合成处理的回答。这种摩擦不仅仅是美学上的不适;它是链式计算架构带来的热力学现实。传统的语音助手在三个相互独立且互不连通的子系统中运行:用于将音频波形转录为文本的自动语音识别(ASR)引擎、用于处理并生成文本回复的核心语言模型,以及用于将最终回复合成回可听波形的文本转语音(TTS)引擎。
传统语音级联的延迟瓶颈
要理解为何原生语音推理代表了一个转折点,就必须审视传统语音系统的延迟计算。在经典的流水线中,ASR 阶段引入了不可避免的收集窗口。系统必须缓冲输入的音频帧、运行声学和语言解码过程,并等待标点符号标记或端点检测算法来确认用户已停止说话。仅在标准网络条件下,这个初始转录阶段通常就会消耗 400 到 900 毫秒的时间。
在这种时间尺度下,人类的对话动态会彻底崩溃。社会语言学研究表明,自然人类对话的平均轮次间隙大约为 200 到 250 毫秒。当自动系统出现超过半秒的静音时,人类心理会产生迟疑、困惑或沟通失败的感觉。通过将这三个独立的阶段压缩为一个统一的端到端 Transformer 模型,OpenAI 报告称中位响应延迟降至约 320 毫秒,接近人类生物学对话节奏的水平。
超越文本转录的声学推理
原生语音带来的速度提升固然令人印象深刻,但认知能力的飞跃源于语音在简化为文本时所丢失的信息。当 ASR 系统将音频信号转换为 ASCII 字符时,它剔除了大量高熵数据。文本转录无法编码说话者快速的浅呼吸、暗示压力的声音震颤、讽刺的语调变化,或者背景中重型机械运作的声学特征。
在原生的端到端多模态网络中,音频波形通过连续或离散的声学表示(类似于 EnCodec 或 SoundStream 等神经音频编解码器)直接进行标记化,并直接馈送到 Transformer 的注意力层中。模型学习的是语言语义和声学韵律共享同一潜在空间的联合表示。当用户以上扬的语调说话或压低音量耳语时,模型不需要明确的元数据标签来指示其做出相应行为;注意力机制会在生成过程中自然地对这些声学参数进行加权。
这种架构改变实现了实时动态打断,这在通信工程中通常被称为全双工对话流或“插话”(barge-in)处理。在传统的级联流水线中,打断系统需要外部的语音活动检测器(VAD)来突然切断外发的 TTS 音频流、清除 LLM 生成缓冲区并重置状态机。通过原生多模态处理,网络在生成自身外发标记的同时,会同步处理输入的音频标记。如果输入的声学流表明用户进行了插话,模型会实时调整其内部注意力权重,从而在几分之一音节内停止自身的输出或改变其语言轨迹。
推理经济学与计算密度
实现原生语音推理需要在计算支出、网络带宽和内存带宽利用率方面做出深刻的权衡。虽然文本标记代表了人类语言的离散、低频表示(每个标记约四个字符),但音频信号需要显著更高的标记密度来保持时间保真度和语音连贯性。以每秒 12 到 24 千比特的速度运行音频编解码器,每秒语音会产生数十或数百个离散音频标记。
在具有如此高时间分辨率的序列上运行连续自回归生成,对 GPU 高带宽内存(HBM)提出了严苛要求。在摄入高频多模态标记时,键值(KV)缓存大小会迅速膨胀,从而限制了单个推理服务器所能支持的并发会话数。对于企业运营商和云超大规模服务商而言,这改变了经济计算方式:由于每秒实时交互所需的原始浮点运算(FLOPs)量增加,提供原生语音推理服务的成本远高于仅提供文本 API 端点。
此外,实时语音流对于网络抖动的容忍度几乎为零。在文本生成中,用户可以容忍突发性的标记传递;只要文字能在合理的时间内出现在屏幕上,微秒级的延迟几乎不会被察觉。在原生音频流传输中,任何网络故障或 GPU 排队延迟都会导致可听到的掉帧、机器人式的失真或缓冲区欠载。在全球范围内提供类人语音推理,需要边缘附近的推理集群、超优化的连续批处理算法,以及专门针对声学标记流定制的专门投机解码技术。
对工业机器人与现场作业的启示
尽管面向消费者的对话代理主导了公开演示,但低延迟、基于声学基础的推理的真正效用在于工业自动化、现场维护和自主机器人技术。在制造业环境或物流配送中心,操作人员很少有空余的双手或视觉注意力来与键盘、平板电脑或触摸屏交互。在这些场景中,传统的语音控制历来都是失败的,因为工厂车间是充满了环境混响、压缩空气排气和机动交通噪音的声学雷场。
一种能够理解环境声学语境的端到端模型,可以区分操作员在气动压力机旁大声喊出的紧急指令,以及操作员与三英尺外的同事闲聊的声音。由于模型是对听觉线索进行推理,诊断液压泵故障的技术人员可以将麦克风靠近阀组,要求系统识别机械气蚀音,从而在无需手动转录故障代码的情况下获得即时的口头诊断结果。
同样,对于协作机器人(cobots),消除对话延迟改变了安全范畴。指挥高负载机械臂的人类工人需要即时的反馈。如果保持位置或改变轨迹的指令产生两秒的流水线延迟,机械操作可能已经受到影响。一种在 300 毫秒以下窗口内原生处理语音线索的系统,将自然语言带入了确定性控制接口的范畴,弥合了生物工人与自动化重型机械之间的鸿沟。



Comments
No comments yet. Be the first!