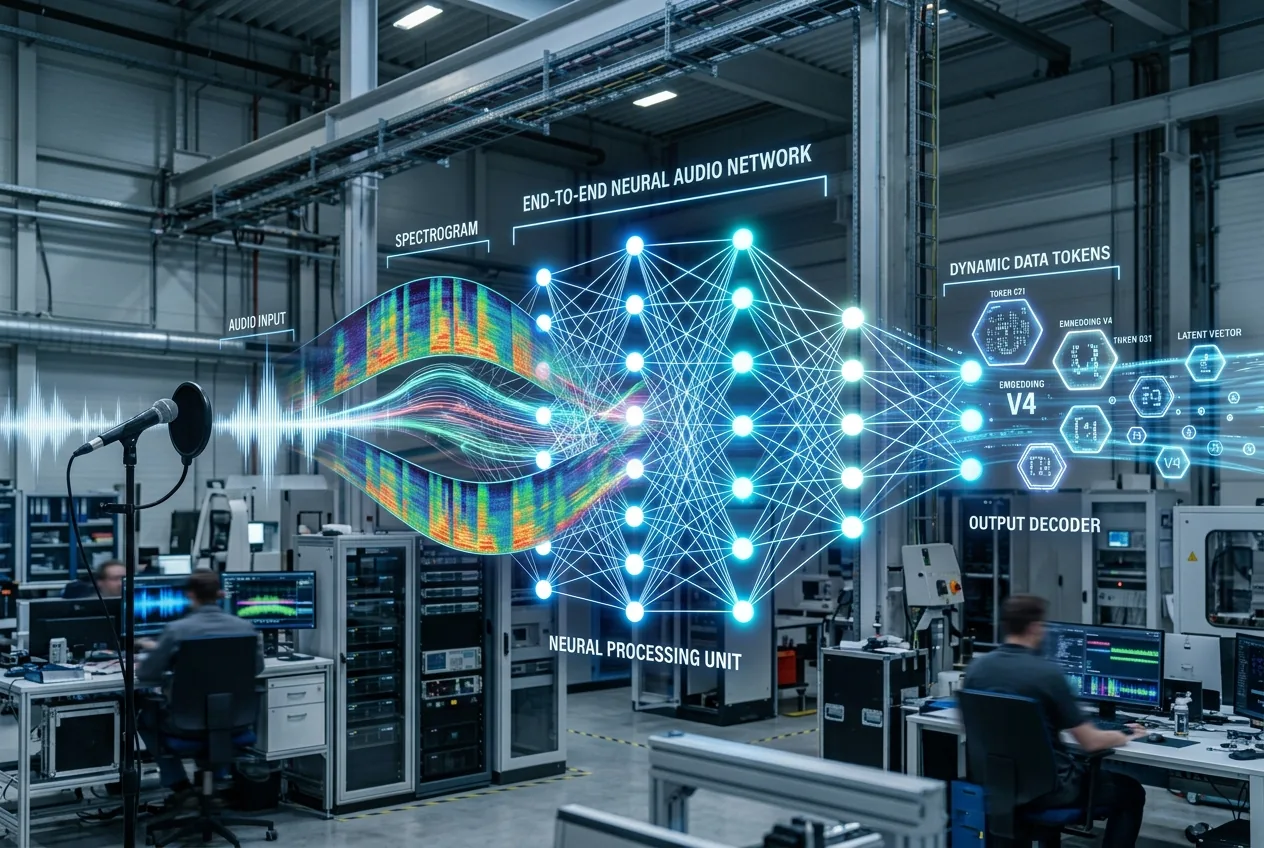
Durante más de una década, la interacción humana con interfaces de voz computarizadas siguió una cadencia predecible y entrecortada. Usted hablaba, esperaba a través de un incómodo silencio mecánico y recibía una respuesta sintéticamente procesada. Esa fricción no era simplemente una molestia estética; era la realidad termodinámica de las arquitecturas computacionales encadenadas. Los asistentes de voz tradicionales operaban a través de tres subsistemas distintos y aislados: un motor de reconocimiento automático de voz (ASR, por sus siglas en inglés) para transcribir formas de onda de audio a texto, un modelo de lenguaje central para procesar y generar una respuesta textual, y un motor de conversión de texto a voz (TTS) para sintetizar la respuesta final en una forma de onda audible.
El cuello de botella de latencia de las cascadas de voz heredadas
Para entender por qué el razonamiento de voz nativo representa un punto de inflexión, uno debe observar la matemática de latencia de los sistemas de voz heredados. En una tubería clásica, la etapa de ASR introduce una ventana de recopilación inevitable. El sistema debe almacenar en búfer los marcos de audio entrantes, ejecutar pases de decodificación acústica y de lenguaje, y esperar marcadores de puntuación o algoritmos de detección de fin de habla para verificar que el usuario ha dejado de hablar. Esta fase de transcripción inicial por sí sola consumía frecuentemente entre 400 y 900 milisegundos bajo condiciones de red estándar.
Las dinámicas de conversación humana se desmoronan por completo en esas escalas de tiempo. La investigación sociolingüística demuestra que la conversación humana natural opera con una brecha inter-turno promedio de aproximadamente 200 a 250 milisegundos. Cuando un sistema automatizado excede medio segundo de silencio, la psicología humana registra dudas, confusión o una falla en la comunicación. Al colapsar las tres etapas distintas en un transformador integral de extremo a extremo, OpenAI informó que las latencias de respuesta medianas cayeron a aproximadamente 320 milisegundos, acercándose a la paridad con el ritmo conversacional humano biológico.
Razonamiento acústico más allá de las transcripciones de texto
Las ganancias de velocidad del audio nativo son impresionantes, pero el salto en capacidad cognitiva proviene de lo que se pierde cuando el habla se reduce a texto. Cuando un sistema ASR convierte una señal de audio en caracteres ASCII, elimina grandes cantidades de datos de alta entropía. Una transcripción de texto no puede codificar la respiración rápida y superficial de un hablante, los temblores vocales que indican estrés, los cambios de tono sarcásticos o la firma acústica de maquinaria pesada operando de fondo.
En una red multimodal nativa de extremo a extremo, las formas de onda de audio se tokenizan directamente a través de representaciones acústicas continuas o discretas —similar a los códecs de audio neuronales como EnCodec o SoundStream— y se alimentan directamente a las capas de atención del transformador. El modelo aprende representaciones conjuntas donde la semántica lingüística y la prosodia acústica comparten exactamente el mismo espacio latente. Cuando un usuario habla con entonación ascendente o baja su volumen a un susurro, el modelo no requiere una etiqueta de metadatos explícita que le indique comportarse en consecuencia; los mecanismos de atención ponderan naturalmente esos parámetros acústicos durante la generación.
Este cambio arquitectónico permite la interrupción dinámica en tiempo real, a menudo denominada en ingeniería de comunicaciones como flujo conversacional dúplex completo o manejo de "barge-in". En las tuberías de cascada heredadas, interrumpir un sistema requería un detector de actividad de voz (VAD) externo para cortar abruptamente el flujo de audio TTS de salida, purgar el búfer de generación del LLM y restablecer la máquina de estados. Con el procesamiento multimodal nativo, la red procesa los tokens de audio entrantes simultáneamente mientras genera sus propios tokens de salida. Si el flujo acústico entrante indica que el usuario ha intervenido, el modelo ajusta sus pesos de atención internos sobre la marcha, deteniendo su propia salida o cambiando su trayectoria verbal en fracciones de sílaba.
Economía de inferencia y densidad de cómputo
Lograr un razonamiento de voz nativo requiere profundas compensaciones en gasto de cómputo, ancho de banda de red y utilización de ancho de banda de memoria. Mientras que los tokens de texto representan representaciones discretas de baja frecuencia del lenguaje humano —aproximadamente cuatro caracteres por token—, las señales de audio requieren densidades de token significativamente más altas para preservar la fidelidad temporal y la coherencia fonética. Operar un códec de audio a 12 a 24 kilobits por segundo produce un flujo continuo de decenas o cientos de tokens de audio discretos por segundo de habla.
Ejecutar una generación autorregresiva continua sobre secuencias con tal resolución temporal impone severas demandas a la memoria de alto ancho de banda (HBM) de la GPU. Los tamaños de caché Clave-Valor (KV) se expanden rápidamente al ingerir tokens multimodales de alta tasa, lo que limita la concurrencia de sesiones simultáneas que un servidor de inferencia individual puede soportar. Para los operadores empresariales y los hiperescaladores de la nube, esto cambia el cálculo económico: servir inferencia de audio nativa conlleva una prima sustancial sobre los puntos finales de API solo de texto debido a las operaciones de punto flotante (FLOPs) brutas requeridas por segundo de interacción en vivo.
Además, la transmisión de voz en tiempo real tolera prácticamente cero fluctuación de paquetes (jitter). En la generación de texto, los usuarios toleran la entrega de tokens por ráfagas; siempre que las palabras aparezcan en una pantalla dentro de un plazo razonable, las pequeñas pausas de microsegundos pasan desapercibidas. En la transmisión de audio nativa, cualquier hipo de red o retraso en la cola de la GPU causa cortes audibles, distorsión robótica o subdesbordamientos de búfer. Entregar un razonamiento de voz similar al humano a escala global requiere clústeres de inferencia adyacentes al borde, algoritmos de procesamiento por lotes continuos ultra-optimizados y técnicas de decodificación especulativa especializadas adaptadas específicamente a los flujos de tokens acústicos.
Implicaciones para la robótica industrial y las operaciones de campo
Si bien los agentes conversacionales orientados al consumidor dominan las demostraciones públicas, la verdadera utilidad del razonamiento de baja latencia y fundamentado acústicamente reside en la automatización industrial, el mantenimiento de campo y la robótica autónoma. En entornos de fabricación o centros de distribución logística, los operadores humanos rara vez tienen sus manos o su atención visual libre para interactuar con teclados, tabletas o pantallas táctiles. El control de voz tradicional en estos entornos falló históricamente porque las plantas de fábrica son campos minados acústicos de reverberación ambiental, escapes de aire comprimido y ruido de transporte motorizado.
Un modelo de extremo a extremo capaz de comprender el contexto acústico ambiental puede distinguir entre un operador que grita una orden urgente sobre una prensa neumática y un operador que habla casualmente con un colega a un metro de distancia. Debido a que el modelo razona sobre señales auditivas, un técnico que diagnostica una bomba hidráulica defectuosa podría sostener un micrófono cerca del bloque de válvulas y pedirle al sistema que identifique el tono de cavitación mecánica, recibiendo un diagnóstico verbal inmediato sin transcribir manualmente los códigos de falla.
Del mismo modo, para los robots industriales colaborativos (cobots), la eliminación de la latencia conversacional cambia el marco de seguridad. Un trabajador humano que dirige un brazo mecánico de alta carga útil necesita retroalimentación instantánea. Si una orden para mantener la posición o alterar una trayectoria incurre en un retraso de tubería de dos segundos, la operación mecánica puede verse comprometida. Un sistema que procesa señales vocales de forma nativa en ventanas inferiores a 300 milisegundos lleva el habla natural al ámbito de las interfaces de control deterministas, cerrando la brecha entre los trabajadores biológicos y la maquinaria pesada automatizada.



Comments
No comments yet. Be the first!