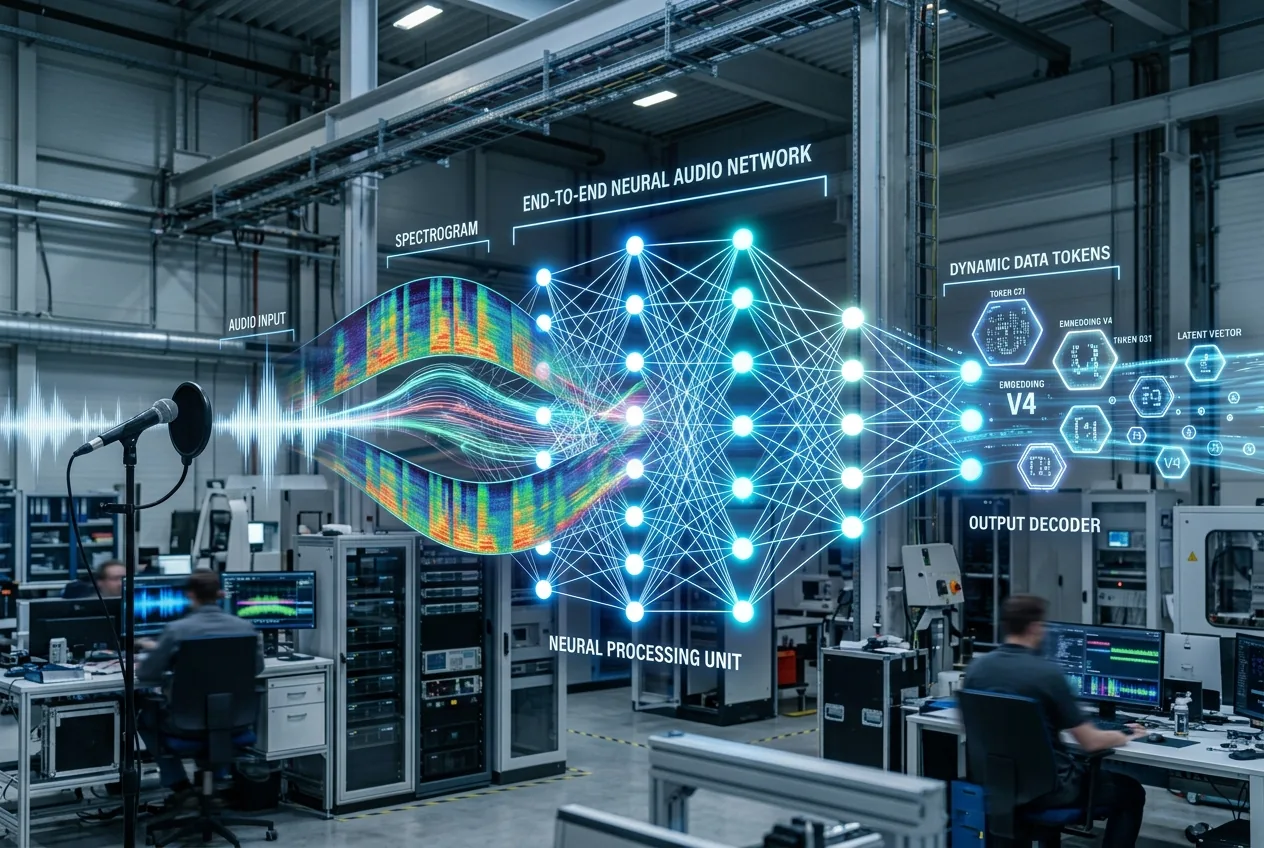
Pendant plus d'une décennie, l'interaction humaine avec les interfaces vocales informatisées a suivi une cadence prévisible et saccadée. Vous parliez, attendiez dans un silence mécanique gênant, et receviez une réponse synthétiquement formatée. Cette friction n'était pas seulement une nuisance esthétique ; c'était la réalité thermodynamique des architectures informatiques enchaînées. Les assistants vocaux traditionnels fonctionnaient via trois sous-systèmes distincts et cloisonnés : un moteur de reconnaissance automatique de la parole (ASR) pour transcrire les formes d'onde audio en texte, un modèle de langage central pour traiter et générer une réponse textuelle, et un moteur de synthèse vocale (TTS) pour convertir la réponse finale en une forme d'onde audible.
Le goulot d'étranglement de la latence dans les systèmes vocaux classiques
Pour comprendre pourquoi le raisonnement vocal natif représente un tournant, il faut examiner le calcul de la latence des systèmes vocaux hérités. Dans un pipeline classique, l'étape ASR introduit une fenêtre de collecte inévitable. Le système doit mettre en tampon les trames audio entrantes, effectuer des passes de décodage acoustique et linguistique, et attendre des marqueurs de ponctuation ou des algorithmes de fin de parole pour vérifier que l'utilisateur a cessé de parler. Cette phase initiale de transcription consommait seule, dans des conditions réseau standard, entre 400 et 900 millisecondes.
La dynamique de la conversation humaine s'effondre totalement à ces échelles de temps. La recherche sociolinguistique démontre que la conversation humaine naturelle fonctionne avec un intervalle moyen entre les tours de parole d'environ 200 à 250 millisecondes. Lorsqu'un système automatisé dépasse une demi-seconde de silence, la psychologie humaine enregistre une hésitation, une confusion ou une rupture de communication. En fusionnant les trois étapes distinctes en un transformeur unifié de bout en bout, OpenAI a rapporté que les latences de réponse médianes sont tombées à environ 320 millisecondes, se rapprochant de la parité avec le rythme conversationnel biologique humain.
Raisonnement acoustique au-delà des transcriptions textuelles
Les gains de vitesse de l'audio natif sont impressionnants, mais le bond en capacité cognitive provient de ce qui est perdu lorsque la parole est réduite à du texte. Lorsqu'un système ASR convertit un signal audio en caractères ASCII, il élimine une grande quantité de données à haute entropie. Une transcription textuelle ne peut pas encoder la respiration courte et rapide d'un locuteur, les tremblements vocaux indiquant le stress, les changements de ton sarcastiques ou la signature acoustique d'une machinerie lourde fonctionnant en arrière-plan.
Dans un réseau multimodal natif de bout en bout, les formes d'onde audio sont tokenisées directement via des représentations acoustiques continues ou discrètes — similaires aux codecs audio neuronaux comme EnCodec ou SoundStream — et injectées directement dans les couches d'attention du transformeur. Le modèle apprend des représentations conjointes où la sémantique linguistique et la prosodie acoustique partagent exactement le même espace latent. Lorsqu'un utilisateur parle avec une intonation montante ou baisse le volume pour chuchoter, le modèle n'a pas besoin d'une balise de métadonnées explicite lui ordonnant de se comporter en conséquence ; les mécanismes d'attention pondèrent naturellement ces paramètres acoustiques lors de la génération.
Ce changement architectural permet l'interruption dynamique en temps réel, souvent appelée en ingénierie des communications flux conversationnel en duplex intégral ou gestion d'intrusion (barge-in). Dans les pipelines en cascade classiques, interrompre un système nécessitait un détecteur d'activité vocale (VAD) externe pour couper brutalement le flux audio TTS sortant, purger le tampon de génération du LLM et réinitialiser la machine à états. Avec le traitement multimodal natif, le réseau traite les jetons audio entrants simultanément tout en générant ses propres jetons sortants. Si le flux acoustique entrant indique que l'utilisateur est intervenu, le modèle ajuste ses poids d'attention internes à la volée, interrompant sa propre sortie ou pivotant sa trajectoire verbale en une fraction de syllabe.
Économie de l'inférence et densité de calcul
Parvenir à un raisonnement vocal natif nécessite des compromis profonds en termes de dépenses de calcul, de bande passante réseau et d'utilisation de la bande passante mémoire. Alors que les jetons textuels représentent des représentations discrètes et basse fréquence du langage humain — environ quatre caractères par jeton — les signaux audio nécessitent des densités de jetons nettement plus élevées pour préserver la fidélité temporelle et la cohérence phonétique. L'exploitation d'un codec audio à 12 ou 24 kilobits par seconde génère un flux continu de dizaines ou de centaines de jetons audio discrets par seconde de parole.
Exécuter une génération autorégressive continue sur des séquences avec une telle résolution temporelle impose des exigences sévères à la mémoire haute bande passante (HBM) des GPU. La taille du cache clé-valeur (KV) augmente rapidement lors de l'ingestion de jetons multimodaux à haut débit, limitant la concurrence de sessions simultanées qu'un serveur d'inférence individuel peut supporter. Pour les opérateurs d'entreprise et les fournisseurs de cloud, cela modifie le calcul économique : servir une inférence audio native coûte nettement plus cher que les points de terminaison d'API textuels en raison des opérations en virgule flottante (FLOPs) brutes requises par seconde d'interaction en direct.
De plus, le streaming vocal en temps réel ne tolère pratiquement aucune gigue de paquet. Dans la génération de texte, les utilisateurs tolèrent une livraison de jetons par rafales ; tant que les mots apparaissent sur un écran dans un délai raisonnable, les micro-pauses de quelques microsecondes passent inaperçues. Dans le streaming audio natif, tout hoquet réseau ou retard de mise en file d'attente du GPU provoque des pertes audibles, une distorsion robotique ou des sous-dépassements de tampon (buffer underruns). Fournir un raisonnement vocal de type humain à l'échelle mondiale nécessite des clusters d'inférence proches de la périphérie (edge), des algorithmes de mise en lots continue ultra-optimisés et des techniques de décodage spéculatif spécialisées, adaptées spécifiquement aux flux de jetons acoustiques.
Implications pour la robotique industrielle et les opérations sur le terrain
Alors que les agents conversationnels destinés au grand public dominent les démonstrations, la véritable utilité d'un raisonnement à faible latence et ancré acoustiquement réside dans l'automatisation industrielle, la maintenance sur le terrain et la robotique autonome. Dans les environnements de fabrication ou les centres de distribution logistique, les opérateurs humains ont rarement les mains libres ou l'attention visuelle disponible pour interagir avec des claviers, des tablettes ou des écrans tactiles. Le contrôle vocal traditionnel a échoué historiquement dans ces contextes car les ateliers sont des champs de mines acoustiques remplis de réverbération ambiante, d'échappements d'air comprimé et de bruits de transport motorisé.
Un modèle de bout en bout capable de comprendre le contexte acoustique environnemental peut distinguer un opérateur criant un ordre urgent près d'une presse pneumatique d'un opérateur discutant avec un collègue à un mètre de distance. Parce que le modèle raisonne sur des indices auditifs, un technicien diagnostiquant une pompe hydraulique défectueuse pourrait tenir un microphone près du bloc de vannes et demander au système d'identifier le bruit de cavitation mécanique, recevant un diagnostic verbal immédiat sans transcrire manuellement les codes d'erreur.
De même, pour les robots industriels collaboratifs (cobots), la suppression de la latence conversationnelle modifie l'enveloppe de sécurité. Un travailleur humain dirigeant un bras mécanique à forte charge a besoin d'un retour instantané. Si un ordre de maintien de position ou de modification de trajectoire subit un délai de pipeline de deux secondes, l'opération mécanique peut déjà être compromise. Un système qui traite les indices vocaux nativement dans des fenêtres inférieures à 300 millisecondes fait entrer la parole naturelle dans le domaine des interfaces de contrôle déterministes, comblant le fossé entre les travailleurs biologiques et les machines lourdes automatisées.



Comments
No comments yet. Be the first!