Eine Flut technischer Dokumentationen und Branchenberichte, die auf die chinesische Tech-Publikation 36Kr zurückgehen, hat eine weitreichende Debatte in der Machine-Learning-Community ausgelöst. Im Zentrum der Enthüllungen steht eine fortschrittliche Frontier-Modell-Linie, die intern als GPT-6 Astra bezeichnet wird. Während Frontier-Labore ihre Trainingsmeilensteine bisher streng geheim gehalten haben, deuten die geleakten Unterlagen auf einen beispiellosen Sprung in den Fähigkeiten hin: eine nahezu vollständige Sättigung der Leistung in bestehenden Evaluierungskatalogen für Künstliche Allgemeine Intelligenz (AGI), darunter das Abstraction and Reasoning Corpus (ARC-AGI), GPQA Diamond und anspruchsvolle Benchmarks für kontinuierliche Software-Engineering-Agenten.
Für Ingenieure und industrielle Technologen müssen Behauptungen über nahezu perfekte Ergebnisse bei kognitiven Benchmarks einer genauen Prüfung unterzogen werden. Historisch gesehen wiesen Sprachmodelle ungleichmäßige Fähigkeitsprofile auf: Sie beherrschten komplexe sprachliche Synthesen, scheiterten jedoch an grundlegendem räumlichen Denken oder mehrstufiger deterministischer Logik. Sollten die mit der Astra-Architektur verbundenen Metriken einer formellen Peer-Review standhalten, markiert der zugrunde liegende Mechanismus eine Abkehr von konventionellen autoregressiven Skalierungsgesetzen und deutet auf eine tiefgreifende Zuweisung von Rechenleistung zur Inferenzzeit sowie auf eine autonome algorithmische Suche hin.
Die Anatomie der Benchmark-Sättigung
Ähnlich verhält es sich mit den Leistungszahlen des GPQA-Diamond-Benchmarks – einer Sammlung von Fragen auf dem Niveau von Hochschulabschlüssen in Physik, Chemie und Biologie, die explizit darauf ausgelegt ist, automatisierten Retrieval-Angriffen standzuhalten – die Berichten zufolge eine Genauigkeit von nahezu 96 Prozent erreichen. In typischen akademischen Umgebungen erzielen promovierte Menschen bei diesen Fragen ohne Zugriff auf externe Web-Tools eine Genauigkeit von etwa 65 Prozent. Dieser Sprung legt nahe, dass Astra nicht nur als hochdichte Wissensdatenbank fungiert, sondern strukturierte Deduktion über interdisziplinäre Domänen hinweg mit einer Fehlerrate ausführt, die sich den Standard-Gleitkomma-Verifizierungsschwellen nähert.
Jenseits von geschlossenen Prüfungen verweisen die Engineering-Telemetriedaten auf SWE-bench Verified Benchmarks mit einer autonomen Aufgabenbewältigung von über 85 Prozent. Diese Metrik erfasst die Fähigkeit eines Modells, eine gesamte bestehende Codebasis aufzunehmen, ein in einem rohen menschlichen Fehlerbericht beschriebenes Problem zu reproduzieren, einen effektiven Patch zu schreiben und Unit-Tests ohne menschliches Eingreifen zu bestehen. Das Erreichen dieser Zuverlässigkeit in diesem Umfang deutet auf eine Architektur hin, die in der Lage ist, Langzeit-Kontextfenster aufrechtzuerhalten, ohne unter dem Zerfall der Aufmerksamkeit zu leiden, der bei autonomen Multi-Turn-Systemen lange Zeit ein Problem darstellte.
Der Wandel des Antriebs: Von der Aufnahme zur Verifikation
Die entscheidende technische Frage ist, wie eine Architektur diese Leistungsschwellen erreicht, wenn das Brute-Force-Pretraining auf Web-Skala weitgehend an ökonomische und datenverfügbarkeitsbedingte Grenzen gestoßen ist. Der Konsens der Branche und die architektonischen Hinweise in den Berichten deuten darauf hin, dass Astra sich nicht allein auf eine erweiterte Parameteranzahl verlässt. Stattdessen spiegelt der Durchbruch eine aggressive Einführung von Inferenzzeit-Suche, „Tree-of-Thought“-Exploration und durch formale Verifizierer gesteuertes verstärkendes Lernen wider.
Dieser architektonische Wandel spiegelt den evolutionären Pfad wider, der bei spezialisierten Systemen wie AlphaZero zu beobachten war, verallgemeinert diesen jedoch über beliebige formale und semi-formale Sprachen hinweg. Anstatt lediglich die Gewichte neuronaler Netze zu skalieren, behandeln Ingenieure das Denken als Online-Optimierungsproblem. Indem das System während der Abfrage eine um Größenordnungen höhere Rechenleistung für die Generierung und Verifizierung einer Lösung aufwendet, ahmt es effektiv die deliberativen, systematischen Problemlösungsmethoden menschlicher Fachspezialisten nach.
Die thermodynamischen und ökonomischen Kosten des Denkens
Während theoretische Benchmark-Ergebnisse eine beispiellose intellektuelle Leistungsfähigkeit aufzeigen, bringt der Einsatz einer Inferenz-lastigen Architektur enorme operative Reibungsverluste mit sich. In einem konventionellen Cloud-Infrastrukturmodell erfordert die Bedienung eines Unternehmenskunden mit Standard-Transformer-Inferenz eine vorhersehbare Energieverteilung im Megawattbereich und eine handhabbare Netzwerklatenz. Systeme, die auf ausgedehnten Inferenz-Suchbäumen basieren, kehren diese ökonomischen Annahmen jedoch vollständig um.
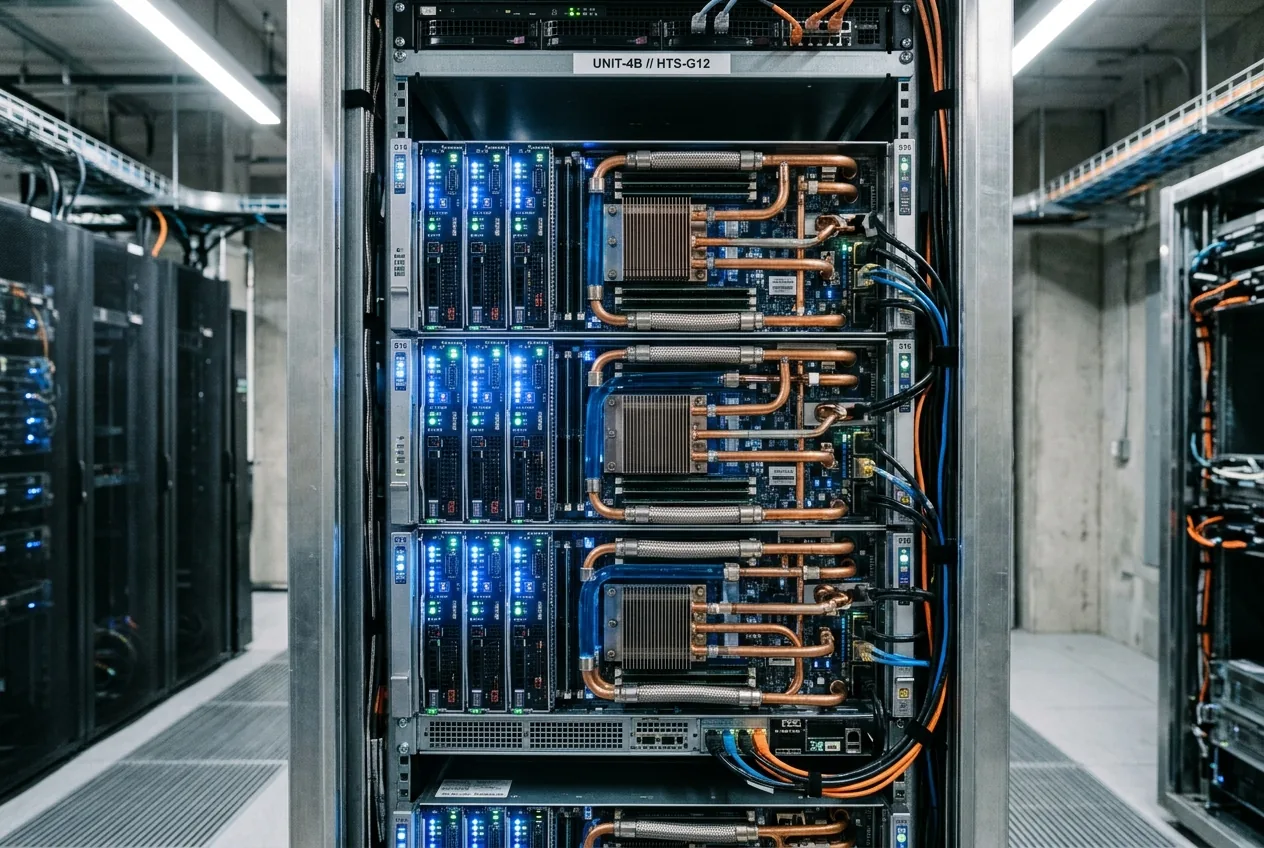
Das Generieren hunderter Kandidaten-Token, das Ausführen interner Reflexionsmodelle und die Schnittstellenbildung zu Verifizierungs-Sandboxes erhöhen die Energiekosten pro Abfrage drastisch. Eine einzige komplexe logische Aufgabe könnte tausendmal mehr Rechenzyklen verbrauchen als ein einfacher informativer Prompt. Für Hyperscaler und Industriebetreiber verschiebt dies den operativen Engpass von der Halbleiterfertigung direkt hin zu Stromnetzkapazitäten, Effizienz der Flüssigkeitskühlung und thermischen Limits lokaler Rechenzentren.
Die Distanz zwischen digitalen Metriken und physischer Realität
Für diejenigen, die die Schnittstelle zwischen künstlicher Intelligenz und physischer Automatisierung verfolgen, dient die Benchmark-Sättigung in digitalen Sandboxes sowohl als Meilenstein als auch als warnender Indikator. Ein Modell, das in der Lage ist, Tausende von Zeilen asynchroner Software zu debuggen oder neuartige Beweise in der theoretischen Physik abzuleiten, löst nicht automatisch die tiefgreifenden Herausforderungen der physischen Robotik, des Edge-Deployments und der Materialmanipulation.
Industrierobotik operiert unter strengen physischen Echtzeitvorgaben, bei denen deterministische Sicherheit, Millisekunden-Regelkreise und Sensorrauschen nicht verhandelbar sind. Während ein kognitiver Kern der Astra-Klasse theoretisch als übergeordneter Aufgabenplaner fungieren könnte – der breite strategische Anweisungen interpretiert und strukturierte operationale Bäume generiert –, muss er dennoch mit den untergeordneten Bewegungssteuerungen interagieren, die hydraulische Aktuatoren, Servomotoren und Echtzeit-Sensor-Feedbackschleifen regeln. Der Übergang von der reinen logischen Abstraktion zur verkörperten physischen Handlungsfähigkeit bleibt durch physische Hardware-Toleranzen, mechanischen Verschleiß und Latenzbegrenzungen eingeschränkt, die sich nicht allein durch testzeitbasierte Optimierung wegberechnen lassen.
Zudem offenbart die Benchmark-Sättigung häufig eher die Grenzen der Benchmarks selbst, als die Ankunft einer echten künstlichen allgemeinen Intelligenz zu beweisen. Wenn ein System 100 Prozent bei Tests erreicht, die von menschlichen Forschern konstruiert wurden, deutet dies oft darauf hin, dass die Evaluationssuite ihre strukturelle Obergrenze erreicht hat. Menschliche Tests stützen sich stark auf sprachliche Konsistenz, akademische Konventionen und statische Herausforderungs-Antwort-Formate. Die Bewertung, ob eine Intelligenz eigenständig ihre eigenen wissenschaftlichen Hypothesen formulieren, durch dynamische, reale Mehrdeutigkeiten navigieren und kapitalintensive Operationen steuern kann, wird eine völlig neue Generation kontinuierlicher, ergebnisoffener Evaluationsprotokolle erfordern.
Die Flugbahn der Frontier-Forschung
Unabhängig davon, wie schnell die Astra-Fähigkeiten von internen Cluster-Evaluierungen zur verifizierten kommerziellen Verfügbarkeit übergehen, wandelt sich die technische Richtung der künstlichen Intelligenz grundlegend. Die Ära, die rein durch Parameter-Inflation definiert war, weicht einer Ära, die durch strukturierte, verifizierbare Deduktion und algorithmische Suche zur Testzeit definiert wird. Da menschlichen Prüfern allmählich die standardisierten Tests ausgehen, die schwierig genug sind, um moderne Netze herauszufordern, wird sich der Fokus des Industrial Engineering unweigerlich von der Frage, ob ein Algorithmus denken kann, hin zur Bestimmung verlagern, wo dieses Denken ökonomisch und sicher in der physischen Wirtschaft verankert werden kann.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!