Une cascade de documentation technique et de rapports sectoriels provenant de la publication technologique chinoise 36Kr a déclenché un débat généralisé au sein de la communauté de l'apprentissage automatique. Au centre de ces révélations se trouve une lignée de modèles de pointe désignée en interne sous le nom de GPT-6 Astra. Si les laboratoires de pointe ont historiquement maintenu un contrôle strict sur leurs jalons de formation, la documentation divulguée pointe vers un changement de capacité sans précédent : une performance atteignant presque la saturation sur les batteries d'évaluation actuelles de l'Intelligence Artificielle Générale (AGI), notamment l'Abstraction and Reasoning Corpus (ARC-AGI), le GPQA Diamond et des tests rigoureux d'ingénierie logicielle par agents continus.
Pour les ingénieurs et les technologues industriels, les affirmations concernant des scores quasi parfaits sur les bancs d'essai cognitifs nécessitent une analyse rigoureuse. Historiquement, les modèles de langage ont présenté des profils de capacités irréguliers, maîtrisant la synthèse linguistique complexe tout en trébuchant sur le raisonnement spatial élémentaire ou la logique déterministe à plusieurs étapes. Si les mesures associées à l'architecture Astra résistent à une vérification formelle par les pairs, le mécanisme sous-jacent marque une rupture avec les lois d'échelle autorégressives conventionnelles, orientant la recherche vers l'allocation de calcul lors de l'inférence et la recherche algorithmique autonome.
L'anatomie de la saturation des bancs d'essai
De même, les chiffres de performance sur le banc d'essai GPQA Diamond — une batterie de questions de physique, chimie et biologie de niveau doctorat conçue explicitement pour résister aux attaques par récupération automatisée — atteindraient 96 % de précision. Dans un cadre académique typique, les titulaires d'un doctorat atteignent environ 65 % de précision sur ces questions lorsqu'ils sont privés d'outils Web externes. Ce bond suggère qu'Astra ne fonctionne pas simplement comme une base de connaissances à haute densité, mais exécute plutôt une déduction structurée dans des domaines interdisciplinaires avec un taux d'erreur proche des seuils de vérification standard en virgule flottante.
Au-delà des examens fermés, la télémétrie d'ingénierie fait référence aux bancs d'essai SWE-bench Verified dépassant 85 % de complétion autonome des tâches. Cette mesure suit la capacité d'un modèle à ingérer une base de code existante complète, à reproduire un problème décrit dans un rapport de bug humain brut, à rédiger un correctif efficace et à réussir des tests unitaires sans intervention humaine. Atteindre une telle fiabilité à cette échelle indique une architecture capable de maintenir des fenêtres de contexte à long terme sans subir la dégradation de l'attention intermédiaire qui a longtemps affecté les systèmes autonomes multi-tours.
Le changement de moteur : de l'ingestion à la vérification
La question technique cruciale est de savoir comment une architecture parvient à ces seuils de performance alors que le pré-entraînement textuel à l'échelle du Web par force brute a largement atteint des plateaux économiques et de disponibilité des données. Le consensus de l'industrie et les indices architecturaux contenus dans les rapports suggèrent qu'Astra ne repose pas uniquement sur une échelle de paramètres étendue. Au contraire, cette percée reflète une adoption agressive de la recherche lors de l'inférence, de l'exploration par arborescence de pensée (tree-of-thought) et de l'apprentissage par renforcement piloté par des vérificateurs formels.
Ce changement architectural reflète la trajectoire évolutive observée dans des systèmes spécialisés comme AlphaZero, mais la généralise à travers des langages formels et semi-formels arbitraires. Plutôt que de simplement mettre à l'échelle les poids des réseaux de neurones, les ingénieurs traitent le raisonnement comme un problème d'optimisation en ligne. En consacrant des ordres de grandeur de calcul supplémentaires à la génération et à la vérification d'une solution au moment de la requête, le système imite efficacement les méthodes de résolution de problèmes délibérées et systématiques des spécialistes humains dans leur domaine.
Le coût thermodynamique et économique du raisonnement
Si les résultats théoriques des bancs d'essai témoignent d'une capacité intellectuelle sans précédent, le déploiement d'une architecture gourmande en inférence introduit une friction opérationnelle massive. Dans un modèle d'infrastructure cloud conventionnel, servir un client entreprise avec une inférence de transformateur standard nécessite une distribution d'énergie prévisible à l'échelle du mégawatt et une latence réseau gérable. Les systèmes conçus autour d'arbres de recherche d'inférence expansifs inversent cependant totalement ces hypothèses économiques.
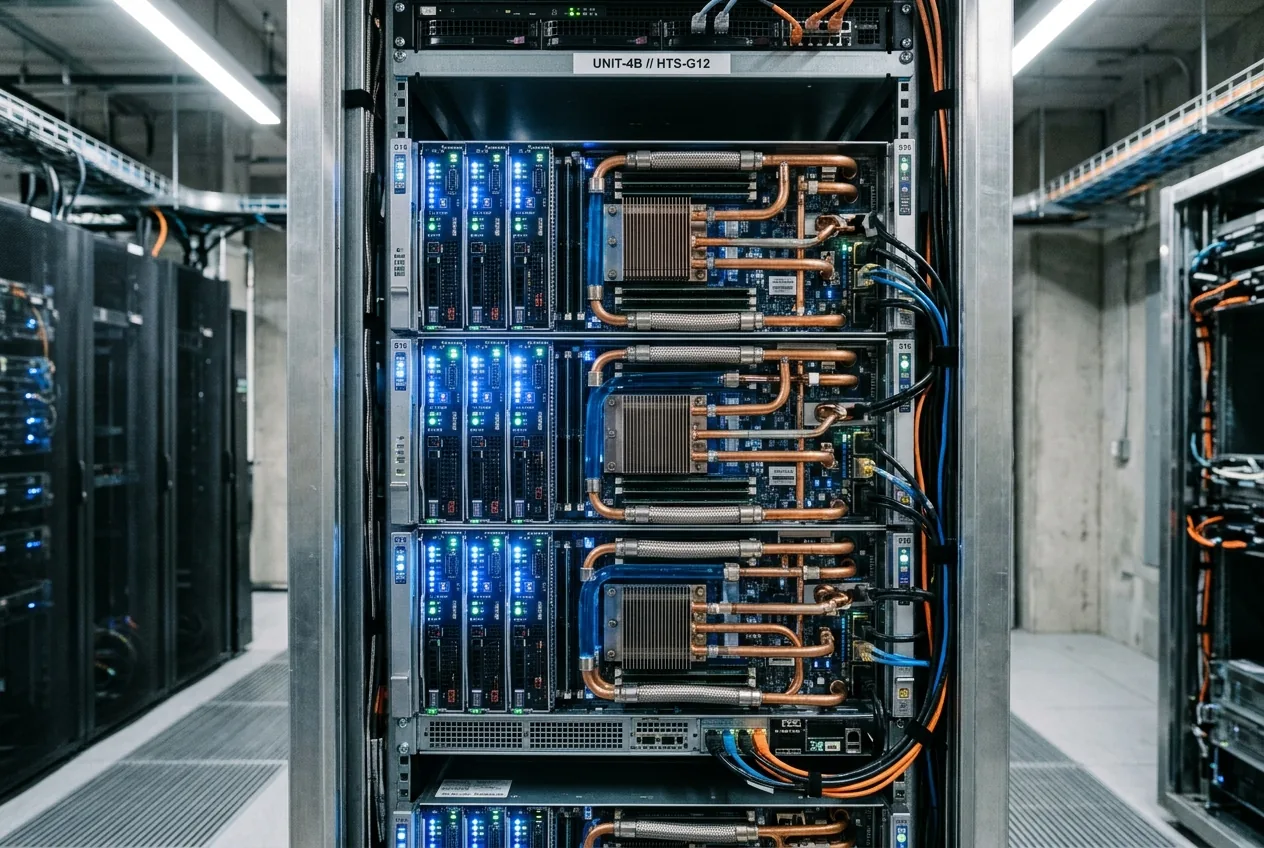
Générer des centaines de jetons candidats, exécuter des modèles de réflexion interne et s'interfacer avec des bacs à sable de vérification augmente considérablement le coût énergétique par requête. Une tâche de raisonnement complexe unique peut consommer des milliers de fois plus de cycles de calcul qu'une invite informationnelle directe. Pour les hyperscalers et les opérateurs industriels, cela déplace le goulot d'étranglement opérationnel de la fabrication de semi-conducteurs directement vers la capacité du réseau électrique, l'efficacité du refroidissement liquide et les limites thermiques localisées des centres de données.
La distance entre les mesures numériques et la réalité physique
Pour ceux qui suivent l'intersection de l'intelligence artificielle et de l'automatisation physique, la saturation des bancs d'essai dans des bacs à sable numériques sert à la fois de jalon et d'indicateur de mise en garde. Un modèle capable de déboguer des milliers de lignes de logiciel asynchrone ou de dériver de nouvelles preuves en physique théorique ne résout pas automatiquement les défis profonds de la robotique physique, du déploiement en périphérie et de la manipulation de matériaux.
La robotique industrielle fonctionne selon des contraintes physiques en temps réel strictes où la sécurité déterministe, les boucles de contrôle à la milliseconde et le bruit des capteurs ne sont pas négociables. Bien qu'un cœur cognitif de classe Astra puisse concevablement agir comme un planificateur de tâches de haut niveau — interprétant des instructions stratégiques larges et générant des arbres opérationnels structurés — il doit toujours s'interfacer avec des contrôleurs de mouvement de bas niveau qui gouvernent les actionneurs hydrauliques, les servomoteurs et les boucles de rétroaction sensorielle en temps réel. La transition de l'abstraction logique pure vers l'agentivité physique incarnée reste contrainte par les tolérances du matériel physique, l'usure mécanique et les limitations de latence qui ne peuvent être éliminées uniquement par l'optimisation au moment du test.
De plus, la saturation des bancs d'essai expose fréquemment les limites des bancs d'essai eux-mêmes plutôt que de prouver l'arrivée d'une véritable intelligence artificielle générale. Lorsqu'un système approche les 100 % sur des tests construits par des chercheurs humains, cela indique souvent que la suite d'évaluation a atteint son plafond structurel. Les tests humains reposent fortement sur la cohérence linguistique, les conventions académiques et des formats défi-réponse statiques. Évaluer si une intelligence peut formuler indépendamment ses propres hypothèses scientifiques, naviguer dans l'ambiguïté dynamique du monde réel et gérer des opérations à forte intensité de capital nécessitera une toute nouvelle génération de protocoles d'évaluation continus et ouverts.
La trajectoire de la recherche de pointe
Indépendamment de la rapidité avec laquelle les capacités d'Astra passeront des évaluations en cluster privé à une disponibilité commerciale vérifiée, l'orientation technique de l'intelligence artificielle de pointe est en train de se transformer fondamentalement. L'ère définie purement par l'inflation des paramètres cède le pas à une ère définie par une déduction structurée et vérifiable ainsi que par la recherche algorithmique lors des tests. Alors que les évaluateurs humains se retrouvent à court de tests standardisés suffisamment difficiles pour challenger les réseaux modernes, l'attention de l'ingénierie industrielle pivotera inévitablement de la question de savoir si un algorithme peut raisonner vers la détermination de l'endroit où ce raisonnement peut être ancré de manière économique et sûre dans l'économie physique.



Comments
No comments yet. Be the first!