Una cascada de documentación técnica e informes de la industria provenientes de la publicación tecnológica china 36Kr ha encendido un intenso debate en toda la comunidad de aprendizaje automático. En el centro de las revelaciones se encuentra un linaje avanzado de modelos frontera designado internamente como GPT-6 Astra. Si bien los laboratorios de vanguardia han mantenido históricamente un control estricto sobre sus hitos de entrenamiento, la documentación filtrada apunta a un cambio de capacidades sin precedentes: un rendimiento que casi satura las baterías de evaluación actuales de Inteligencia Artificial General (AGI), incluyendo el Abstraction and Reasoning Corpus (ARC-AGI), GPQA Diamond y rigurosos puntos de referencia de ingeniería de software para agentes continuos.
Para ingenieros y tecnólogos industriales, las afirmaciones de puntuaciones casi perfectas en pruebas de referencia cognitivas requieren un análisis riguroso. Históricamente, los modelos de lenguaje han exhibido perfiles de capacidad irregulares, dominando la síntesis lingüística compleja mientras flaquean en razonamiento espacial básico o lógica determinista de varios pasos. Si las métricas asociadas con la arquitectura Astra resisten la verificación formal por pares, el mecanismo subyacente marca un alejamiento de las leyes de escalado autorregresivo convencionales, apuntando hacia una asignación de cómputo profundo durante la inferencia y una búsqueda algorítmica autónoma.
La anatomía de la saturación de las pruebas de referencia
De manera similar, las cifras de rendimiento en la prueba GPQA Diamond —una batería de preguntas de física, química y biología de nivel de posgrado diseñadas explícitamente para resistir ataques de recuperación automatizada— reportan alcanzar un 96 por ciento de precisión. En entornos académicos típicos, los doctores humanos logran aproximadamente un 65 por ciento de precisión en estas preguntas cuando se les priva de herramientas web externas. Este salto sugiere que Astra no solo opera como una base de conocimientos de alta densidad, sino que ejecuta deducciones estructuradas a través de dominios interdisciplinarios con una tasa de error cercana a los umbrales de verificación estándar de punto flotante.
Más allá de los exámenes cerrados, la telemetría de ingeniería hace referencia a pruebas de SWE-bench Verified que superan el 85 por ciento en la finalización autónoma de tareas. Esta métrica rastrea la capacidad de un modelo para ingerir toda una base de código existente, reproducir un problema descrito en un informe de errores humano, escribir un parche efectivo y pasar pruebas unitarias sin intervención humana. Alcanzar la fiabilidad a esta escala indica una arquitectura capaz de mantener ventanas de contexto de largo alcance sin sufrir la degradación de atención intermedia que ha afectado durante mucho tiempo a los sistemas autónomos de múltiples turnos.
El cambio de motor: De la ingestión a la verificación
La cuestión de ingeniería crítica es cómo una arquitectura llega a estos umbrales de rendimiento cuando el preentrenamiento de texto a escala web mediante fuerza bruta ha llegado en gran medida a una meseta económica y de disponibilidad de datos. El consenso de la industria y los indicios arquitectónicos dentro de los informes sugieren que Astra no depende únicamente de una escala de parámetros expandida. En cambio, el avance refleja una adopción agresiva de búsqueda durante la inferencia, exploración mediante árboles de pensamiento y aprendizaje por refuerzo impulsado por verificadores formales.
Este cambio arquitectónico refleja el camino evolutivo observado en sistemas especializados como AlphaZero, pero lo generaliza a través de lenguajes formales y semiformales arbitrarios. En lugar de simplemente escalar los pesos de las redes neuronales, los ingenieros están tratando el razonamiento como un problema de optimización en línea. Al dedicar órdenes de magnitud más de cómputo a la generación y verificación de una solución en el momento de la consulta, el sistema imita efectivamente los métodos de resolución de problemas deliberativos y sistemáticos de los especialistas humanos en el dominio.
El costo termodinámico y económico del razonamiento
Aunque los resultados teóricos de las pruebas de referencia muestran una capacidad intelectual sin precedentes, el despliegue de una arquitectura con uso intensivo de inferencia introduce una fricción operativa masiva. En un modelo de infraestructura en la nube convencional, servir a un cliente empresarial con inferencia de transformadores estándar requiere una distribución de energía predecible a escala de megavatios y una latencia de red manejable. Sin embargo, los sistemas diseñados en torno a amplios árboles de búsqueda de inferencia invierten completamente estas suposiciones económicas.
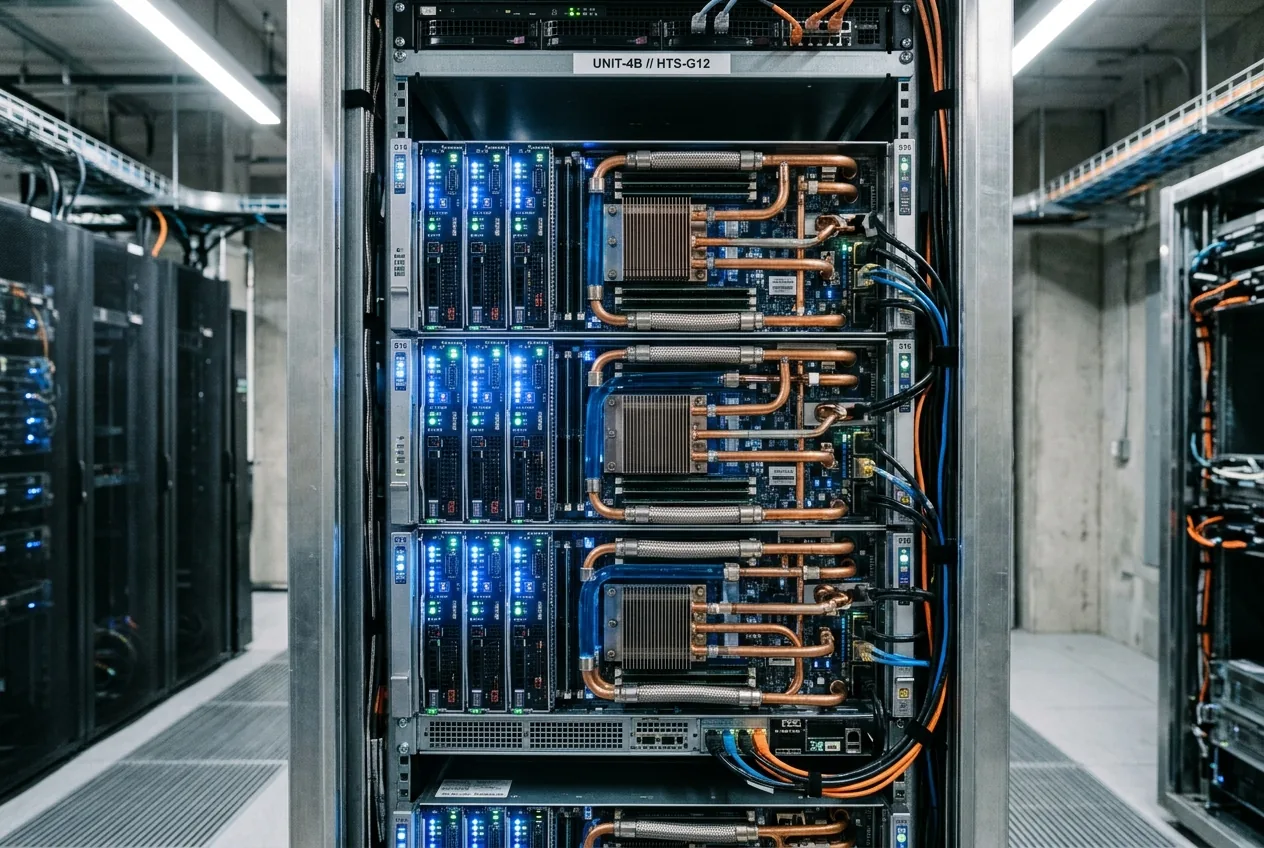
Generar cientos de tokens candidatos, ejecutar modelos de reflexión interna e interactuar con entornos aislados (sandboxes) de verificación expande drásticamente el costo energético por consulta. Una sola tarea de razonamiento complejo podría consumir miles de veces más ciclos de cómputo que una simple solicitud informativa. Para los proveedores de hiperescala y operadores industriales, esto desplaza el cuello de botella operativo desde la fabricación de semiconductores directamente a la capacidad de la red eléctrica, la eficiencia de la refrigeración líquida y los límites térmicos localizados de los centros de datos.
La distancia entre las métricas digitales y la realidad física
Para aquellos que siguen la intersección de la inteligencia artificial y la automatización física, la saturación de las pruebas de referencia en entornos digitales sirve tanto como un hito como un indicador de precaución. Un modelo capaz de depurar miles de líneas de software asíncrono o derivar nuevas pruebas en física teórica no resuelve automáticamente los profundos desafíos de la robótica física, el despliegue en el borde y la manipulación de materiales.
La robótica industrial opera bajo estrictas restricciones físicas en tiempo real donde la seguridad determinista, los bucles de control de milisegundos y el ruido de los sensores son innegociables. Si bien un núcleo cognitivo de clase Astra podría concebiblemente actuar como un planificador de tareas de alto nivel —interpretando instrucciones estratégicas amplias y generando árboles operativos estructurados—, aún debe interactuar con controladores de movimiento de bajo nivel que gobiernan actuadores hidráulicos, servomotores y bucles de retroalimentación sensorial en tiempo real. La transición de la abstracción lógica pura a la agencia física encarnada permanece limitada por las tolerancias del hardware físico, el desgaste mecánico y las limitaciones de latencia que no pueden ser eliminadas mediante la optimización en tiempo de prueba.
Además, la saturación de las pruebas de referencia frecuentemente expone las limitaciones de las propias pruebas en lugar de probar la llegada de una verdadera inteligencia artificial general. Cuando un sistema se acerca al 100 por ciento en pruebas construidas por investigadores humanos, a menudo indica que el conjunto de evaluación ha alcanzado su techo estructural. Las pruebas humanas dependen en gran medida de la consistencia lingüística, las convenciones académicas y los formatos estáticos de desafío-respuesta. Evaluar si una inteligencia puede formular independientemente sus propias hipótesis científicas, navegar la ambigüedad dinámica del mundo real y gestionar operaciones intensivas en capital requerirá una generación completamente nueva de protocolos de evaluación continuos y abiertos.
La trayectoria de la investigación de frontera
Independientemente de la rapidez con la que las capacidades de Astra pasen de las evaluaciones en clústeres privados a la disponibilidad comercial verificada, la dirección técnica de la inteligencia artificial de vanguardia se está transformando fundamentalmente. La era definida puramente por la inflación de parámetros está cediendo terreno ante una era definida por la deducción estructurada y verificable y la búsqueda algorítmica en tiempo de prueba. A medida que los evaluadores humanos descubren que se están quedando sin pruebas estandarizadas lo suficientemente difíciles como para desafiar a las redes modernas, el enfoque de la ingeniería industrial inevitablemente girará desde cuestionar si un algoritmo puede razonar hacia determinar dónde puede ese razonamiento ser anclado económica y seguramente en la economía física.



Comments
No comments yet. Be the first!