Durante la última semana, los foros de desarrolladores, los canales internos de las empresas y medios tecnológicos internacionales como 36Kr, con sede en Pekín, han estallado en un coro coordinado de frustración. Los ingenieros de software que ejecutan tuberías de producción de alto rendimiento, mesas de trading algorítmico y flujos de trabajo de generación automática de código comenzaron a notar una degradación abrupta en la fidelidad de los resultados de los modelos de vanguardia líderes. Las peticiones que habitualmente producían una lógica de varios pasos impecable, de repente alucinaban con una sintaxis trivial; el seguimiento de contexto complejo colapsaba a mitad del proceso; y los parámetros de seguimiento de instrucciones parecían desmoronarse de la noche a la mañana. A medida que se extendieron las afirmaciones de que las asignaciones de cómputo de los modelos habían sido recortadas y la inteligencia efectiva se había desplomado, las demandas de los usuarios de cancelaciones de suscripción y reembolsos de créditos de API aumentaron a un volumen sin precedentes.
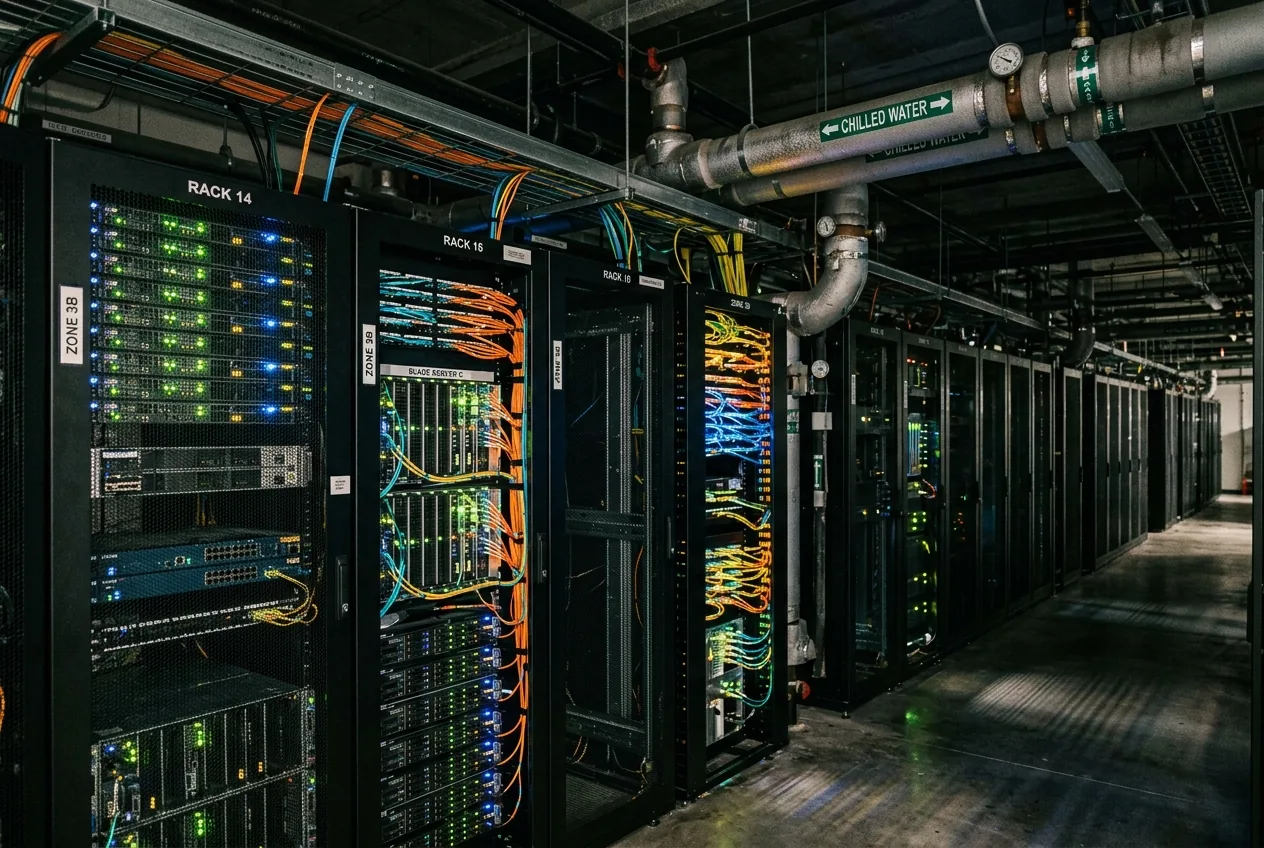
Aunque los proveedores de modelos rara vez revelan ajustes en tiempo real a su infraestructura de backend, los síntomas reportados por equipos de ingeniería de todo el mundo apuntan a una fricción estructural familiar en la ingeniería computacional moderna. El problema no es simplemente que un sistema algorítmico haya tenido un mal día. Más bien, representa la colisión entre la física de fuerza bruta de la inferencia a hiperescala y la economía insostenible del despliegue de inteligencia artificial de tarifa plana. Cuando miles de sistemas automatizados hacen ping simultáneamente a un clúster centralizado de silicio especializado, algo inevitablemente tiene que ceder. La mayoría de las veces, esa cesión ocurre en silencio, oculta tras las limpias abstracciones de un punto final de API.
La mecánica de la degradación computacional nocturna
Para entender por qué un modelo de lenguaje avanzado puede parecer perder una parte significativa de su capacidad analítica de la noche a la mañana, uno debe mirar más allá de los pesos estáticos de la red neuronal. En las arquitecturas de aprendizaje profundo contemporáneas, la experiencia del usuario está fundamentalmente ligada al cómputo dinámico en tiempo de inferencia. Un modelo de vanguardia no es simplemente una matriz matemática congelada almacenada en el disco; es un proceso de cómputo activo cuya precisión de salida depende en gran medida de cuántas operaciones de coma flotante asigne el proveedor a cada token generado. Cuando los clústeres de servidores alcanzan los límites de capacidad, los proveedores despliegan técnicas de optimización agresivas para evitar una interrupción total.
La palanca principal en este acto de equilibrio operativo es la cuantización dinámica. En condiciones normales de funcionamiento, un modelo de última generación puede servir pesos y activaciones con una precisión de coma flotante de 16 o 8 bits (FP16 o FP8). Sin embargo, cuando el tráfico empresarial aumenta o los clústeres de servidores enfrentan restricciones de energía, los proveedores pueden reducir dinámicamente la precisión a representaciones de enteros de 4 bits (INT4) o emplear una poda de pesos agresiva. Si bien la cuantización de pocos bits funciona notablemente bien para la charla conversacional y la prosa básica, daña severamente los caminos de razonamiento sutiles y de alta dimensión requeridos para la síntesis compleja de código, la lógica matemática formal y la corrección de errores en casos límite. Para un ingeniero que depende de una ejecución determinista, esta caída de precisión se siente exactamente como una lobotomía nocturna.
Más allá de la cuantización, los proveedores manipulan frecuentemente la decodificación especulativa y las capas de enrutamiento de mezcla de expertos (MoE). En un sistema MoE distribuido, los tokens de entrada se enrutan a subredes específicas según el contexto del dominio. Bajo un estrés computacional extremo, los motores de inferencia pueden limitar artificialmente el número de expertos activos invocados por paso hacia adelante, o restringir la duración de los borradores de generación especulativa interna. Además, la compresión de la memoria caché de clave-valor (KV) —evictando o cuantizando el historial de atención para preservar el ancho de banda de la memoria— priva al modelo de su capacidad para retener detalles contextuales de grano fino a través de amplias ventanas de tokens. Los pesos no han cambiado fundamentalmente, pero el motor computacional que los impulsa ha sido reducido a una fracción de su potencia prevista.
Las crudas realidades de la termodinámica de los centros de datos y los costes de inferencia
Para los niveles de consumo con un precio modesto de veinte dólares al mes, un usuario avanzado activo puede consumir fácilmente cientos de dólares en electricidad bruta y depreciación de hardware durante un ciclo de facturación de treinta días. Incluso para los consumidores de API comerciales, los niveles de precios establecidos durante las fases de competencia feroz a menudo no reflejan el verdadero coste marginal de la computación en picos de demanda. Cuando la demanda de inferencia supera la capacidad de la red eléctrica local o crea estrangulamiento térmico en racks de servidores densos, los ingenieros de infraestructura no tienen más remedio que aplicar algoritmos de reducción de carga. En la infraestructura en la nube tradicional, la reducción de carga resulta en límites de tasa o códigos de error HTTP 503 estándar. En el mundo hipercompetitivo de la IA generativa, donde las métricas de tiempo de actividad son analizadas implacablemente, los proveedores a menudo eligen el mal menor de la degradación silenciosa: entregar una respuesta inferior y carente de cómputo en lugar de no entregar ninguna.
El coste industrial de las API poco fiables
En las aplicaciones de consumo, un declive inesperado en la calidad de la escritura es una molestia menor. En la automatización industrial, la robótica y las arquitecturas de software de misión crítica, es un riesgo inaceptable. Las cadenas de suministro modernas y las tuberías de software automatizadas están cada vez más diseñadas en torno a grandes modelos fundamentales que manejan tareas como la verificación de código estructural, la traducción CAD automatizada, la optimización del despacho de inventario y la interpretación sensorial en tiempo real. Estos sistemas requieren un determinismo conductual estricto. Una máquina herramienta o un pórtico de almacén automatizado no puede tolerar que un modelo de visión-lenguaje cuantizado de forma impredecible identifique erróneamente una coordenada espacial porque sus cabezales de atención fueron comprimidos para liberar memoria del servidor.
Cuando un punto final de API exhibe oscilaciones salvajes y no anunciadas en la profundidad del razonamiento, toda la arquitectura construida sobre él se vuelve frágil. Los principios de ingeniería de alta fiabilidad se basan en conocer los límites de tolerancia exactos de cada componente en la pila. Si una viga de acero estructural viera reducida dinámicamente su resistencia a la fluencia durante períodos de alta demanda en la acería, la ingeniería civil se detendría. Sin embargo, actualmente se espera que el software empresarial tolere precisamente este paradigma de los proveedores de IA fundamentales. Es esta violación fundamental de la confianza en la ingeniería lo que ha llevado a los usuarios corporativos a exigir auditorías de facturación formales, cancelaciones de contratos y reembolsos completos en efectivo.
Además, esta inestabilidad obliga a las empresas a implementar una ingeniería defensiva costosa. Para protegerse contra la degradación impredecible del modelo, los equipos se ven obligados a construir bucles de validación secundarios, realizar comprobaciones de consenso de múltiples modelos y desplegar redes locales de pesos abiertos como respaldo. Estas medidas compensatorias introducen latencia adicional, inflan los gastos operativos internos y contrarrestan directamente las ganancias de eficiencia que la adopción de modelos de vanguardia alojados debía proporcionar en primer lugar.
¿Pueden los Acuerdos de Nivel de Servicio Computacional restaurar la confianza?
La reacción actual marca el fin de la luna de miel de la infraestructura de IA generativa. La industria se acerca rápidamente a un punto de inflexión necesario donde las vagas promesas de inteligencia deben ser reemplazadas por contratos de desempeño cuantificables y verificables. Si los proveedores desean retener el capital empresarial y evitar una intervención regulatoria generalizada con respecto a la prestación de servicios engañosa, deben introducir Acuerdos de Nivel de Servicio Computacional (cSLA) transparentes.
Bajo un marco cSLA maduro, el acceso a un modelo de IA no se vendería simplemente como recuentos de entrada y salida de tokens brutos. En cambio, los contratos deben especificar explícitamente los parámetros operativos del cómputo subyacente: precisión de coma flotante garantizada, presupuestos de enrutamiento de tokens verificados, umbrales mínimos de retención de caché KV y configuraciones de decodificación deterministas. Si una emergencia de infraestructura obliga a un proveedor a limitar el cómputo o emplear cuantización dinámica, el sistema debe transmitir este cambio de estado explícitamente a través de los metadatos de la API. Esto permite que los sistemas automatizados intermedios pausen la ejecución, difieran tareas no críticas o redirijan el tráfico a clústeres privados dedicados en lugar de consumir ciegamente resultados comprometidos.



Comments
No comments yet. Be the first!