Nell'ultima settimana, forum di sviluppatori, canali riservati aziendali e testate tecnologiche internazionali come la testata pechinese 36Kr sono esplosi in un coro coordinato di frustrazione. Gli ingegneri del software che gestiscono pipeline di produzione ad alto throughput, banchi di trading algoritmico e flussi di lavoro automatizzati per la generazione di codice hanno iniziato a notare un brusco degrado nella fedeltà dell'output dei principali modelli di frontiera. Prompt che generavano abitualmente logiche multi-passaggio impeccabili hanno improvvisamente prodotto allucinazioni su una sintassi banale; il tracciamento del contesto complesso è collassato a metà elaborazione; e i parametri di rispetto delle istruzioni sono sembrati svanire da un giorno all'altro. Con il diffondersi delle affermazioni secondo cui le allocazioni di calcolo dei modelli erano state tagliate e l'intelligenza effettiva era precipitata, le richieste degli utenti di annullamento degli abbonamenti e rimborsi dei crediti API sono aumentate a un volume senza precedenti.
Sebbene i fornitori di modelli raramente rivelino aggiustamenti in tempo reale alla loro infrastruttura di backend, i sintomi segnalati dai team di ingegneria di tutto il mondo indicano un attrito strutturale familiare nella moderna ingegneria computazionale. Il problema non è semplicemente che un sistema algoritmico ha avuto una giornata negativa. Rappresenta piuttosto la collisione tra la fisica della forza bruta dell'inferenza su scala iperscalare e l'insostenibile economia dello sviluppo dell'intelligenza artificiale a tariffa fissa. Quando migliaia di sistemi automatizzati interrogano simultaneamente un cluster centralizzato di silicio specializzato, qualcosa deve inevitabilmente cedere. Il più delle volte, tale cedimento avviene silenziosamente, nascosto dietro le pulite astrazioni di un endpoint API.
La meccanica del downgrade computazionale notturno
Per capire perché un modello linguistico avanzato possa sembrare perdere una parte significativa della sua capacità analitica da un giorno all'altro, bisogna guardare oltre i pesi statici della rete neurale. Nelle moderne architetture di deep learning, l'esperienza utente è fondamentalmente legata al calcolo dinamico durante l'inferenza. Un modello di frontiera non è semplicemente una matrice matematica congelata archiviata su disco; è un processo di calcolo attivo la cui precisione dell'output dipende pesantemente dal numero di operazioni in virgola mobile che il fornitore alloca a ogni token generato. Quando i cluster di server raggiungono i limiti di capacità, i fornitori implementano tecniche di ottimizzazione aggressive per evitare un'interruzione totale.
La leva principale in questo atto di bilanciamento operativo è la quantizzazione dinamica. In condizioni operative normali, un modello all'avanguardia può fornire pesi e attivazioni a una precisione in virgola mobile a 16 o 8 bit (FP16 o FP8). Tuttavia, quando il traffico aziendale subisce picchi o i cluster di server affrontano vincoli di potenza, i fornitori possono ridurre dinamicamente la precisione a rappresentazioni intere a 4 bit (INT4) o impiegare un pruning aggressivo dei pesi. Sebbene la quantizzazione a basso bit funzioni notevolmente bene per le conversazioni informali e la prosa di base, danneggia gravemente i sottili percorsi di ragionamento ad alta dimensionalità necessari per la sintesi di codice complesso, la logica matematica formale e la correzione degli errori ai margini. Per un ingegnere che si affida a un'esecuzione deterministica, questo calo di precisione viene percepito esattamente come una lobotomia notturna.
Oltre alla quantizzazione, i fornitori manipolano frequentemente il decoding speculativo e i layer di routing mixture-of-experts (MoE). In un sistema MoE distribuito, i token in input vengono instradati verso sotto-reti specifiche in base al contesto del dominio. Sotto estremo stress computazionale, i motori di inferenza possono limitare artificialmente il numero di esperti attivi invocati per ogni forward pass, o limitare la lunghezza delle bozze di generazione speculativa interna. Inoltre, la compressione della cache chiave-valore (KV) — espellendo o quantizzando lo storico dell'attenzione per preservare la larghezza di banda della memoria — priva il modello della sua capacità di mantenere dettagli contestuali granulari attraverso ampie finestre di token. I pesi non sono cambiati radicalmente, ma il motore computazionale che li guida è stato ridotto a una frazione della potenza prevista.
Le dure realtà della termodinamica dei datacenter e dei costi di inferenza
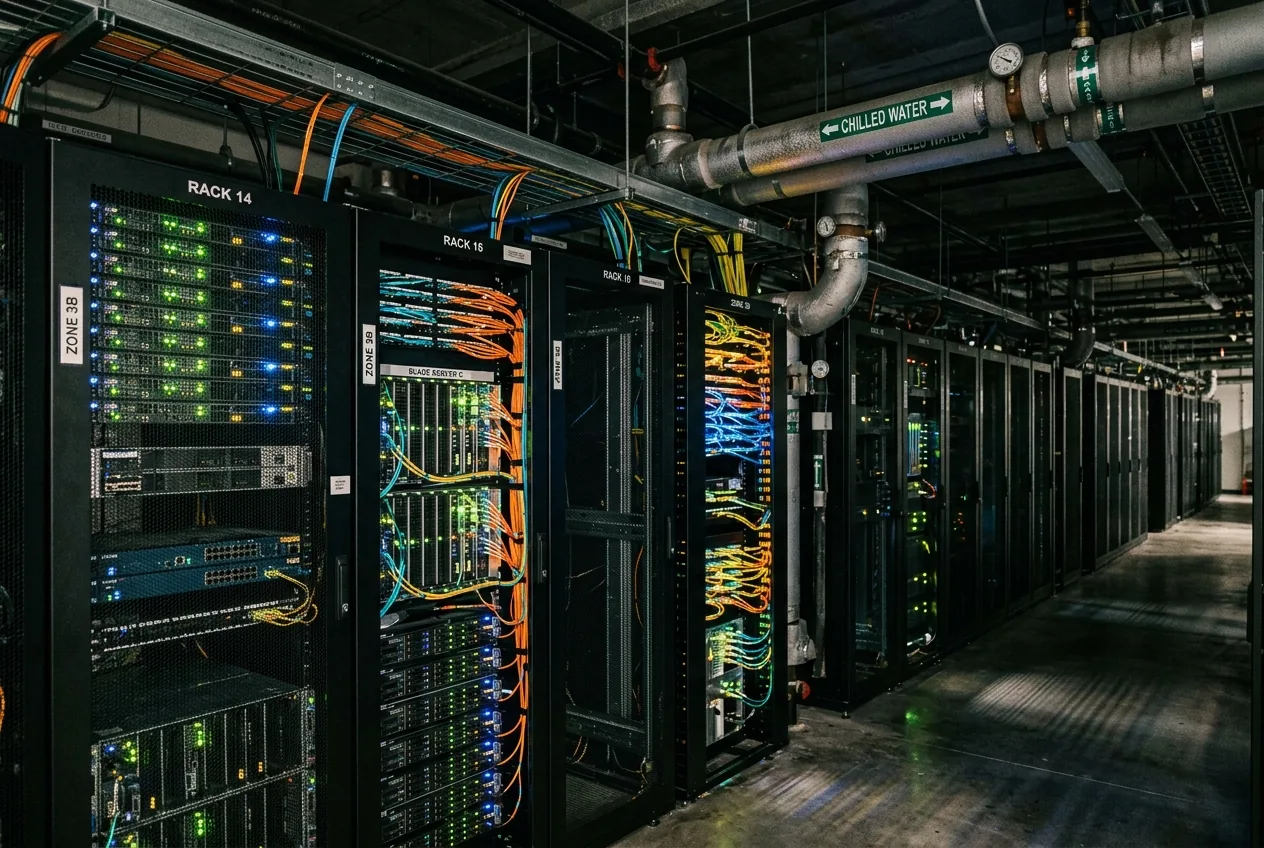
Per i livelli consumer con un prezzo modesto di venti dollari al mese, un power user attivo può facilmente consumare centinaia di dollari in elettricità grezza e deprezzamento dell'hardware in un ciclo di fatturazione di trenta giorni. Anche per i consumatori API commerciali, i livelli di prezzo fissati durante le fasi di conquista del mercato spesso non riflettono il vero costo marginale del calcolo a picco di domanda. Quando la domanda di inferenza supera la capacità della rete elettrica locale o crea un throttling termico attraverso densi rack di server, gli ingegneri delle infrastrutture non hanno altra scelta se non quella di implementare algoritmi di riduzione del carico (load-shedding). Nell'infrastruttura cloud tradizionale, la riduzione del carico si traduce in limiti di velocità o codici di errore standard HTTP 503. Nel mondo iper-competitivo dell'IA generativa, dove le metriche di uptime sono scrutinate spietatamente, i fornitori scelgono spesso il male minore del degrado silenzioso: fornire una risposta inferiore e carente di risorse computazionali piuttosto che non fornirla affatto.
Il costo industriale delle API inaffidabili
Nelle applicazioni consumer, un calo inaspettato della qualità di scrittura è un fastidio minore. Nell'automazione industriale, nella robotica e nelle architetture software mission-critical, è un pericolo inaccettabile. Le moderne catene di approvvigionamento e le pipeline software automatizzate sono sempre più strutturate attorno a grandi modelli fondamentali che gestiscono attività come la verifica del codice strutturale, la traduzione CAD automatizzata, l'ottimizzazione dell'invio dell'inventario e l'interpretazione sensoriale in tempo reale. Questi sistemi richiedono un rigido determinismo comportamentale. Una macchina utensile o un carroponte di un magazzino automatizzato non possono tollerare un modello di visione-linguaggio erroneamente quantizzato che identifica male una coordinata spaziale perché le sue teste di attenzione sono state compresse per liberare memoria del server.
Quando un endpoint API mostra oscillazioni selvagge e non annunciate nella profondità di ragionamento, l'intera architettura costruita sopra di esso diventa fragile. I principi di ingegneria ad alta affidabilità si basano sulla conoscenza degli esatti limiti di tolleranza di ogni componente dello stack. Se una trave d'acciaio strutturale vedesse la sua resistenza allo snervamento dimezzata dinamicamente durante i periodi di alta domanda dell'acciaieria, l'ingegneria civile si fermerebbe. Eppure, ci si aspetta attualmente che il software aziendale tolleri esattamente questo paradigma dai fornitori di IA di base. È questa violazione fondamentale della fiducia ingegneristica che ha spinto gli utenti aziendali a richiedere audit di fatturazione formali, annullamenti di contratti e rimborsi in contanti completi.
Inoltre, questa instabilità costringe le aziende a implementare costose tecniche di ingegneria difensiva. Per proteggersi dall'imprevedibile degrado del modello, i team sono costretti a costruire loop di validazione secondari, eseguire controlli di consenso multi-modello e implementare reti di fallback locali a pesi aperti. Queste misure compensative introducono una latenza aggiuntiva, aumentano le spese operative interne e contrastano direttamente i guadagni di efficienza che l'adozione di modelli di frontiera ospitati avrebbe dovuto fornire fin dall'inizio.
Gli accordi sul livello di servizio computazionale possono ripristinare la fiducia?
L'attuale reazione segna la fine della luna di miele per l'infrastruttura dell'IA generativa. Il settore si sta rapidamente avvicinando a un necessario punto di svolta in cui le vaghe promesse di intelligenza devono essere sostituite da contratti di prestazione quantificabili e verificabili. Se i fornitori desiderano mantenere il capitale aziendale ed evitare un diffuso intervento normativo riguardante l'erogazione ingannevole del servizio, devono introdurre accordi trasparenti sul livello di servizio computazionale (cSLA).
In un quadro cSLA maturo, l'accesso a un modello di IA non verrebbe venduto semplicemente come conteggio grezzo di input e output di token. Piuttosto, i contratti devono specificare esplicitamente i parametri operativi del calcolo sottostante: precisione in virgola mobile garantita, budget di routing dei token verificati, soglie minime di conservazione della cache KV e impostazioni di decodifica deterministiche. Se un'emergenza infrastrutturale costringe un fornitore a limitare il calcolo o a implementare la quantizzazione dinamica, il sistema deve trasmettere questo cambio di stato esplicitamente attraverso i metadati dell'API. Ciò consente ai sistemi automatizzati a valle di sospendere l'esecuzione, rimandare attività non critiche o reindirizzare il traffico verso cluster privati dedicati invece di consumare alla cieca output compromessi.



Comments
No comments yet. Be the first!