在过去的一周里,开发者论坛、企业内部渠道以及像北京 36Kr 这样的国际科技媒体中,不满情绪如潮水般涌现并汇聚成一致的呼声。负责运行高吞吐量生产管道、算法交易平台以及自动化代码生成工作流的软件工程师们开始注意到,领先的前沿模型输出保真度出现了突然下降。那些原本能轻松得出完美多步逻辑的提示词,突然开始产生毫无意义的语法幻觉;复杂的上下文追踪在中途崩溃;指令遵循参数也似乎在一夜之间失效。随着关于模型算力配置被大幅削减、实际智能水平骤降的说法四处蔓延,用户要求取消订阅和退还 API 费用的声浪达到了前所未有的规模。
尽管模型提供商很少公开其后端基础设施的实时调整,但在全球工程团队中报告的症状,指向了现代计算工程中一种熟悉的结构性摩擦。这不仅仅是算法系统偶尔“发挥失常”的问题,而是代表了超大规模推理的蛮力物理学与平价人工智能部署之间不可持续的经济学逻辑发生了碰撞。当数以千计的自动化系统同时向一个专门的硅芯片集群发出请求时,必然会有一方做出让步。而这种让步往往是在悄无声息中发生的,隐藏在 API 端点整洁的抽象之下。
一夜之间算力降级的机制
要理解为什么一个先进的语言模型看起来会在一夜之间失去大部分分析能力,就必须超越神经网络的静态权重来看待问题。在当代的深度学习架构中,用户体验从根本上与动态推理时的算力挂钩。前沿模型不仅仅是存储在磁盘上的冷冰冰的数学矩阵;它是一个活跃的计算过程,其输出精度在很大程度上取决于提供商为每个生成的 Token 分配了多少浮点运算次数。当服务器集群达到容量极限时,提供商会部署激进的优化技术以避免完全宕机。
这种操作平衡术中的核心杠杆是动态量化。在正常运行条件下,最先进的模型可以以 16 位或 8 位浮点精度(FP16 或 FP8)提供权重和激活值。然而,当企业流量激增或服务器集群面临电力约束时,提供商可以将精度动态降低到 4 位整数表示(INT4),或采用激进的权重剪枝技术。虽然低位量化对于闲聊和基础文案效果显著,但它会严重破坏复杂代码合成、形式数学逻辑和边缘情况纠错所需的精细、高维推理路径。对于依赖确定性执行的工程师来说,这种精度的下降感觉就像一夜之间被“切除了前额叶”。
除了量化之外,提供商还经常操纵推测解码(speculative decoding)和专家混合(MoE)路由层。在分布式 MoE 系统中,输入 Token 会根据领域上下文被路由到特定的子网络。在极端计算压力下,推理引擎可以人为地限制每次前向传递所调用的活跃专家数量,或者限制内部推测生成的草稿长度。此外,键值(KV)缓存压缩——通过驱逐或量化注意力历史记录来节省内存带宽——剥夺了模型在庞大的 Token 窗口中保留细粒度上下文细节的能力。模型的权重本质上并没有改变,但驱动它们的计算引擎已被调低至其预期马力的几分之一。
数据中心热力学与推理成本的严峻现实
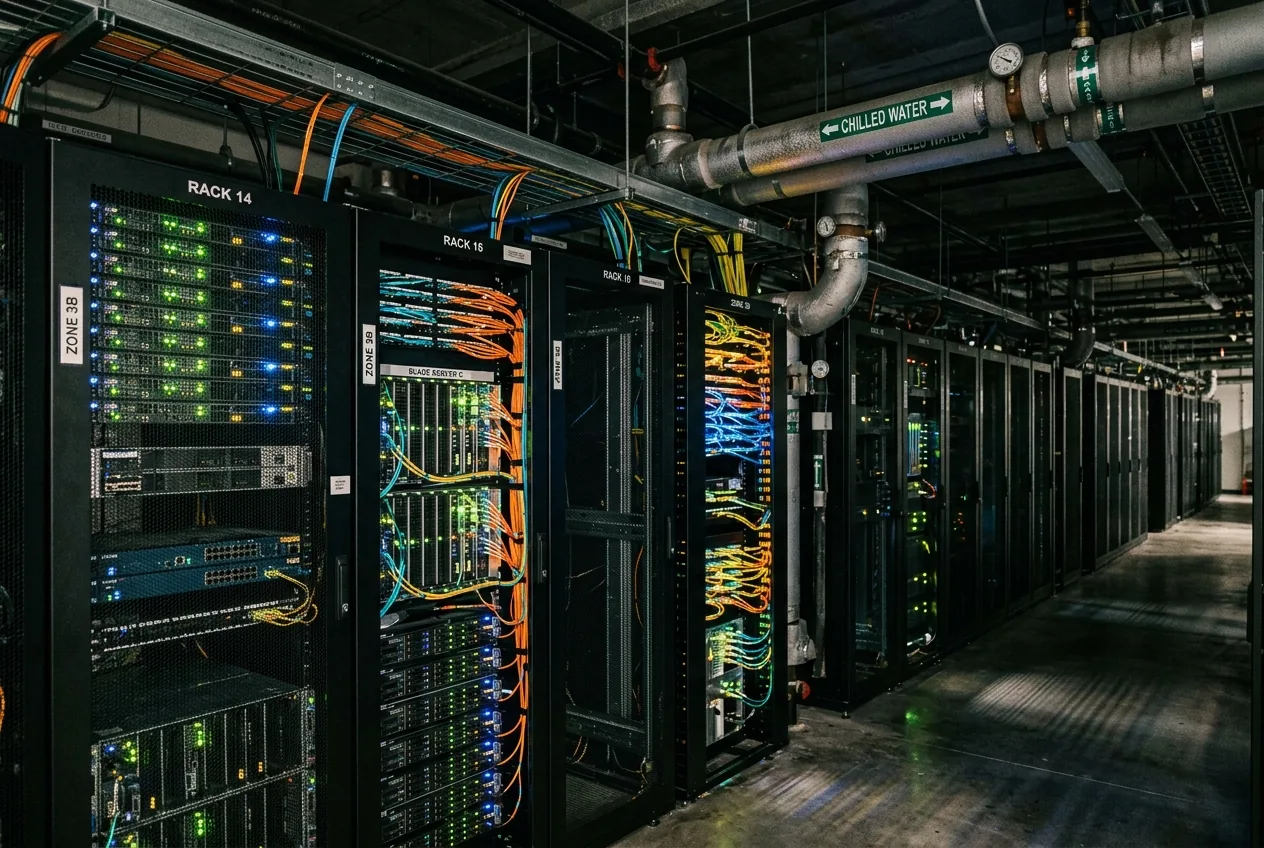
对于每月二十美元的消费级套餐而言,一个活跃的重度用户在三十天的计费周期内,仅原始电费和硬件折旧费用就很容易达到数百美元。即使对于商业 API 用户,在竞争激烈的圈地阶段所设定的定价层级,往往也无法反映峰值需求计算的真实边际成本。当推理需求超过了本地电网的承载能力,或者导致密集服务器机架出现过热降频时,基础设施工程师别无选择,只能启用负载削减算法。在传统的云基础设施中,负载削减会导致限流或标准的 HTTP 503 错误代码。而在生成式 AI 这个竞争激烈的领域,由于运行时间指标受到严苛审视,提供商往往选择“两害相权取其轻”的静默降级策略:即提供一个性能劣化的、算力匮乏的响应,而不是完全无法响应。
不可靠 API 的工业代价
在消费级应用中,写作质量的意外下降只是一个小麻烦。但在工业自动化、机器人技术和关键任务软件架构中,这却是一个不可接受的隐患。现代供应链和自动化软件管道越来越多地围绕大型基础模型构建,以处理结构化代码验证、自动化 CAD 转换、库存调度优化和实时感知解读等任务。这些系统需要严格的行为确定性。如果机床或自动化仓库门式起重机因为注意力头被压缩以释放服务器内存,从而导致模型错误识别空间坐标,那是无法容忍的。
当 API 端点表现出剧烈且未经通知的推理深度波动时,构建在其之上的整个架构就会变得脆弱。高可靠性工程原则的前提是必须了解堆栈中每个组件的确切容差边界。如果一根结构钢梁在钢厂需求高涨时,其屈服强度被动态减半,那么土木工程将陷入瘫痪。然而,企业软件目前却不得不承受来自基础 AI 提供商的这种范式。正是这种对工程信任的根本性违背,促使企业用户要求进行正式的账单审计、合同取消和全面的现金退款。
此外,这种不稳定性迫使企业实施昂贵的防御性工程。为了应对不可预测的模型降级,团队被迫构建二次验证回路、运行多模型一致性检查,并部署本地开放权重后备网络。这些补偿措施引入了额外的延迟,推高了内部运营支出,并直接抵消了采用托管前沿模型本应带来的效率提升。
计算服务等级协议能重建信任吗?
当前的抵制标志着生成式 AI 基础设施“蜜月期”的结束。该行业正迅速接近一个必要的转折点,即关于智能的模糊承诺必须被可量化、可验证的性能合同所取代。如果提供商希望留住企业资金,并避免监管机构因欺诈性服务交付而进行的大规模干预,他们必须引入透明的计算服务等级协议(cSLAs)。
在成熟的 cSLA 框架下,对 AI 模型的访问权限将不再仅仅作为原始 Token 的输入和输出数量来出售。相反,合同必须明确规定底层计算的操作参数:保证浮点精度、经过验证的 Token 路由预算、最小 KV 缓存保留阈值以及确定性解码设置。如果基础设施紧急情况迫使提供商限制算力或进行动态量化,系统必须通过 API 元数据明确广播此状态更改。这将允许下游自动化系统暂停执行、推迟非关键任务或将流量重定向到专用的私有集群,而不是盲目地消耗受损的输出。



Comments
No comments yet. Be the first!