In der vergangenen Woche brach in Entwicklerforen, auf unternehmensinternen Kommunikationskanälen und bei internationalen Technologieportalen wie dem in Peking ansässigen 36Kr ein koordinierter Chor der Frustration aus. Softwareingenieure, die produktive Hochdurchsatz-Pipelines, algorithmische Handelssysteme und automatisierte Workflows zur Code-Generierung betreiben, stellten plötzlich eine drastische Verschlechterung der Ausgabequalität führender Frontier-Modelle fest. Prompts, die routinemäßig fehlerfreie, mehrstufige Logik lieferten, halluzinierten plötzlich triviale Syntax; komplexe Kontextverfolgung brach mitten im Prozess zusammen; und Anweisungen befolgende Parameter schienen sich über Nacht aufzulösen. Als sich die Behauptungen verbreiteten, dass die Rechenkapazitäten der Modelle gekürzt worden seien und die tatsächliche Intelligenz abgestürzt sei, stieg die Nachfrage nach Abonnementkündigungen und der Rückerstattung von API-Guthaben in ein beispielloses Ausmaß.
Während Modellanbieter ihre Anpassungen an der Backend-Infrastruktur in Echtzeit nur selten offenlegen, deuten die von globalen Engineering-Teams gemeldeten Symptome auf ein vertrautes, strukturelles Reibungsproblem in der modernen computergestützten Entwicklung hin. Das Problem ist nicht nur, dass ein algorithmisches System einen schlechten Tag hatte. Es stellt vielmehr den Zusammenstoß zwischen der rohen Physik von Hyperscale-Inferenz und der unhaltbaren Ökonomie der Bereitstellung von künstlicher Intelligenz zum Pauschalpreis dar. Wenn tausende automatisierte Systeme gleichzeitig einen zentralisierten Cluster aus spezialisierter Hardware anpingen, muss zwangsläufig etwas nachgeben. Meistens geschieht dieses Nachgeben geräuschlos, verborgen hinter den sauberen Abstraktionen eines API-Endpunkts.
Die Mechanik des nächtlichen Compute-Downgrades
Um zu verstehen, warum ein fortschrittliches Sprachmodell über Nacht einen bedeutenden Teil seiner analytischen Fähigkeiten zu verlieren scheint, muss man über die statischen Gewichte des neuronalen Netzes hinausblicken. In modernen Deep-Learning-Architekturen ist die Nutzererfahrung grundlegend an dynamische Rechenleistung während der Inferenz gebunden. Ein Frontier-Modell ist nicht bloß eine eingefrorene mathematische Matrix auf der Festplatte; es ist ein aktiver Rechenprozess, dessen Ausgabepräzision stark davon abhängt, wie viele Gleitkommaoperationen der Anbieter jedem generierten Token zuweist. Wenn Server-Cluster ihre Kapazitätsgrenzen erreichen, setzen Anbieter aggressive Optimierungstechniken ein, um einen totalen Ausfall zu vermeiden.
Der primäre Hebel bei diesem operativen Balanceakt ist die dynamische Quantisierung. Unter normalen Betriebsbedingungen kann ein hochmodernes Modell Gewichte und Aktivierungen mit 16-Bit- oder 8-Bit-Gleitkommapräzision (FP16 oder FP8) verarbeiten. Wenn jedoch der Unternehmensverkehr sprunghaft ansteigt oder Server-Cluster unter Energieengpässen leiden, können Anbieter die Präzision dynamisch auf 4-Bit-Ganzzahldarstellungen (INT4) senken oder aggressive Methoden zur Gewichtskürzung (Weight Pruning) anwenden. Während eine niedrigbitige Quantisierung bei Smalltalk und einfachen Texten bemerkenswert gut funktioniert, beschädigt sie die subtilen, hochdimensionalen Argumentationspfade, die für komplexe Codesynthese, formale mathematische Logik und Fehlerkorrektur in Grenzfällen erforderlich sind, massiv. Für einen Ingenieur, der auf deterministische Ausführung angewiesen ist, fühlt sich dieser Präzisionsverlust exakt wie eine nächtliche Lobotomie an.
Über die Quantisierung hinaus manipulieren Anbieter häufig die Schichten für spekulative Dekodierung und das Mixture-of-Experts (MoE)-Routing. In einem verteilten MoE-System werden Eingabe-Token basierend auf dem Domänenkontext an spezifische Subnetzwerke weitergeleitet. Unter extremem Rechenstress können Inferenz-Engines die Anzahl der aktiven Experten pro Forward-Pass künstlich drosseln oder die Länge interner spekulativer Generierungsentwürfe einschränken. Darüber hinaus entzieht die Komprimierung des Key-Value (KV)-Cache – bei der der Aufmerksamkeitsverlauf (Attention History) gelöscht oder quantisiert wird, um Speicherbandbreite zu sparen – dem Modell die Fähigkeit, fein granulierte Kontextdetails über umfangreiche Token-Fenster hinweg beizubehalten. Die Gewichte haben sich grundlegend nicht verändert, aber die Rechenmaschine, die sie antreibt, wurde auf einen Bruchteil ihrer beabsichtigten Leistung gedrosselt.
Die harten Realitäten der Rechenzentrumsthermodynamik und Inferenzkosten
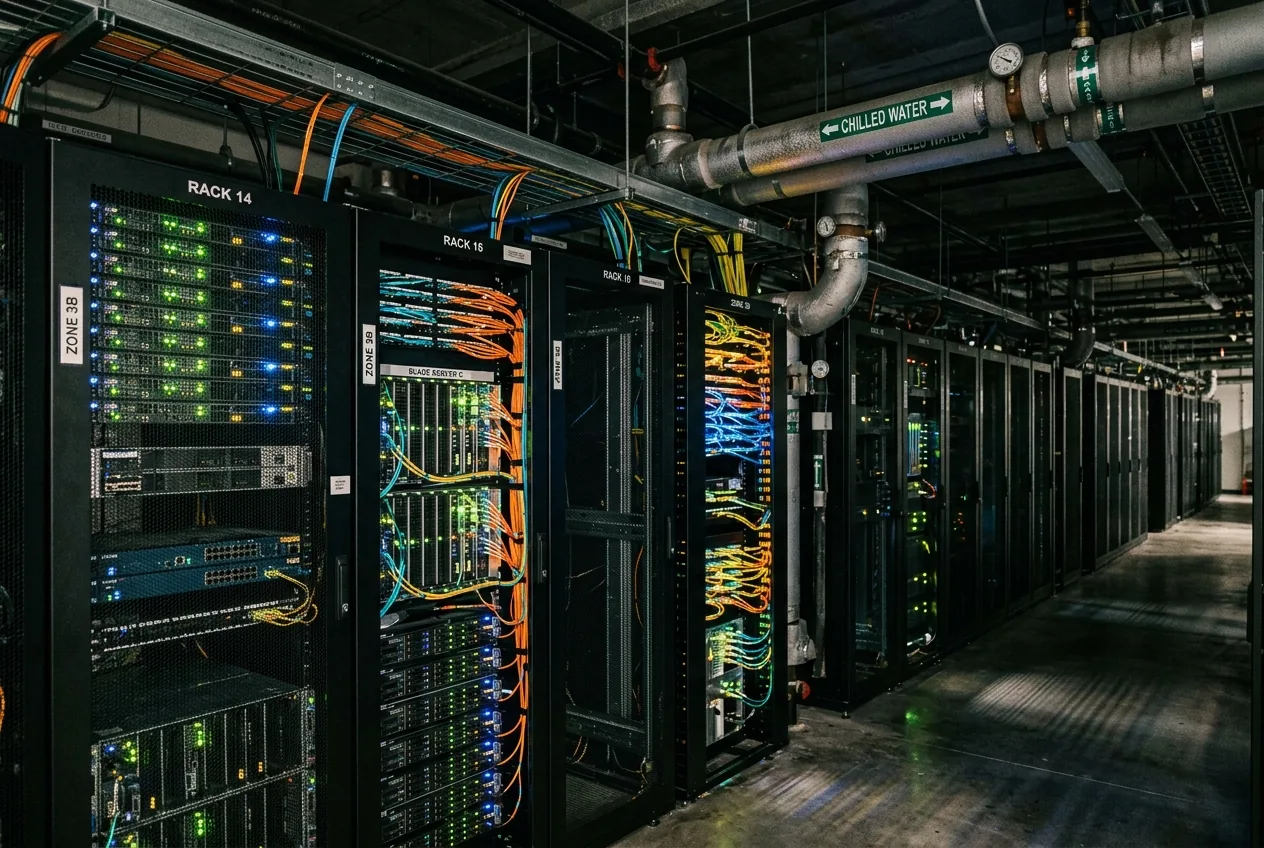
Bei Consumer-Tarifen, die mit bescheidenen zwanzig Dollar pro Monat bepreist sind, kann ein aktiver Power-User leicht Hunderte von Dollar an Rohstrom und Hardware-Abschreibung innerhalb eines dreißigtägigen Abrechnungszyklus verbrauchen. Selbst für kommerzielle API-Nutzer spiegeln die Preisstufen, die während der kompetitiven Eroberungsphasen festgelegt wurden, oft nicht die tatsächlichen Grenzkosten der Spitzenbedarfsberechnung wider. Wenn die Inferenznachfrage die Kapazität des lokalen Stromnetzes übersteigt oder in dichten Server-Racks zu thermischer Drosselung führt, haben Infrastrukturingenieure keine andere Wahl, als Lastabwurf-Algorithmen (Load-Shedding) anzuwenden. In der traditionellen Cloud-Infrastruktur führt Lastabwurf zu Ratenbegrenzungen oder standardmäßigen HTTP-503-Fehlercodes. In der hart umkämpften Welt der generativen KI, in der Verfügbarkeitsmetriken streng geprüft werden, wählen Anbieter oft das kleinere Übel der stillen Verschlechterung: Sie liefern eine minderwertige, rechenschwache Antwort, anstatt gar keine zu liefern.
Die industriellen Kosten unzuverlässiger APIs
In Consumer-Anwendungen ist ein unerwarteter Abfall der Schreibqualität ein geringfügiges Ärgernis. In der industriellen Automatisierung, Robotik und bei unternehmenskritischen Softwarearchitekturen ist es ein inakzeptables Risiko. Moderne Lieferketten und automatisierte Software-Pipelines werden zunehmend auf großen Basismodellen aufgebaut, die Aufgaben wie strukturelle Code-Verifizierung, automatisierte CAD-Übersetzung, Bestandsdispositionsoptimierung und Echtzeit-Sensorikinterpretation übernehmen. Diese Systeme erfordern strikten verhaltensmäßigen Determinismus. Ein maschinelles Werkzeug oder ein automatisiertes Lagergantry-System kann es nicht tolerieren, dass ein unvorhersehbar quantisiertes Vision-Language-Modell eine räumliche Koordinate falsch identifiziert, weil seine Attention-Heads komprimiert wurden, um Serverspeicher freizugeben.
Wenn ein API-Endpunkt wilde, unangekündigte Schwankungen in der Argumentationstiefe aufweist, wird die gesamte darauf aufbauende Architektur instabil. Prinzipien der Hochzuverlässigkeitstechnik basieren darauf, die exakten Toleranzgrenzen jeder Komponente im Stack zu kennen. Würde bei einem tragenden Stahlträger die Streckgrenze während der Zeiten hoher Stahlnachfrage dynamisch halbiert, käme das Bauingenieurwesen zum Erliegen. Dennoch wird von Unternehmenssoftware derzeit erwartet, exakt dieses Paradigma von KI-Anbietern zu tolerieren. Es ist dieser grundlegende Vertrauensbruch gegenüber dem Ingenieurwesen, der Unternehmenskunden dazu veranlasst hat, formale Abrechnungsprüfungen, Vertragskündigungen und umfassende Rückerstattungen zu fordern.
Darüber hinaus zwingt diese Instabilität Unternehmen dazu, teure defensive Technik zu implementieren. Um sich vor unvorhersehbarer Modellverschlechterung zu schützen, sind Teams gezwungen, sekundäre Validierungsschleifen aufzubauen, Konsensprüfungen mit mehreren Modellen durchzuführen und lokale Open-Weight-Fallback-Netzwerke bereitzustellen. Diese Kompensationsmaßnahmen führen zu zusätzlicher Latenz, blähen interne Betriebsausgaben auf und konterkarieren direkt die Effizienzgewinne, die die Einführung gehosteter Frontier-Modelle eigentlich bewirken sollte.
Können Computational Service Level Agreements das Vertrauen wiederherstellen?
Die aktuelle Gegenreaktion markiert das Ende der Flitterwochenphase für die Infrastruktur generativer KI. Die Industrie nähert sich schnell einem notwendigen Wendepunkt, an dem vage Versprechen von Intelligenz durch quantifizierbare, überprüfbare Leistungsverträge ersetzt werden müssen. Wenn Anbieter Unternehmenskapital binden und weitreichende regulatorische Eingriffe bezüglich irreführender Dienstleistungserbringung vermeiden wollen, müssen sie transparente Computational Service Level Agreements (cSLAs) einführen.
Unter einem ausgereiften cSLA-Rahmenwerk würde der Zugang zu einem KI-Modell nicht bloß als Roh-Token-Input und -Output verkauft werden. Stattdessen müssen Verträge explizit die operativen Parameter der zugrunde liegenden Rechenleistung spezifizieren: garantierte Gleitkommapräzision, verifizierte Token-Routing-Budgets, minimale KV-Cache-Aufbewahrungsschwellen und deterministische Dekodierungseinstellungen. Wenn ein Infrastrukturnotfall einen Anbieter dazu zwingt, Rechenleistung zu drosseln oder eine dynamische Quantisierung anzuwenden, muss das System diese Statusänderung explizit über die API-Metadaten kommunizieren. Dies ermöglicht nachgelagerten automatisierten Systemen, die Ausführung zu pausieren, nicht kritische Aufgaben aufzuschieben oder den Datenverkehr auf dedizierte private Cluster umzuleiten, anstatt blind kompromittierte Ausgaben zu konsumieren.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!