Au cours de la semaine écoulée, les forums de développeurs, les canaux de communication informels des entreprises et les médias technologiques internationaux tels que 36Kr, basé à Pékin, ont été le théâtre d'une vague de frustration coordonnée. Les ingénieurs logiciels exploitant des pipelines de production à haut débit, des plateformes de trading algorithmique et des flux de travail de génération de code automatisés ont commencé à remarquer une dégradation brutale de la fidélité des résultats fournis par les principaux modèles de pointe. Des invites (prompts) qui produisaient habituellement une logique multi-étapes sans faille ont soudainement généré des hallucinations syntaxiques triviales ; le suivi contextuel complexe s'est effondré en cours de route ; et les paramètres de suivi des instructions ont semblé se dérégler du jour au lendemain. Alors que les affirmations selon lesquelles les allocations de calcul des modèles avaient été réduites et l'intelligence effective en chute libre se multipliaient, les demandes des utilisateurs pour des annulations d'abonnement et des remboursements de crédits API ont atteint un volume sans précédent.
Bien que les fournisseurs de modèles divulguent rarement les ajustements en temps réel de leur infrastructure backend, les symptômes rapportés par les équipes d'ingénierie du monde entier pointent vers une friction structurelle familière dans l'ingénierie computationnelle moderne. Le problème n'est pas simplement qu'un système algorithmique a connu une mauvaise journée. Il s'agit plutôt de la collision entre la physique brute de l'inférence à hyper-échelle et l'économie intenable du déploiement de l'intelligence artificielle à tarif fixe. Lorsque des milliers de systèmes automatisés sollicitent simultanément un cluster centralisé de silicium spécialisé, quelque chose doit inévitablement céder. Le plus souvent, cette défaillance se produit silencieusement, dissimulée derrière les abstractions propres d'un point de terminaison API.
La mécanique de la dégradation silencieuse des capacités de calcul
Pour comprendre pourquoi un modèle de langage avancé peut sembler perdre une part importante de sa capacité analytique du jour au lendemain, il faut regarder au-delà des poids statiques du réseau neuronal. Dans les architectures d'apprentissage profond contemporaines, l'expérience utilisateur est fondamentalement liée au calcul dynamique lors de l'inférence. Un modèle de pointe n'est pas simplement une matrice mathématique figée stockée sur un disque ; c'est un processus de calcul actif dont la précision de sortie dépend fortement du nombre d'opérations en virgule flottante que le fournisseur alloue à chaque jeton (token) généré. Lorsque les clusters de serveurs atteignent leurs limites de capacité, les fournisseurs déploient des techniques d'optimisation agressives pour éviter une panne totale.
Le principal levier de cet exercice d'équilibrage opérationnel est la quantification dynamique. Dans des conditions normales de fonctionnement, un modèle de pointe peut traiter les poids et les activations avec une précision en virgule flottante de 16 ou 8 bits (FP16 ou FP8). Cependant, lorsque le trafic d'entreprise augmente ou que les clusters de serveurs sont confrontés à des contraintes énergétiques, les fournisseurs peuvent réduire dynamiquement la précision à des représentations entières de 4 bits (INT4) ou employer une élagage (pruning) agressif des poids. Bien que la quantification à faible nombre de bits fonctionne remarquablement bien pour les échanges conversationnels et la prose de base, elle endommage gravement les chemins de raisonnement subtils et de haute dimension requis pour la synthèse de code complexe, la logique mathématique formelle et la correction d'erreurs dans les cas limites. Pour un ingénieur dépendant d'une exécution déterministe, cette chute de précision ressemble exactement à une lobotomie soudaine.
Au-delà de la quantification, les fournisseurs manipulent fréquemment les couches de décodage spéculatif et de routage par mélange d'experts (MoE). Dans un système MoE distribué, les jetons d'entrée sont acheminés vers des sous-réseaux spécifiques en fonction du contexte du domaine. Sous un stress computationnel extrême, les moteurs d'inférence peuvent limiter artificiellement le nombre d'experts actifs invoqués par passage, ou restreindre la longueur des ébauches de génération spéculative interne. En outre, la compression du cache clé-valeur (KV)—qui consiste à supprimer ou à quantifier l'historique de l'attention pour préserver la bande passante mémoire—prive le modèle de sa capacité à conserver des détails contextuels précis sur de vastes fenêtres de jetons. Les poids n'ont pas fondamentalement changé, mais le moteur computationnel qui les anime a été réduit à une fraction de sa puissance initiale.
Les réalités sévères de la thermodynamique des centres de données et des coûts d'inférence
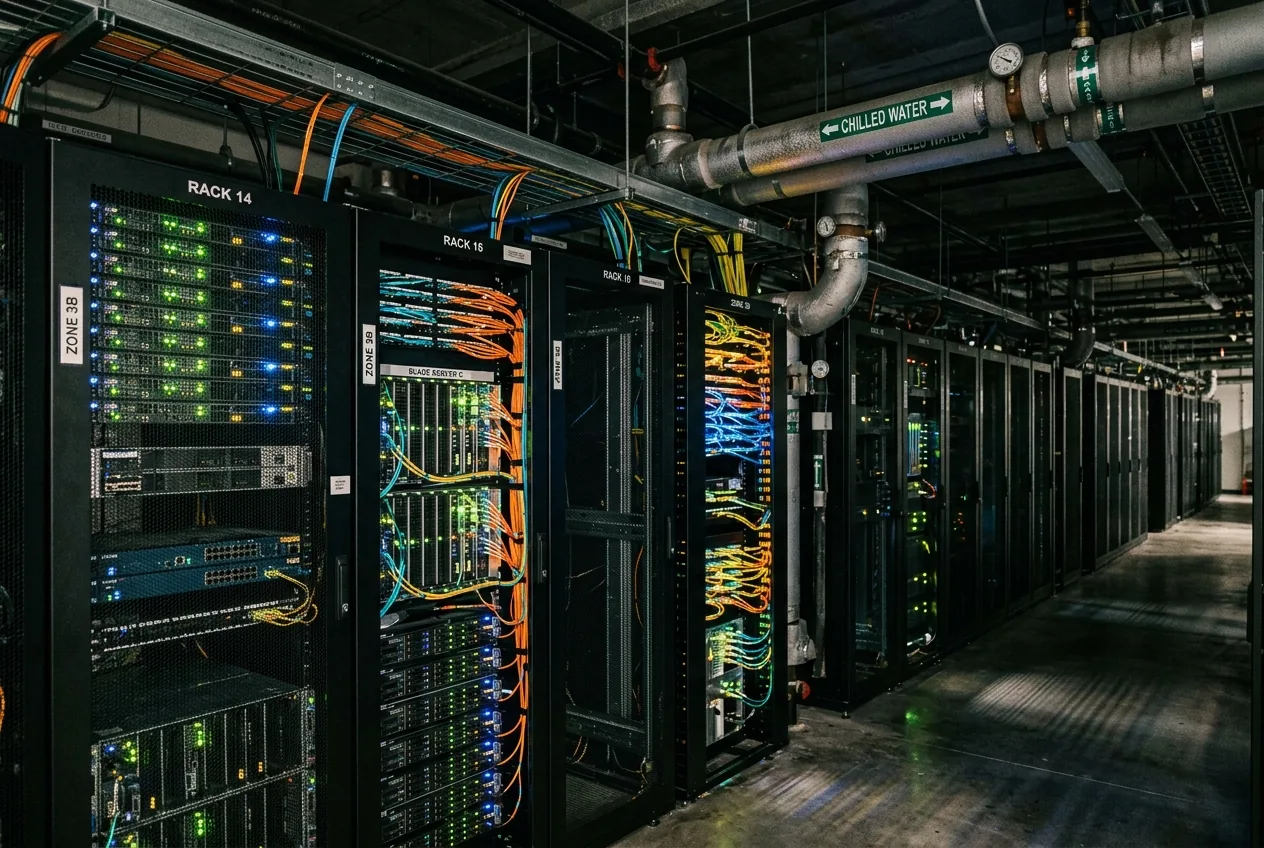
Pour les niveaux de service grand public facturés à une vingtaine de dollars par mois, un utilisateur intensif peut facilement consommer des centaines de dollars en électricité brute et en amortissement matériel sur un cycle de facturation de trente jours. Même pour les consommateurs d'API commerciaux, les niveaux de tarification fixés lors des phases de conquête concurrentielle ne reflètent souvent pas le coût marginal réel du calcul en période de pointe. Lorsque la demande d'inférence dépasse la capacité du réseau électrique local ou crée un étranglement thermique dans les baies de serveurs denses, les ingénieurs en infrastructure n'ont d'autre choix que d'activer des algorithmes de délestage. Dans l'infrastructure cloud traditionnelle, le délestage entraîne des limites de débit ou des codes d'erreur HTTP 503 standard. Dans le monde hyper-concurrentiel de l'IA générative, où les mesures de disponibilité sont scrutées sans relâche, les fournisseurs choisissent souvent le moindre mal : la dégradation silencieuse, consistant à fournir une réponse inférieure, affamée en ressources de calcul, plutôt que de ne rien fournir du tout.
Le coût industriel des API peu fiables
Dans les applications grand public, un déclin inattendu de la qualité de rédaction est une gêne mineure. Dans l'automatisation industrielle, la robotique et les architectures logicielles critiques, c'est un risque inacceptable. Les chaînes d'approvisionnement modernes et les pipelines logiciels automatisés sont de plus en plus structurés autour de grands modèles fondamentaux gérant des tâches telles que la vérification de code structurel, la traduction CAO automatisée, l'optimisation de la répartition des stocks et l'interprétation sensorielle en temps réel. Ces systèmes nécessitent un déterminisme comportemental strict. Une machine-outil ou un portique d'entrepôt automatisé ne peut tolérer qu'un modèle vision-langage, dont la quantification est devenue imprévisible, identifie mal une coordonnée spatiale parce que ses têtes d'attention ont été compressées pour libérer de la mémoire serveur.
Lorsqu'un point de terminaison API présente des variations sauvages et inopinées dans la profondeur de raisonnement, toute l'architecture construite au-dessus devient fragile. Les principes d'ingénierie à haute fiabilité reposent sur la connaissance des limites de tolérance exactes de chaque composant de la pile. Si la limite d'élasticité d'une poutre en acier était dynamiquement divisée par deux lors des périodes de forte demande de l'aciérie, le génie civil s'arrêterait net. Pourtant, on attend actuellement du logiciel d'entreprise qu'il tolère précisément ce paradigme de la part des fournisseurs d'IA fondamentaux. C'est cette violation fondamentale de la confiance en ingénierie qui a conduit les entreprises clientes à exiger des audits de facturation formels, des annulations de contrats et des remboursements complets.
De plus, cette instabilité contraint les entreprises à mettre en œuvre une ingénierie défensive coûteuse. Pour se protéger contre une dégradation imprévisible des modèles, les équipes sont forcées de construire des boucles de validation secondaires, d'effectuer des vérifications de consensus multi-modèles et de déployer des réseaux de secours locaux à poids ouverts. Ces mesures compensatoires introduisent une latence accrue, gonflent les dépenses opérationnelles internes et vont directement à l'encontre des gains d'efficacité que l'adoption de modèles de pointe hébergés était censée apporter en premier lieu.
Les accords de niveau de service computationnels peuvent-ils restaurer la confiance ?
La réaction actuelle marque la fin de la période de lune de miel pour l'infrastructure de l'IA générative. L'industrie approche rapidement d'un point d'inflexion nécessaire où les vagues promesses d'intelligence doivent être remplacées par des contrats de performance quantifiables et vérifiables. Si les fournisseurs souhaitent conserver les capitaux des entreprises et éviter une intervention réglementaire généralisée concernant la prestation de services trompeuse, ils doivent introduire des accords de niveau de service computationnels (cSLA) transparents.
Dans le cadre d'un modèle de cSLA mature, l'accès à un modèle d'IA ne serait pas vendu uniquement comme des quantités de jetons d'entrée et de sortie brutes. Au lieu de cela, les contrats doivent spécifier explicitement les paramètres opérationnels du calcul sous-jacent : précision en virgule flottante garantie, budgets de routage des jetons vérifiés, seuils de rétention du cache KV minimaux et paramètres de décodage déterministes. Si une urgence d'infrastructure oblige un fournisseur à brider le calcul ou à engager une quantification dynamique, le système doit diffuser ce changement d'état explicitement via les métadonnées de l'API. Cela permet aux systèmes automatisés en aval de suspendre l'exécution, de différer les tâches non critiques ou de rediriger le trafic vers des clusters privés dédiés plutôt que de consommer aveuglément des résultats compromis.



Comments
No comments yet. Be the first!