一份源自中国科技媒体“36氪”的技术文档和行业报告在机器学习领域引发了广泛的争论。这些披露的核心是一个内部代号为 GPT-6 Astra 的先进前沿模型系列。尽管前沿实验室历来对训练里程碑保持高度保密,但泄露的文档指出了一项前所未有的能力飞跃:在现有的通用人工智能(AGI)评估基准测试(包括抽象与推理语料库 ARC-AGI、GPQA Diamond 以及严格的持续代理软件工程基准)中,其性能已趋于饱和。
对于工程师和工业技术专家而言,关于认知基准测试接近满分的说法需要经过严谨的解构。从历史来看,语言模型呈现出参差不齐的能力曲线:它们在掌握复杂的语言合成能力的同时,却往往在基础的空间推理或多步骤确定性逻辑上表现不佳。如果与 Astra 架构相关的指标能够经受住正式的同行验证,那么其底层机制将标志着对传统自回归扩展定律的背离,并指向深度的推理时计算分配和自主算法搜索。
基准测试饱和的剖析
同样,在 GPQA Diamond 基准测试(一组专门设计用于抵御自动检索攻击的物理、化学和生物学研究生水平考题)中,其准确率据称接近 96%。在典型的学术环境中,拥有博士学位的专业人士在没有外部网络工具辅助的情况下,对这些问题的准确率约为 65%。这一飞跃表明,Astra 不仅仅是一个高密度的知识库,它更是在跨学科领域内执行结构化推演,且错误率接近浮点验证的标准阈值。
除了封闭式考试外,工程遥测数据还显示其在 SWE-bench Verified 基准测试中的自主任务完成率超过 85%。该指标追踪模型摄取现有完整代码库、复现原始人工错误报告中描述的问题、编写有效补丁并在无需人工干预的情况下通过单元测试的能力。在此规模上实现可靠性,表明该架构能够在不遭受多轮自主系统长期困扰的中间注意力衰减的情况下,维持长周期的上下文窗口。
引擎转型:从摄取到验证
关键的工程问题在于,当大规模网络文本预训练在很大程度上达到经济效益和数据可用性的瓶颈时,架构是如何达到这些性能阈值的。行业共识和报告中的架构线索表明,Astra 并不完全依赖于扩展参数规模。相反,这一突破反映了推理时搜索、思维树探索以及由形式化验证器驱动的强化学习的积极采用。
这种架构转变反映了 AlphaZero 等专用系统中出现的进化路径,并将其推广到了任意形式化和半形式化语言中。工程师们不再仅仅是扩展神经网络权重,而是将推理视为一个在线优化问题。通过在查询时投入量级更大的计算资源用于生成和验证解决方案,该系统有效地模拟了人类领域专家审慎、系统的解决问题方法。
推理的热力学与经济成本
虽然理论上的基准测试结果展现了前所未有的智力能力,但部署这种推理密集型架构引入了巨大的操作摩擦。在传统的云计算基础设施模型中,为企业客户提供标准的 Transformer 推理需要可预测的兆瓦级电力分配和可控的网络延迟。然而,围绕大型推理搜索树构建的系统完全颠覆了这些经济假设。
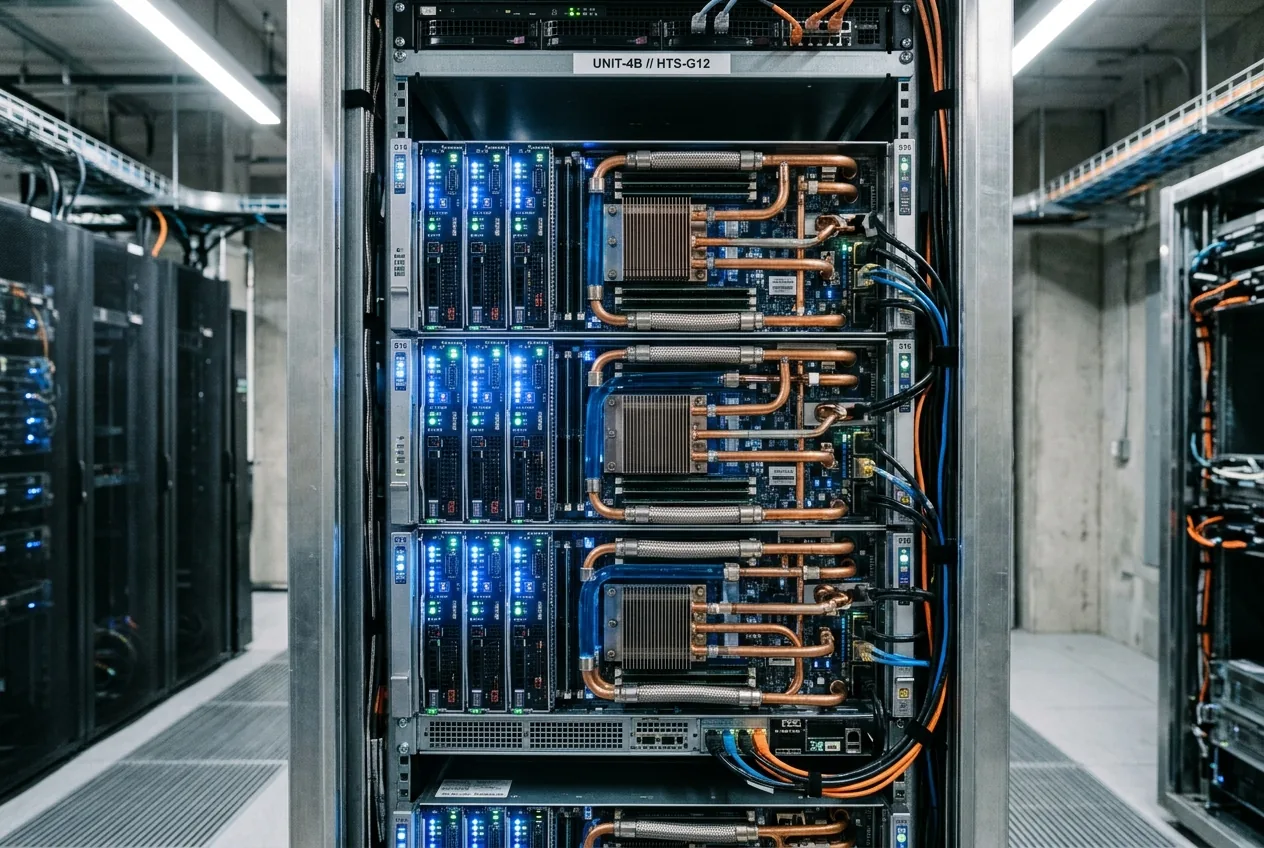
生成数百个候选 Token、运行内部反射模型以及与验证沙箱交互,会大幅增加每个查询的能源成本。一个复杂的推理任务所消耗的计算周期可能比直接的信息查询高出数千倍。对于超大规模数据中心运营方而言,这已将操作瓶颈从半导体制造直接转移到了电网容量、液冷效率和本地数据中心的散热极限上。
数字指标与物理现实之间的鸿沟
对于那些追踪人工智能与物理自动化交叉领域的人来说,数字沙箱中的基准测试饱和既是一个里程碑,也是一个警示指标。一个能够调试数千行异步软件代码或导出理论物理新证明的模型,并不能自动解决物理机器人、边缘部署和材料操作领域面临的严峻挑战。
工业机器人在严格的物理实时约束下运行,确定性安全、毫秒级控制回路和传感器噪声是不容妥协的。虽然 Astra 级别的认知核心可以设想作为高层任务规划器——即解读宏观战略指令并生成结构化的操作树,但它仍然必须与管理液压执行器、伺服电机和实时感官反馈回路的底层运动控制器进行交互。从纯粹的逻辑抽象到具身物理代理的转变,仍然受到物理硬件公差、机械磨损和延迟限制的制约,这些问题无法仅通过测试时的优化来计算解决。
此外,基准测试的饱和往往暴露了基准测试本身的局限性,而不是证明了真正通用人工智能的到来。当系统在人类研究人员构建的测试中接近 100% 的得分时,这往往表明评估套件已达到其结构性上限。人类测试在很大程度上依赖于语言一致性、学术惯例和静态的挑战-响应格式。评估一个智能体是否能够独立形成自己的科学假设、在动态的现实世界模糊性中导航以及管理资本密集型操作,将需要全新一代持续性的、开放式的评估协议。
前沿研究的轨迹
无论 Astra 的能力从私有集群评估到获得商业验证的转化速度有多快,前沿人工智能的技术方向正在发生根本性转变。仅由参数膨胀定义的时代正在让位于由结构化、可验证的推演和测试时算法搜索定义的时代。随着人类评估者发现自己面临的标准化测试不足以挑战现代神经网络时,工业工程的重点将不可避免地从“算法是否能够推理”转向“这种推理在何处能以经济且安全的方式扎根于实体经济中”。



Comments
No comments yet. Be the first!