Die Ära, in der ein großes Flaggschiff-Sprachmodell als monolithischer „One-Size-Fits-All“-API-Endpunkt behandelt wurde, geht still und leise zu Ende. Mit der allgemeinen Einführung von GPT-5.6 hat sich das Ökosystem hin zu einer expliziten dreigliedrigen Architektur verschoben: Sol, Terra und Luna. Anstatt bei jeder Abfrage – ungeachtet der Komplexität – ein undifferenziertes Billionen-Parameter-Monster durch die Pipeline zu schicken, formalisiert dieses Release, was Hardware-Ingenieure und Systemarchitekten seit Jahren fordern: eine strukturelle Staffelung, die auf thermischen Budgets, Latenzanforderungen und realen Bereitstellungskosten basiert.
Für die industrielle Automatisierung und das verteilte Rechnen stellt diese Veröffentlichung mehr als nur eine inkrementelle Steigerung der Benchmarks dar. Sie markiert die bewusste Anerkennung, dass das Rechenprofil, das für hochgradiges generatives Schlussfolgern bei komplexen technischen Schaltplänen benötigt wird, grundsätzlich inkompatibel mit der unter 50 Millisekunden liegenden Ausführungsschleife ist, die in einer Fertigungshalle oder auf einer autonomen Logistikplattform erforderlich ist. Durch die Aufteilung der Architektur in drei dedizierte Ebenen versucht GPT-5.6, die hartnäckige Kluft zwischen zentraler Cloud-Logik und deterministischer Ausführung vor Ort zu überbrücken.
Die strukturelle Anatomie von Sol, Terra und Luna
Die Flaggschiff-Variante Sol repräsentiert die unbeschnittene Grenze der GPT-5.6-Architektur. Sol wurde speziell für Hyperscale-Rechenzentren mit dichten, flüssigkeitsgekühlten Beschleuniger-Clustern entwickelt und bewältigt Synthesen mit maximalem Kontext, komplexe multimodale physikalische Berechnungen und mehrstufiges symbolisches Schlussfolgern. Es arbeitet mit der höchsten Parameterdichte und den größten Anforderungen an die Speicherbandbreite innerhalb der Familie und dient als grundlegendes Modell, von dem seine kleineren Geschwister per Downstream-Destillation abgeleitet werden. In Testumgebungen zeigt Sol erhebliche Zuwächse bei der langfristigen Planung, der Codesynthese über ausgedehnte Altsysteme hinweg und der nichtlinearen Logikprüfung, was es zur primären Engine für technische Analysen auf hohem Niveau und die Designgenerierung macht.
Terra besetzt die mittlere Unternehmensebene und ist als ausbalanciertes Arbeitstier mit hohem Durchsatz konzipiert, das für private Cloud-Bereitstellungen, unternehmenseigene Server-Racks und skalierbare API-Pipelines ausgelegt ist. Terra behält den Großteil des betrieblichen Verständnisses von Sol bei, entfernt jedoch den Rechenaufwand, der mit speziellen, hochtheoretischen Grenzfällen verbunden ist. Dank eines aggressiven Mixture-of-Experts (MoE)-Routing-Schemas aktiviert Terra pro Token nur einen Bruchteil seiner gesamten Parameteranzahl, was die Inferenzkosten und den Speicherverbrauch drastisch senkt. Es ist auf kontinuierliche industrielle Abläufe zugeschnitten – von der Ressourcenplanung und automatisierten Telemetriediagnose bis hin zur dynamischen Lieferkettensteuerung und hochfrequenten Softwareüberprüfung.
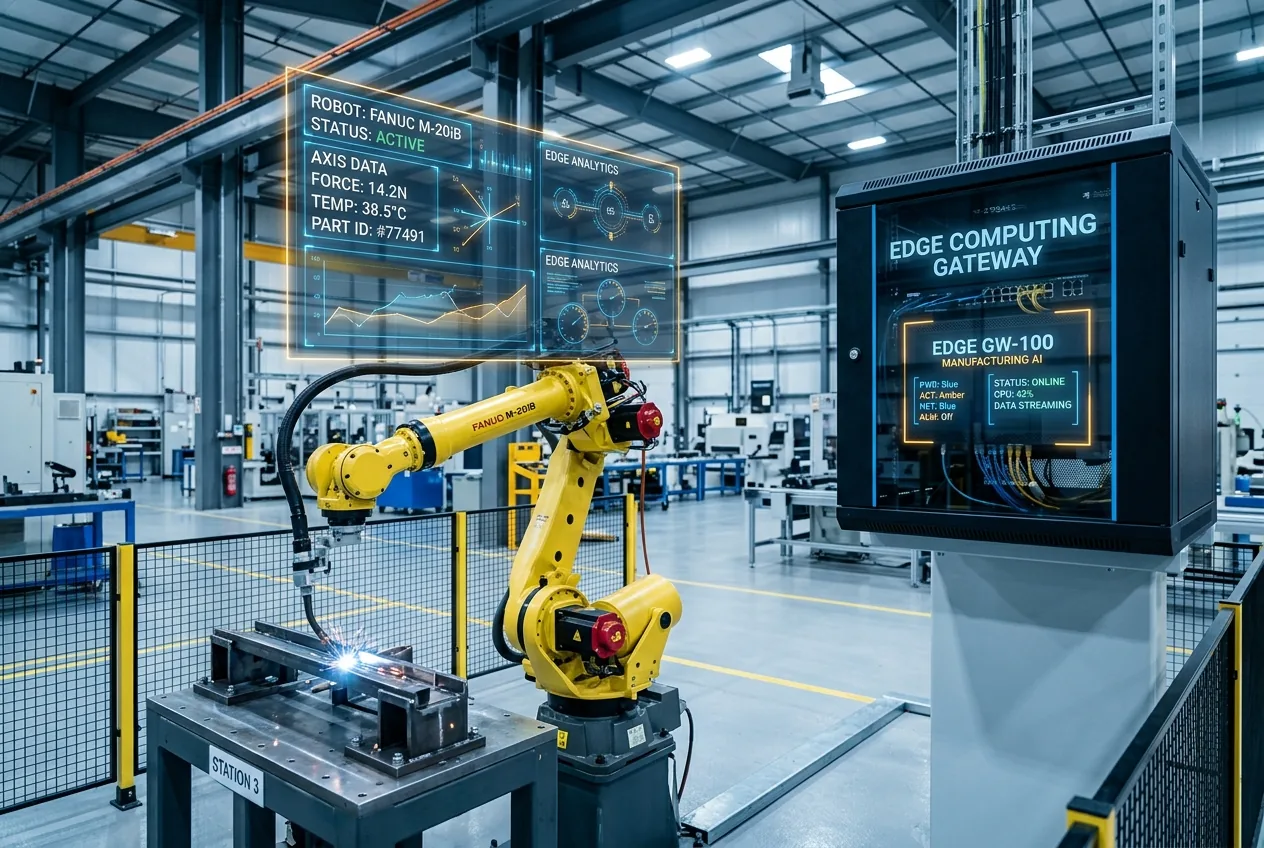
Das disruptivste Mitglied der Familie ist Luna, eine kompakte, radikal beschnittene und quantisierte Variante, die explizit für Edge-Hardware und lokale Ausführung mit geringer Latenz entwickelt wurde. Luna läuft problemlos innerhalb der begrenzten Speicherfootprints von eingebetteten Systemen, Industrie-PCs und robotergestützten Rechenplattformen und kann vollständig ohne aktive Internetverbindung direkt auf dem Gerät ausgeführt werden. Indem Luna die Zeit bis zum ersten Token und nahezu deterministische Antwortlatenzen priorisiert, reduziert es das Grenzmodell auf seinen operativen Kern und konzentriert sich auf die direkte Aufgabenausführung, die lokale Sensorfusion und die unmittelbare Verarbeitung natürlichsprachlicher Anweisungen.
Überbrückung der Latenzlücke in cyber-physischen Systemen
Im Maschinenbau und in der industriellen Robotik ist Latenz nicht nur ein Ärgernis, sondern ein striktes Sicherheitskriterium. Eine Roboterzelle, die einen Gelenkarm steuert, kann nicht 800 Millisekunden darauf warten, dass ein Cloud-Modell ein Inferenz-Token zurückgibt, während ein Förderband sich mit zwei Metern pro Sekunde bewegt. Herkömmliche große Sprachmodelle hatten Schwierigkeiten, in die physische Betriebstechnologie einzudringen, da nicht-deterministisches Netzwerk-Jitter und unvorhersehbare Warteschlangen inakzeptable Betriebsrisiken darstellen.
Diese strukturelle Aufteilung ermöglicht es Luna, als lokaler Übersetzer und Supervisor zu fungieren, während Terra oder Sol asynchron im Hintergrund arbeiten. Tritt eine unerwartete Vibrationsanomalie in einer CNC-Spindel auf, kann Luna die transienten Telemetriedaten sofort markieren, mit lokalen Maschinenparametern abgleichen und den Vorschub drosseln. Gleichzeitig wird das rohe Telemetriepaket zur unternehmensweiten Vergleichsanalyse an Terra gesendet, wodurch sichergestellt wird, dass unmittelbare physische Abläufe niemals durch Cloud-Roundtrip-Zeiten verzögert werden.
Das ökonomische Kalkül skalierter Inferenz
Über die technischen Hardware-Einschränkungen hinaus haben die wirtschaftlichen Aspekte kontinuierlicher Inferenz in Unternehmen die Infrastrukturteams an einen Wendepunkt gebracht. Das Abfragen eines monolithischen Top-Tier-Modells für banale, hochfrequente Aufgaben – wie das Parsen strukturierter JSON-Payloads, das Validieren von API-Eingaben oder das Transkribieren von Telemetriemetriken – verbraucht Kapital in einem unhaltbaren Tempo. Die Token-Ökonomie im großen Maßstab erfordert, dass die Rechenkosten proportional zum wirtschaftlichen Wert der spezifischen Abfrage stehen.
Darüber hinaus führt das GPT-5.6-Rollout dynamische Modell-Routing-Protokolle ein, die eine nahtlose Übergabe zwischen Luna, Terra und Sol ermöglichen. Ein Edge-Gateway mit Luna kann Routine-Sensorprotokolle unbegrenzt ohne Grenzkosten für die API verarbeiten. In dem Moment, in dem das lokale Modell eine komplexe Anomalie erkennt, die seinen internen Vertrauensschwellenwert überschreitet, kann es den kontextuellen Trace verpacken und das Problem zur Zwischendiagnose an Terra eskalieren. Identifiziert Terra einen strukturellen Systemfehler, der tiefgreifendes kausales Denken erfordert, wird die Aufgabe an Sol weitergeleitet. Diese hierarchische Pipeline stellt sicher, dass Spitzenrechenleistung nur dann verbraucht wird, wenn sie aufgrund der Komplexität zwingend erforderlich ist.
Hardware-Optimierung und lokaler Edge-Einsatz
Die technischen Durchbrüche, die Luna auf lokaler Hardware lebensfähig machen, stützen sich maßgeblich auf Fortschritte bei der Low-Bit-Quantisierung und dem spezialisierten Weight-Caching. In der Vergangenheit führte die Komprimierung eines Modells auf 4-Bit- oder 3-Bit-Präzision zu einer drastischen Verschlechterung der logischen Konsistenz und syntaktischen Kohärenz. Die im Destillationsprozess von GPT-5.6 angewandten Quantisierungstechniken bewahren die strukturelle Logik, indem sie bei kritischen Attention-Heads eine höhere Präzision beibehalten, während lineare Feed-Forward-Schichten aggressiv komprimiert werden.
Diese Optimierung spiegelt direkt die Hardware-Beschränkungen industrieller Umgebungen wider. In einem sauberen, klimatisierten Hyperscale-Rechenzentrum kaschieren High-Bandwidth-Memory (HBM) und Flüssigkeitskühlungen Ineffizienzen. In einer Fabrikhalle sind Recheneinheiten in versiegelten, lüfterlosen NEMA-Gehäusen untergebracht, die Staub, Ölnebel und Umgebungstemperaturen von über 40 Grad Celsius standhalten müssen. In diesen Gehäusen ist die Wärmeableitung der harte limitierende Faktor. Ein Modell, das übermäßig viel Speicherbandbreite verbraucht, erzeugt Wärme, die Edge-Hardware schlicht nicht abführen kann.
Kann dynamisches Multi-Tier-Routing in der Produktion stabil bleiben?
Während die architektonische Trennung in Sol, Terra und Luna grundlegende Rechen- und Latenzprobleme löst, führt sie eine neue Kategorie von Ingenieursrisiken ein: systemische Routing-Instabilität. Wenn ein Enterprise-Software-Stack auf einem einzigen monolithischen Modell basiert, sind die Betriebsparameter, Fehlerzustände und Denkstile relativ einheitlich. Die Aufteilung dieser Intelligenz auf drei separate Modelle mit stark unterschiedlichen Parameterskalen bedeutet, dass sich das Systemverhalten unerwartet ändern kann, je nachdem, welche Ebene die Anfrage bearbeitet.
Das Hauptanliegen von Systemingenieuren ist das Risiko nicht-deterministischer kaskadierender Fehler. Wenn eine lokale Instanz von Luna einen anomalen Messwert falsch interpretiert und es versäumt, den Kontext an Terra zu eskalieren, wird die übergeordnete Reasoning-Engine niemals die Chance erhalten, einzugreifen. Umgekehrt: Sind die Eskalationsschwellen von Luna zu aggressiv eingestellt, kann ein Edge-Netzwerk die Cloud-Ebene leicht mit unnötigen Abfragen fluten und so genau die Latenzspitzen und API-Kostenexplosionen wieder einführen, die die Architektur eigentlich eliminieren sollte.
Zusätzlich stellt die semantische Drift zwischen den Ebenen eine große Herausforderung für Tests dar. Ein Prompt, der auf eine deterministische, maschinenlesbare Ausgabe von Sol ausgelegt ist, könnte bei der Ausführung auf Terra subtile syntaktische Fehler erzeugen oder unter Lunas komprimiertem Attention-Fenster vollständig versagen. Ingenieurteams, die GPT-5.6 einsetzen, werden erhebliche Ressourcen darauf verwenden müssen, nicht nur einzelne Modelle, sondern die gesamte Multi-Tier-Arbitrierungs-Pipeline zu testen, um sicherzustellen, dass Kontext-Übergaben über die Grenze zwischen physischer Welt und Cloud hinweg hermetisch bleiben.
Ein reifender Pfad für angewandte künstliche Intelligenz
Die Veröffentlichung von GPT-5.6 und ihrem dreigliedrigen Framework spiegelt eine Technologie wider, die ihre spekulative Brute-Force-Wachstumsphase hinter sich lässt und in eine Ära pragmatischer Systemtechnik eintritt. In den vergangenen Jahren war der Wettlauf durch eine einseitige Parameterausweitung geprägt – der Bau immer größerer Rechencluster, um immer größere Modelle zu trainieren und höhere Werte bei abstrakten akademischen Benchmarks zu erzielen. Doch rohe Intelligenz im luftleeren Raum ist für die physischen Industrien, die die Weltwirtschaft antreiben, von begrenztem Nutzen.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!