将旗舰级大型语言模型视为“一体化”、“一刀切”式 API 端点的时代正在悄然终结。随着 GPT-5.6 的全面发布,整个生态系统已转向一种明确的三方架构:Sol、Terra 和 Luna。此版本不再盲目地将千亿参数的庞然大物推向每一个不计任务复杂度的查询管道,而是将硬件工程师和系统架构师多年来梦寐以求的需求进行了规范化:构建基于热能限制、延迟预算和实际部署成本的分层架构。
对于工业自动化和分布式计算而言,此次发布不仅是基准测试的微小提升,更是对其核心理念的明确认可:在复杂工程图纸上进行高级生成式推理所需的计算配置,与制造车间或自主物流平台所需的 50 毫秒以内执行循环本质上是不兼容的。通过将架构拆分为三个专用层级,GPT-5.6 试图弥合中央云端推理与现场确定性执行之间那道顽固的鸿沟。
Sol、Terra 和 Luna 的结构剖析
旗舰版本 Sol 代表了 GPT-5.6 架构不受限制的前沿。Sol 专为配备高密度液冷加速器集群的超大规模数据中心而设计,能够处理最大上下文合成、复杂的各种模态物理计算以及多步符号推理。它在该系列中拥有最高的参数密度和内存带宽需求,并作为下游模型(即其较小的兄弟版本)的蒸馏基础。在测试环境中,Sol 在长程规划、跨大型遗留代码库的代码合成以及非线性逻辑验证方面表现出显著提升,使其成为高级技术分析和设计生成的首选引擎。
Terra 占据企业中层,是一个高吞吐量、平衡型的“工作马”,专为私有云部署、企业级机房服务器和可扩展 API 管道而设计。Terra 保留了 Sol 的绝大部分运行理解能力,同时去除了与小众、高度理论化的边缘案例相关的计算开销。Terra 采用激进的混合专家(MoE)路由方案,每个 Token 仅激活其总参数的一小部分,从而大幅降低了推理成本和内存消耗。它专为持续工业运营而量身定制,可处理企业资源规划、自动遥测诊断、动态供应链路由和高频软件验证。
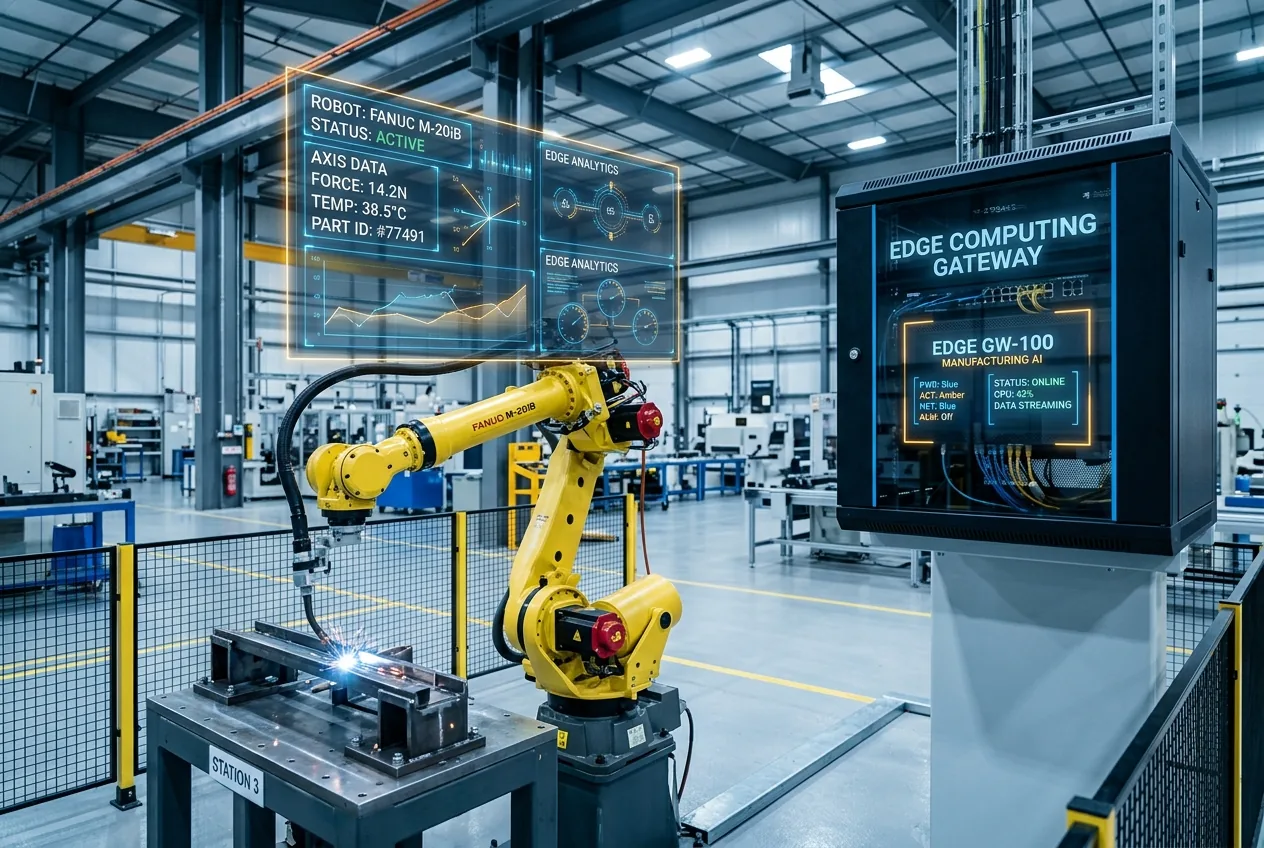
该系列中最具颠覆性的是 Luna,这是一个紧凑、经过深度剪枝和量化的版本,专门为边缘硬件和低延迟本地执行而构建。Luna 可以在嵌入式系统、工业 PC 和机器人计算平台的有限内存空间内流畅运行,无需实时联网即可在设备端完全执行。通过优先考虑“首次标记时间”(Time-to-first-token)指标和近乎确定的响应延迟,Luna 将前沿模型精简至其运营核心,专注于直接任务执行、本地传感器融合解释以及即时自然语言指令解析。
弥合信息物理系统中的延迟差距
在机械工程和工业机器人技术中,延迟不仅仅是不便,更是严格的安全约束。当传送带以每秒两米的速度运行时,运行机械臂的工业工作站无法等待云端托管的前沿模型返回 800 毫秒的推理结果。传统的大型语言模型难以深入物理运行技术领域,因为非确定性的网络抖动和不可预测的排队时间会引入无法接受的运营风险。
这种结构性划分使得 Luna 可以作为本地翻译官和监督者运行,而 Terra 或 Sol 则在后台异步工作。如果数控机床主轴发生异常振动,Luna 可以立即标记瞬态遥测数据,将其与本地机器参数进行交叉比对,并降低进给速度。同时,原始遥测数据包会被发送到上游的 Terra 进行全车队范围的比较分析,确保即时的物理操作永远不会因云端往返时间而受阻。
规模化推理的经济核算
除了硬件技术约束外,持续的企业级推理经济性已将基础设施团队逼向临界点。对于解析结构化 JSON 负载、验证 API 输入或转录遥测指标等日常高频任务,查询单一的顶级模型会以不可持续的速度消耗资本。规模化 Token 经济要求计算成本必须与特定查询的经济价值成比例。
此外,GPT-5.6 的发布引入了动态模型路由协议,允许在 Luna、Terra 和 Sol 之间实现无缝切换。运行 Luna 的边缘网关可以无限期地处理常规传感器日志,且边际 API 成本为零。一旦本地模型检测到超出其内部置信度阈值的复杂异常,它便可以打包上下文追踪信息,并将问题升级到 Terra 进行中间诊断。如果 Terra 确定存在需要深度因果推理的结构性系统缺陷,任务则会进一步升级到 Sol。这种分层管道确保了仅在真正需要最高复杂性时才消耗顶级算力。
硬件优化与本地边缘部署
使 Luna 能够在本地硬件上运行的工程突破,很大程度上依赖于低位量化和专用权重缓存技术的进步。过去,将模型压缩到 4 位或 3 位精度会导致推理一致性和句法连贯性的严重性能退化。GPT-5.6 蒸馏过程中应用的量化技术通过在关键注意力头保持更高精度,同时对线性前馈层进行激进压缩,从而保留了结构逻辑。
这种优化直接反映了工业环境的硬件局限性。在清洁、恒温的超大规模数据中心中,高带宽内存(HBM)和液冷循环可以掩盖效率低下。但在工厂车间,计算单元被封闭在密封、无风扇的 NEMA 级机箱中,旨在抵御灰尘、油雾和超过 40 摄氏度的环境温度。在这些机箱中,散热是硬性上限。消耗过多内存带宽的模型产生的热量,是边缘硬件根本无法排出的。
动态多层路由在生产中能否保持稳定?
虽然将架构划分为 Sol、Terra 和 Luna 解决了基本的计算和延迟挑战,但它也引入了一类新的工程风险:系统性路由不稳定。当企业软件栈依赖单一的单体模型时,运营参数、故障模式和推理风格相对统一。将这种智能划分为三个参数规模迥异的模型,意味着系统行为可能会根据处理请求的层级发生意想不到的变化。
系统工程师的首要担忧是确定性连锁故障。如果本地的 Luna 实例误解了异常读数且未能将上下文升级给 Terra,上层推理引擎将永远无法介入。相反,如果 Luna 的升级阈值调整得过于激进,边缘网络很容易用不必要的查询淹没云端层级,从而重新引发该架构旨在消除的网络延迟激增和 API 成本爆炸问题。
此外,各层级之间的语义漂移也提出了严格的测试挑战。一个旨在从 Sol 获取确定性机器可读输出的提示词,在 Terra 上执行时可能会产生细微的句法错误,或者在 Luna 的压缩注意力窗口下完全失效。部署 GPT-5.6 的工程团队不仅需要投入大量资源对单个模型进行基准测试,还需要对整个多层仲裁管道进行测试,以验证上下文切换在物理与云端边界之间保持严密。
应用人工智能的成熟之路
GPT-5.6 及其三方架构的发布,标志着技术正在走出投机性的暴力增长阶段,进入实用系统工程时代。过去几年,技术竞赛的特征是盲目的参数扩张——构建更大的计算集群来训练更大的模型,以在抽象的学术基准测试中获得更高的分数。但在真空中获得的原始智能,对于驱动全球经济的实体产业而言,其用处极其有限。



Comments
No comments yet. Be the first!