L'ère où l'on considérait un grand modèle de langage phare comme un point de terminaison d'API monolithique et universel touche discrètement à sa fin. Avec le déploiement généralisé de GPT-5.6, l'écosystème s'est orienté vers une architecture tripartite explicite : Sol, Terra et Luna. Plutôt que d'imposer un modèle indifférencié d'un billion de paramètres à chaque pipeline de requête, indépendamment de la complexité de la tâche, cette version formalise ce que les ingénieurs matériels et les architectes systèmes réclament depuis des années : une hiérarchisation structurelle conçue en fonction des enveloppes thermiques, des budgets de latence et des coûts de déploiement dans le monde réel.
Pour l'automatisation industrielle et l'informatique distribuée, cette version représente bien plus qu'une simple amélioration incrémentale des performances. Elle marque la reconnaissance intentionnelle que le profil de calcul nécessaire pour exécuter un raisonnement génératif de haut niveau sur des schémas d'ingénierie complexes est fondamentalement incompatible avec la boucle d'exécution inférieure à 50 millisecondes requise sur un site de fabrication ou une plateforme logistique autonome. En scindant l'architecture en trois niveaux dédiés, GPT-5.6 tente de combler le fossé persistant entre le raisonnement centralisé dans le cloud et l'exécution déterministe sur le terrain.
L'anatomie structurelle de Sol, Terra et Luna
La variante phare, Sol, représente la frontière sans contrainte de l'architecture GPT-5.6. Conçue exclusivement pour les centres de données hyperscale équipés de clusters d'accélérateurs denses refroidis par liquide, Sol gère la synthèse contextuelle maximale, les calculs physiques multimodaux complexes et le raisonnement symbolique en plusieurs étapes. Il fonctionne avec la densité de paramètres et les exigences de bande passante mémoire les plus élevées de la famille, servant de modèle fondamental à partir duquel ses petits frères sont distillés. Dans les environnements de test, Sol démontre des gains significatifs en planification à long terme, en synthèse de code sur des bases de code complexes et en vérification logique non linéaire, ce qui en fait le moteur principal pour l'analyse technique de haut niveau et la génération de conceptions.
Terra occupe le niveau intermédiaire de l'entreprise, configuré comme un cheval de bataille équilibré à haut débit conçu pour les déploiements de cloud privé, les serveurs d'entreprise sur site et les pipelines API évolutifs. Terra conserve la majeure partie de la compréhension opérationnelle de Sol tout en éliminant la surcharge computationnelle associée aux cas limites théoriques très spécifiques. Conçu avec un schéma de routage par mélange d'experts (MoE) agressif, Terra n'active qu'une fraction de son nombre total de paramètres par jeton (token), réduisant considérablement les coûts d'inférence et la consommation de mémoire. Il est adapté aux opérations industrielles continues : planification des ressources d'entreprise, diagnostics de télémétrie automatisés, routage dynamique de la chaîne d'approvisionnement et vérification logicielle à haute fréquence.
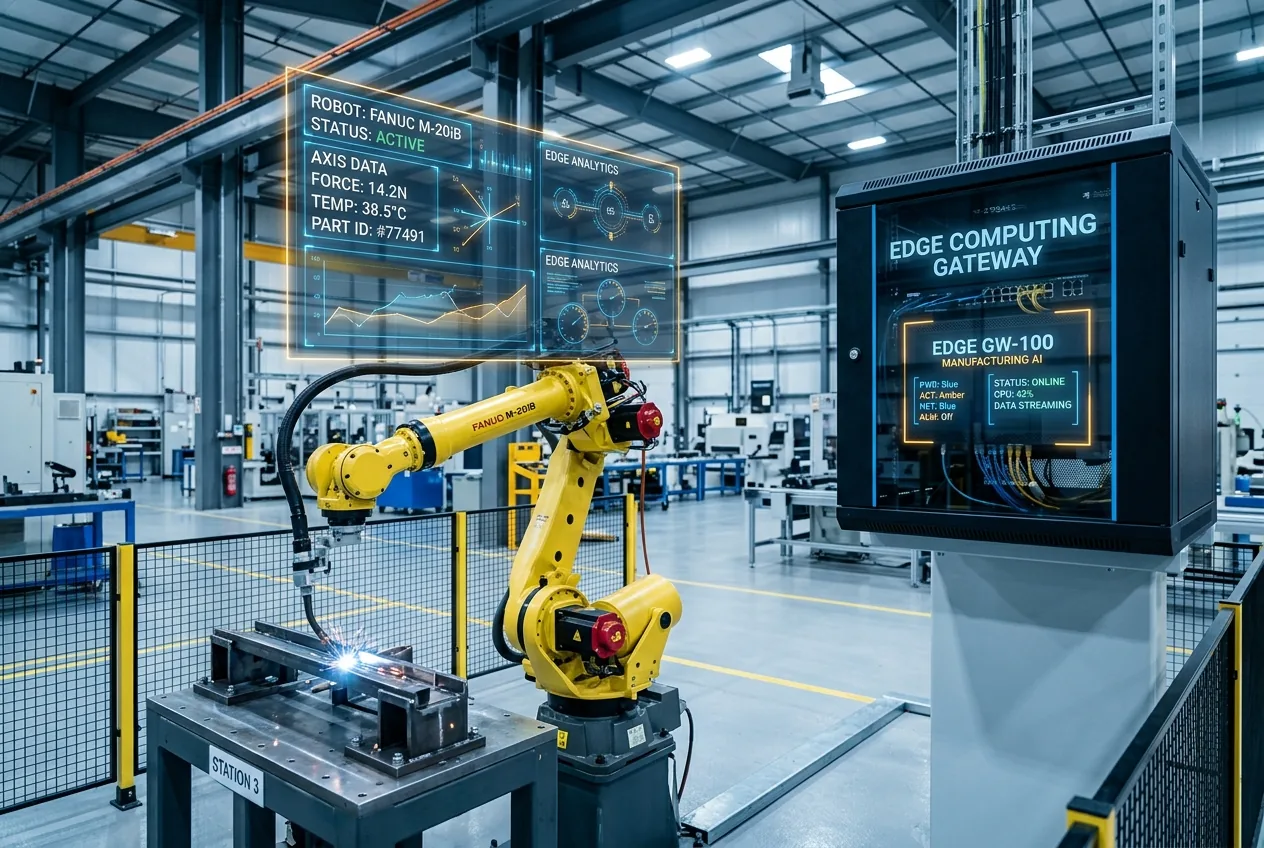
Le membre le plus disruptif de la famille est Luna, une variante compacte, radicalement élaguée et quantifiée, conçue explicitement pour le matériel en périphérie (edge) et l'exécution locale à faible latence. S'exécutant confortablement dans les limites de mémoire des systèmes embarqués, des PC industriels et des plateformes de calcul robotiques, Luna peut fonctionner entièrement sur l'appareil sans liaison active. En donnant la priorité à des mesures rapides de « temps jusqu'au premier jeton » et à des latences de réponse quasi déterministes, Luna réduit le modèle frontal à son noyau opérationnel, se concentrant sur l'exécution directe des tâches, l'interprétation de la fusion de capteurs locaux et l'analyse immédiate des instructions en langage naturel.
Combler le fossé de latence dans les systèmes cyber-physiques
En génie mécanique et en robotique industrielle, la latence n'est pas seulement un inconvénient ; c'est une contrainte de sécurité stricte. Une cellule de travail robotisée exploitant un bras articulé ne peut pas attendre 800 millisecondes qu'un modèle frontal hébergé dans le cloud renvoie un jeton d'inférence pendant qu'un tapis roulant avance à deux mètres par seconde. Les grands modèles de langage traditionnels ont eu du mal à pénétrer la technologie opérationnelle physique car la gigue réseau non déterministe et les temps d'attente imprévisibles introduisent un risque opérationnel inacceptable.
Cette division structurelle permet à Luna d'agir en tant que traducteur et superviseur local, tandis que Terra ou Sol fonctionnent de manière asynchrone en arrière-plan. Si une anomalie de vibration inattendue se produit dans une broche CNC, Luna peut signaler instantanément les données de télémétrie transitoires, les recouper avec les paramètres locaux de la machine et ralentir la vitesse d'avance. Pendant ce temps, le paquet de télémétrie brut est envoyé en amont à Terra pour une analyse comparative à l'échelle de la flotte, garantissant que les opérations physiques immédiates ne sont jamais otages des temps d'aller-retour vers le cloud.
Le calcul économique de l'inférence à grande échelle
Au-delà des contraintes matérielles techniques, l'économie de l'inférence d'entreprise continue a poussé les équipes d'infrastructure vers un point de rupture. Interroger un modèle monolithique de premier plan pour des tâches banales et à haute fréquence — comme l'analyse de charges utiles JSON structurées, la validation d'entrées API ou la transcription de métriques de télémétrie — consomme du capital à un rythme insoutenable. L'économie des jetons à grande échelle exige que les coûts de calcul soient proportionnels à la valeur économique de la requête spécifique traitée.
De plus, le déploiement de GPT-5.6 introduit des protocoles de routage de modèle dynamique qui permettent des transferts fluides entre Luna, Terra et Sol. Une passerelle périphérique utilisant Luna peut traiter les journaux de capteurs de routine indéfiniment sans coût marginal d'API. Dès que le modèle local détecte une anomalie complexe dépassant son seuil de confiance interne, il peut empaqueter la trace contextuelle et transmettre le problème à Terra pour un diagnostic intermédiaire. Si Terra identifie une faille structurelle du système nécessitant un raisonnement causal approfondi, la tâche est transmise à Sol. Ce pipeline hiérarchique garantit que le pic de puissance de calcul n'est consommé que lorsque la complexité de pointe est réellement requise.
Optimisation matérielle et déploiement local en périphérie
Les percées en ingénierie qui rendent Luna viable sur du matériel local reposent en grande partie sur les avancées de la quantification en faible précision et de la mise en cache pondérée spécialisée. Historiquement, la compression d'un modèle en précision 4 bits ou 3 bits entraînait une dégradation sévère des performances en termes de cohérence du raisonnement et de syntaxe. Les techniques de quantification appliquées dans le processus de distillation de GPT-5.6 préservent la logique structurelle en conservant une précision plus élevée au niveau des têtes d'attention critiques, tout en compressant agressivement les couches linéaires « feed-forward ».
Cette optimisation reflète directement les limitations matérielles des environnements industriels. Dans un centre de données hyperscale propre et climatisé, la mémoire à large bande passante (HBM) et les boucles de refroidissement liquide masquent les inefficacités. Dans un atelier, les unités de calcul sont enfermées dans des châssis scellés, sans ventilateur et classés NEMA, conçus pour résister à la poussière, au brouillard d'huile et à des températures ambiantes dépassant 40 degrés Celsius. Dans ces enceintes, la dissipation thermique est le plafond infranchissable. Un modèle qui consomme une bande passante mémoire excessive génère une chaleur que le matériel périphérique ne peut tout simplement pas évacuer.
Le routage dynamique multi-niveaux peut-il rester stable en production ?
Bien que la séparation architecturale en Sol, Terra et Luna résolve les défis fondamentaux de calcul et de latence, elle introduit une nouvelle catégorie de risques d'ingénierie : l'instabilité du routage systémique. Lorsqu'une pile logicielle d'entreprise repose sur un seul modèle monolithique, les paramètres opérationnels, les modes de défaillance et les styles de raisonnement sont relativement uniformes. Diviser cette intelligence entre trois modèles distincts avec des échelles de paramètres très différentes signifie que le comportement du système peut changer de manière inattendue selon le niveau qui traite la requête.
La principale préoccupation des ingénieurs système est la défaillance en cascade non déterministe. Si une instance locale de Luna interprète mal une lecture anormale et ne parvient pas à transmettre le contexte à Terra, le moteur de raisonnement de niveau supérieur n'aura jamais l'occasion d'intervenir. Inversement, si les seuils d'escalade de Luna sont réglés de manière trop agressive, un réseau périphérique peut facilement inonder le niveau cloud avec des requêtes inutiles, réintroduisant exactement les pics de latence réseau et les explosions de coûts d'API que l'architecture était censée éliminer.
De plus, la dérive sémantique entre les niveaux présente un défi de test rigoureux. Une invite structurée pour obtenir une sortie déterministe lisible par machine de la part de Sol peut produire des erreurs syntaxiques subtiles lorsqu'elle est exécutée sur Terra, ou échouer complètement sous la fenêtre d'attention compressée de Luna. Les équipes d'ingénierie déployant GPT-5.6 devront consacrer des ressources substantielles à l'étalonnage non seulement des modèles individuels, mais de l'ensemble du pipeline d'arbitrage multi-niveaux, en validant que les transferts de contexte restent hermétiques à travers la frontière physique-cloud.
Une voie de maturation pour l'intelligence artificielle appliquée
La sortie de GPT-5.6 et de son cadre tripartite reflète une technologie qui sort de sa phase de croissance spéculative basée sur la force brute pour entrer dans une ère d'ingénierie des systèmes pragmatique. Ces dernières années, la course a été caractérisée par une expansion unilatérale des paramètres : construire des clusters de calcul plus grands pour entraîner des modèles plus grands afin d'obtenir des scores plus élevés sur des tests académiques abstraits. Mais l'intelligence brute dans le vide est d'une utilité limitée pour les industries physiques qui animent l'économie mondiale.



Comments
No comments yet. Be the first!