L'era in cui un modello linguistico di grandi dimensioni di punta veniva trattato come un endpoint API monolitico e universale sta giungendo silenziosamente al termine. Con il rilascio su larga scala di GPT-5.6, l'ecosistema si è spostato verso un'architettura tripartita esplicita: Sol, Terra e Luna. Invece di spingere un "mostro" indifferenziato da mille miliardi di parametri in ogni pipeline di query, indipendentemente dalla complessità del compito, questo rilascio formalizza ciò che gli ingegneri hardware e gli architetti di sistema richiedono da anni: una stratificazione strutturale progettata attorno a inviluppi termici, budget di latenza e costi di implementazione nel mondo reale.
Per l'automazione industriale e il calcolo distribuito, questo rilascio rappresenta qualcosa di più di un semplice incremento nei benchmark. Segna il riconoscimento intenzionale che il profilo di calcolo necessario per eseguire ragionamenti generativi di alto livello su complessi schemi ingegneristici è fondamentalmente incompatibile con il ciclo di esecuzione sotto i 50 millisecondi richiesto in un ambiente produttivo o su una piattaforma logistica autonoma. Decomponendo l'architettura in tre livelli dedicati, GPT-5.6 tenta di colmare il divario ostinato tra il ragionamento cloud centralizzato e l'esecuzione deterministica a livello di campo.
L'anatomia strutturale di Sol, Terra e Luna
La variante di punta, Sol, rappresenta la frontiera senza vincoli dell'architettura GPT-5.6. Progettata esclusivamente per data center iperscalabili dotati di densi cluster di acceleratori raffreddati a liquido, Sol gestisce la sintesi del contesto massimo, calcoli fisici multimodali complessi e ragionamenti simbolici a più passaggi. Opera con la più alta densità di parametri e i maggiori requisiti di larghezza di banda della memoria della famiglia, fungendo da modello fondamentale dal quale i suoi fratelli minori vengono distillati a valle. Negli ambienti di test, Sol dimostra guadagni significativi nella pianificazione a lungo termine, nella sintesi di codice su vasti codebase legacy e nella verifica logica non lineare, rendendolo il motore principale per l'analisi tecnica di alto livello e la generazione di design.
Terra occupa il livello intermedio aziendale, configurato come un "cavallo di battaglia" bilanciato ad alto throughput progettato per implementazioni cloud private, rack di server aziendali on-premise e pipeline API scalabili. Terra mantiene la stragrande maggioranza della comprensione operativa di Sol, eliminando al contempo il carico computazionale associato a casi limite altamente teorici e di nicchia. Progettato con uno schema di routing Mixture-of-Experts (MoE) aggressivo, Terra attiva solo una frazione del suo conteggio totale di parametri per token, riducendo drasticamente i costi di inferenza e il consumo di memoria. È adattato per operazioni industriali continue, gestendo la pianificazione delle risorse aziendali, la diagnostica telemetrica automatizzata, il routing dinamico della catena di approvvigionamento e la verifica software ad alta frequenza.
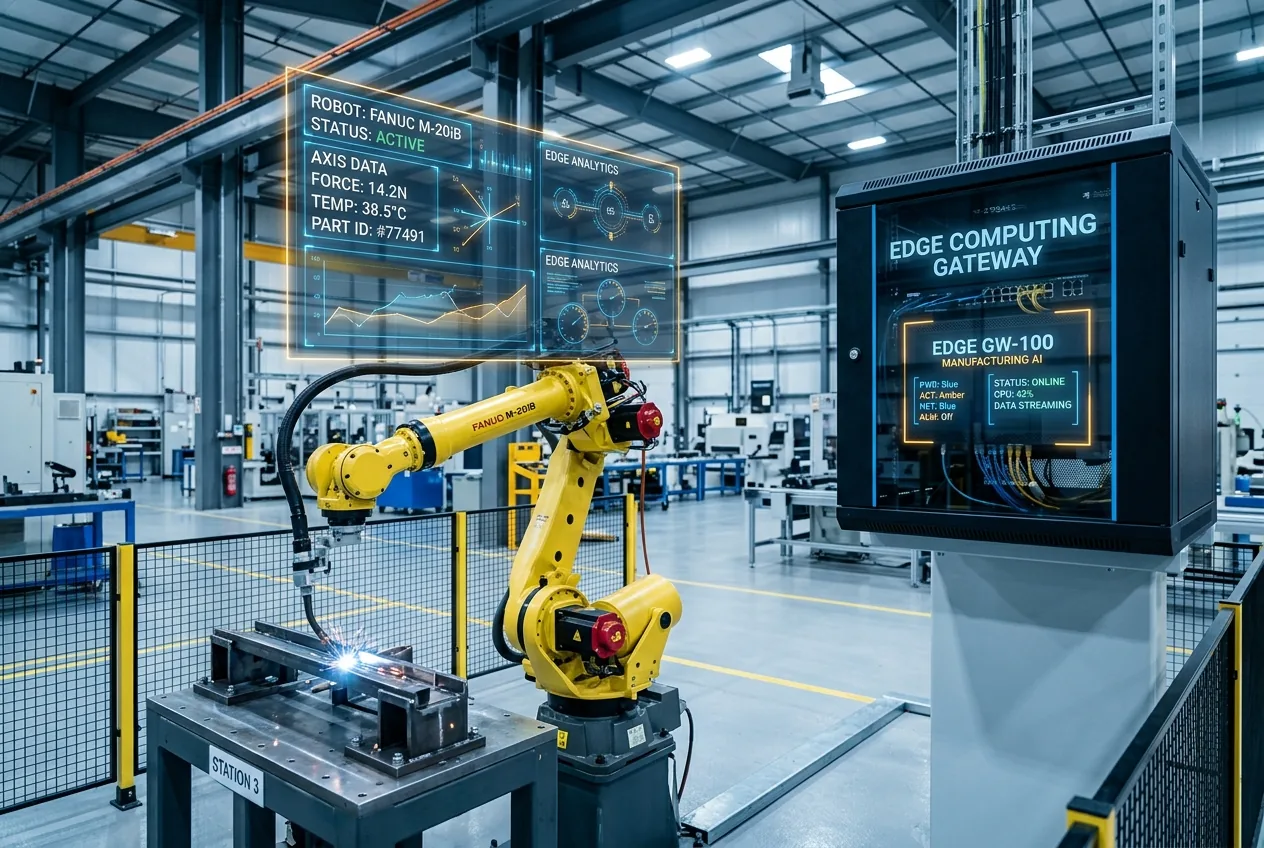
Il membro più dirompente della famiglia è Luna, una variante compatta, radicalmente potata e quantizzata, costruita esplicitamente per l'hardware edge e l'esecuzione locale a bassa latenza. Eseguibile comodamente all'interno dei vincoli di memoria di sistemi embedded, PC industriali e piattaforme di calcolo robotiche, Luna può operare interamente on-device senza un uplink attivo. Dando priorità a metriche rapide di "time-to-first-token" e latenze di risposta quasi deterministiche, Luna riduce il modello di frontiera al suo nucleo operativo, concentrandosi sull'esecuzione diretta dei compiti, sull'interpretazione della fusione dei sensori locali e sull'analisi immediata delle istruzioni in linguaggio naturale.
Colmare il divario di latenza nei sistemi ciber-fisici
Nell'ingegneria meccanica e nella robotica industriale, la latenza non è solo un inconveniente; è un rigido vincolo di sicurezza. Una cella di lavoro robotizzata che aziona un braccio articolato non può attendere 800 millisecondi affinché un modello di frontiera ospitato nel cloud restituisca un token di inferenza mentre un nastro trasportatore avanza a due metri al secondo. I tradizionali modelli linguistici di grandi dimensioni hanno faticato a penetrare nella tecnologia operativa fisica perché il jitter di rete non deterministico e i tempi di coda imprevedibili introducono un rischio operativo inaccettabile.
Questa divisione strutturale consente a Luna di operare come traduttore e supervisore locale, mentre Terra o Sol operano in modo asincrono in background. Se si verifica un'anomalia di vibrazione imprevista in un mandrino CNC, Luna può segnalare istantaneamente i dati telemetrici transitori, incrociarli con i parametri locali della macchina e rallentare la velocità di avanzamento. Nel frattempo, il pacchetto di telemetria grezzo viene inviato a monte a Terra per un'analisi comparativa a livello di flotta, garantendo che le operazioni fisiche immediate non siano mai ostaggio dei tempi di andata e ritorno del cloud.
Il calcolo economico dell'inferenza su larga scala
Al di là dei vincoli hardware tecnici, l'economia dell'inferenza aziendale continua ha spinto i team infrastrutturali verso un punto di rottura. Interrogare un modello monolitico di alto livello per attività banali e ad alta frequenza, come l'analisi di payload JSON strutturati, la convalida di input API o la trascrizione di metriche telemetriche, brucia capitale a un ritmo insostenibile. L'economia dei token su larga scala richiede che i costi di calcolo si allineino proporzionalmente al valore economico della specifica query risolta.
Inoltre, il rilascio di GPT-5.6 introduce protocolli di routing dinamico dei modelli che consentono passaggi senza soluzione di continuità tra Luna, Terra e Sol. Un gateway edge che esegue Luna può elaborare log di sensori di routine indefinitamente a costo API marginale zero. Nel momento in cui il modello locale rileva un'anomalia complessa che supera la sua soglia di confidenza interna, può impacchettare la traccia contestuale ed escalare il problema a Terra per una diagnosi intermedia. Se Terra identifica un difetto strutturale del sistema che richiede un ragionamento causale profondo, il compito viene passato a Sol. Questa pipeline gerarchica garantisce che il picco di calcolo venga consumato solo quando è realmente richiesta la massima complessità.
Ottimizzazione hardware e implementazione edge locale
Le scoperte ingegneristiche che rendono Luna praticabile sull'hardware locale si basano fortemente sui progressi nella quantizzazione a bassi bit e nel caching specializzato dei pesi. Storicamente, comprimere un modello a una precisione di 4 o 3 bit portava a un grave degrado delle prestazioni nella coerenza del ragionamento e nella coerenza sintattica. Le tecniche di quantizzazione applicate nel processo di distillazione di GPT-5.6 preservano la logica strutturale mantenendo una precisione più elevata attraverso i "critical attention heads", comprimendo aggressivamente i layer feed-forward lineari.
Questa ottimizzazione riflette direttamente le limitazioni hardware degli ambienti industriali. In un data center iperscalabile pulito e a temperatura controllata, la memoria a larghezza di banda elevata (HBM) e i loop di raffreddamento a liquido mascherano le inefficienze. In un ambiente di fabbrica, le unità di calcolo sono racchiuse in chassis sigillati, senza ventole e con classificazione NEMA, progettati per resistere a polvere, nebbia d'olio e temperature ambientali superiori ai 40 gradi Celsius. In questi involucri, la dissipazione termica è il limite invalicabile. Un modello che consuma un'eccessiva larghezza di banda di memoria genera un calore che l'hardware edge semplicemente non può smaltire.
Il routing dinamico multi-livello può rimanere stabile in produzione?
Sebbene la separazione architettonica in Sol, Terra e Luna risolva sfide fondamentali di calcolo e latenza, introduce una nuova categoria di rischio ingegneristico: l'instabilità sistemica del routing. Quando uno stack software aziendale si affida a un singolo modello monolitico, i parametri operativi, le modalità di errore e gli stili di ragionamento sono relativamente uniformi. Dividere tale intelligenza tra tre modelli separati con scale di parametri ampiamente diverse significa che il comportamento del sistema può cambiare inaspettatamente a seconda del livello che gestisce la richiesta.
La preoccupazione principale tra gli ingegneri di sistema è il fallimento a cascata non deterministico. Se un'istanza locale di Luna interpreta erroneamente una lettura anomala e non riesce a escalare il contesto a Terra, il motore di ragionamento di livello superiore non avrà mai l'opportunità di intervenire. Al contrario, se le soglie di escalation di Luna sono regolate in modo troppo aggressivo, una rete edge può facilmente inondare il livello cloud con query non necessarie, reintroducendo esattamente i picchi di latenza di rete e le esplosioni dei costi API che l'architettura era stata progettata per eliminare.
Inoltre, lo "spostamento semantico" (semantic drift) tra i livelli presenta una rigorosa sfida di test. Un prompt strutturato per ottenere un output deterministico e leggibile dalla macchina da Sol può produrre sottili errori sintattici se eseguito su Terra, o fallire completamente sotto la finestra di attenzione compressa di Luna. I team di ingegneria che implementano GPT-5.6 dovranno dedicare risorse sostanziali al benchmarking non solo dei singoli modelli, ma dell'intera pipeline di arbitraggio multi-livello, convalidando che i passaggi di contesto rimangano ermetici attraverso il confine fisico-cloud.
Un percorso maturo per l'intelligenza artificiale applicata
Il rilascio di GPT-5.6 e del suo framework tripartito riflette una tecnologia che sta uscendo dalla sua fase di crescita speculativa e basata sulla forza bruta per entrare in un'era di ingegneria dei sistemi pragmatica. Negli ultimi anni, la corsa è stata caratterizzata da un'espansione dei parametri fine a se stessa: costruire cluster di calcolo più grandi per addestrare modelli più grandi per ottenere punteggi più alti su benchmark accademici astratti. Ma l'intelligenza grezza nel vuoto è di utilità limitata per le industrie fisiche che guidano l'economia globale.



Comments
No comments yet. Be the first!