La era de tratar a un modelo de lenguaje extenso (LLM) insignia como un punto de conexión API monolítico y único para todos está llegando discretamente a su fin. Con el despliegue de disponibilidad general de GPT-5.6, el ecosistema ha migrado hacia una arquitectura tripartita explícita: Sol, Terra y Luna. En lugar de forzar una bestia indiferenciada de billones de parámetros en cada canal de consultas sin importar la complejidad de la tarea, este lanzamiento formaliza lo que los ingenieros de hardware y arquitectos de sistemas han exigido durante años: una estratificación estructural diseñada en torno a envolventes térmicas, presupuestos de latencia y costes de implementación en el mundo real.
Para la automatización industrial y la computación distribuida, este lanzamiento representa más que un incremento incremental en los puntos de referencia. Marca un reconocimiento intencionado de que el perfil de cómputo necesario para ejecutar razonamiento generativo de alto nivel sobre complejos esquemas de ingeniería es fundamentalmente incompatible con el bucle de ejecución de menos de 50 milisegundos requerido en una planta de fabricación o una plataforma logística autónoma. Al desacoplar la arquitectura en tres niveles dedicados, GPT-5.6 intenta salvar el persistente abismo entre el razonamiento central en la nube y la ejecución determinista a nivel de campo.
La anatomía estructural de Sol, Terra y Luna
La variante insignia, Sol, representa la frontera sin restricciones de la arquitectura GPT-5.6. Diseñada estrictamente para centros de datos a hiperescala equipados con densos clústeres de aceleradores refrigerados por líquido, Sol maneja la síntesis de contexto máximo, cálculos de física multimodal complejos y razonamiento simbólico de múltiples pasos. Opera con la mayor densidad de parámetros y requisitos de ancho de banda de memoria de la familia, sirviendo como el modelo fundacional a partir del cual sus hermanos menores se destilan. En entornos de prueba, Sol demuestra ganancias significativas en la planificación a largo plazo, la síntesis de código en bases de código heredadas extensas y la verificación de lógica no lineal, convirtiéndose en el motor principal para el análisis técnico de alto nivel y la generación de diseños.
Terra ocupa el nivel intermedio empresarial, configurado como un caballo de batalla equilibrado y de alto rendimiento diseñado para implementaciones en nubes privadas, racks de servidores empresariales locales y canales de API escalables. Terra conserva la gran mayoría de la comprensión operativa de Sol, eliminando la sobrecarga computacional asociada con casos extremos altamente teóricos y especializados. Diseñado con un esquema de enrutamiento agresivo de Mezcla de Expertos (MoE, por sus siglas en inglés), Terra activa solo una fracción de su recuento total de parámetros por token, reduciendo drásticamente los costes de inferencia y el consumo de memoria. Está adaptado para operaciones industriales continuas: manejo de planificación de recursos empresariales, diagnósticos de telemetría automatizados, enrutamiento dinámico de cadenas de suministro y verificación de software de alta frecuencia.
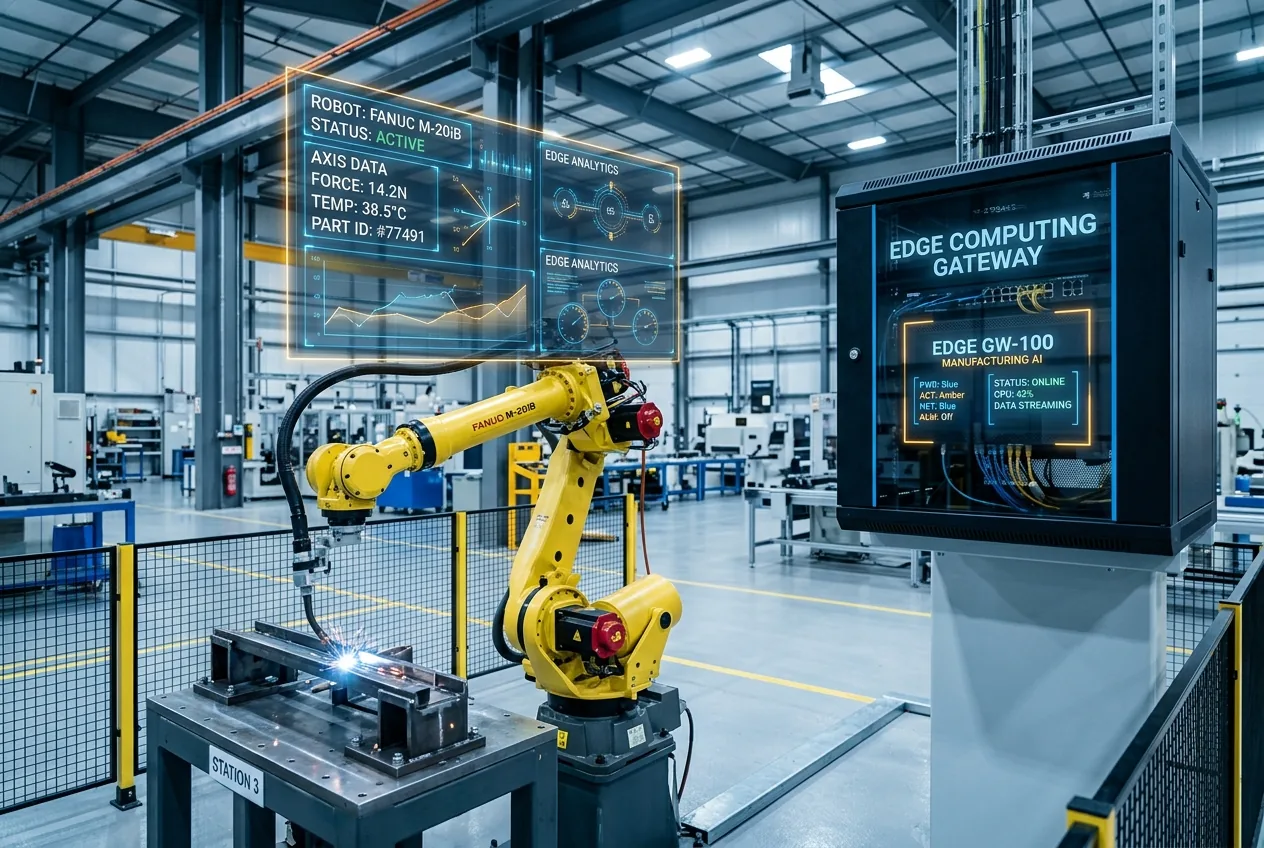
El miembro más disruptivo de la familia es Luna, una variante compacta, radicalmente podada y cuantizada, construida explícitamente para hardware de borde y ejecución local de baja latencia. Ejecutándose cómodamente dentro de las limitadas huellas de memoria de sistemas embebidos, PC industriales y plataformas de cómputo robótico, Luna puede ejecutarse completamente en el dispositivo sin necesidad de un enlace ascendente activo. Al priorizar métricas rápidas de tiempo hasta el primer token y latencias de respuesta casi deterministas, Luna reduce el modelo de frontera a su núcleo operativo, centrándose en la ejecución directa de tareas, la interpretación de fusión de sensores locales y el análisis inmediato de instrucciones en lenguaje natural.
Salvando la brecha de latencia en sistemas ciberfísicos
En ingeniería mecánica y robótica industrial, la latencia no es simplemente un inconveniente; es una restricción estricta de seguridad. Una célula de trabajo robótica que opera un brazo articulado no puede esperar 800 milisegundos a que un modelo de frontera alojado en la nube devuelva un token de inferencia mientras una cinta transportadora avanza a dos metros por segundo. Los modelos de lenguaje extenso tradicionales han tenido dificultades para penetrar en la tecnología operativa física porque la inestabilidad de la red no determinista y los tiempos de espera impredecibles introducen un riesgo operativo inaceptable.
Esta división estructural permite que Luna opere como un traductor y supervisor local, mientras que Terra o Sol operan de forma asíncrona en segundo plano. Si ocurre una anomalía de vibración inesperada en un husillo CNC, Luna puede señalar los datos de telemetría transitorios al instante, cruzarlos con los parámetros locales de la máquina y ralentizar la velocidad de avance. Mientras tanto, el paquete de telemetría sin procesar se envía a Terra para un análisis comparativo de toda la flota, asegurando que las operaciones físicas inmediatas nunca se vean comprometidas por los tiempos de ida y vuelta de la nube.
El cálculo económico de la inferencia a escala
Más allá de las limitaciones técnicas del hardware, la economía de la inferencia empresarial continua ha llevado a los equipos de infraestructura a un punto de ruptura. Consultar un modelo monolítico de primer nivel para tareas mundanas de alta frecuencia —como el análisis de cargas útiles JSON estructuradas, la validación de entradas de API o la transcripción de métricas de telemetría— consume capital a un ritmo insostenible. La economía de tokens a escala exige que los costes de cómputo se alineen proporcionalmente con el valor económico de la consulta específica que se está resolviendo.
Además, el lanzamiento de GPT-5.6 introduce protocolos de enrutamiento de modelos dinámicos que permiten traspasos fluidos entre Luna, Terra y Sol. Una puerta de enlace de borde que ejecute Luna puede procesar registros de sensores rutinarios indefinidamente sin coste marginal de API. En el momento en que el modelo local detecta una anomalía compleja que supera su umbral de confianza interno, puede empaquetar el rastro contextual y escalar el problema a Terra para un diagnóstico intermedio. Si Terra identifica una falla estructural del sistema que requiere un razonamiento causal profundo, la tarea se escala a Sol. Este canal jerárquico asegura que el cómputo máximo se consuma solo cuando la complejidad máxima es genuinamente requerida.
Optimización de hardware e implementación local en el borde
Los avances de ingeniería que hacen que Luna sea viable en hardware local dependen en gran medida de los progresos en la cuantización de bajo bit y el almacenamiento en caché de pesos especializado. Históricamente, comprimir un modelo a una precisión de 4 o 3 bits provocaba una degradación severa del rendimiento en la consistencia del razonamiento y la coherencia sintáctica. Las técnicas de cuantización aplicadas en el proceso de destilación de GPT-5.6 preservan la lógica estructural al mantener una mayor precisión en los cabezales de atención críticos mientras comprimen agresivamente las capas lineales de avance.
Esta optimización refleja directamente las limitaciones de hardware de los entornos industriales. En un centro de datos a hiperescala limpio y con temperatura controlada, la memoria de alto ancho de banda (HBM) y los bucles de refrigeración líquida enmascaran las ineficiencias. En el suelo de una fábrica, las unidades de cómputo están encerradas en chasis sellados sin ventilador con clasificación NEMA, diseñados para soportar polvo, neblina de aceite y temperaturas ambientales superiores a los 40 grados Celsius. En estos gabinetes, la disipación térmica es el techo absoluto. Un modelo que consume un ancho de banda de memoria excesivo genera un calor que el hardware de borde simplemente no puede disipar.
¿Puede el enrutamiento dinámico multinivel permanecer estable en producción?
Si bien la separación arquitectónica en Sol, Terra y Luna resuelve desafíos fundamentales de cómputo y latencia, introduce una nueva categoría de riesgo de ingeniería: la inestabilidad sistémica del enrutamiento. Cuando una pila de software empresarial depende de un único modelo monolítico, los parámetros operativos, los modos de falla y los estilos de razonamiento son relativamente uniformes. Dividir esa inteligencia en tres modelos separados con escalas de parámetros muy diferentes significa que el comportamiento del sistema puede cambiar inesperadamente dependiendo de qué nivel maneje la solicitud.
La principal preocupación entre los ingenieros de sistemas es la falla en cascada no determinista. Si una instancia local de Luna malinterpreta una lectura anómala y no escala el contexto a Terra, el motor de razonamiento de nivel superior nunca tendrá la oportunidad de intervenir. Por el contrario, si los umbrales de escalada de Luna se ajustan de manera demasiado agresiva, una red de borde puede inundar fácilmente el nivel de la nube con consultas innecesarias, reintroduciendo exactamente los picos de latencia de red y las explosiones de costes de API que la arquitectura fue diseñada para eliminar.
Además, la deriva semántica entre los niveles presenta un desafío de prueba riguroso. Un prompt estructurado para obtener una salida determinista y legible por máquina de Sol puede producir errores sintácticos sutiles cuando se ejecuta en Terra, o fallar por completo bajo la ventana de atención comprimida de Luna. Los equipos de ingeniería que implementen GPT-5.6 deberán dedicar recursos sustanciales a evaluar no solo los modelos individuales, sino todo el canal de arbitraje multinivel, validando que los traspasos de contexto permanezcan herméticos a través de la frontera entre lo físico y la nube.
Un camino maduro para la inteligencia artificial aplicada
El lanzamiento de GPT-5.6 y su marco tripartito refleja una tecnología que abandona su fase de crecimiento especulativo y de fuerza bruta para entrar en una era de ingeniería de sistemas pragmática. Durante los últimos años, la carrera se ha caracterizado por la expansión de parámetros con un objetivo único: construir clústeres de cómputo más grandes para entrenar modelos más grandes y así obtener puntuaciones más altas en pruebas académicas abstractas. Pero la inteligencia pura en el vacío es de utilidad limitada para las industrias físicas que impulsan la economía global.



Comments
No comments yet. Be the first!