Das Latenzproblem: Warum herkömmliche Sprachschnittstellen scheiterten
Um die technische Leistung einer echten Echtzeit-Interaktion zu würdigen, muss man zunächst die kumulativen Ineffizienzen der Systeme untersuchen, die ihr vorausgingen. Historisch gesehen war die Interaktion mit einer sprachgesteuerten künstlichen Intelligenz eine Abfolge entkoppelter Subsysteme, die in Reihe geschaltet waren. Wenn ein Benutzer sprach, wurde sein akustisches Signal erfasst, digitalisiert und an eine Spracherkennungs-Engine (ASR) wie OpenAI's Whisper weitergeleitet. Diese Engine verarbeitete die Wellenform, erstellte ein textbasiertes Transkript und übergab diesen Text-Payload an das primäre Large Language Model.
Der kumulative Effekt dieser dreistufigen Pipeline war verheerend für ein natürliches Gespräch. Die gesamte Round-Trip-Latenz schwankte routinemäßig zwischen zwei und vier Sekunden. In der praktischen Anwendung erzeugte diese Latenz eine unheimliche kommunikative Barriere. Benutzer waren gezwungen zu pausieren, auf Verarbeitungszyklen zu warten und unangenehme Gesprächskollisionen zu ertragen, wann immer eine Unterbrechung auftrat. Darüber hinaus litt diese entkoppelte Pipeline unter einem katastrophalen Kontextverlust. Ein ASR-Modell entfernt Tonhöhe, emotionale Betonung, Hintergrundgeräusche und Kadenz und reduziert reichhaltige akustische Daten auf flachen ASCII-Text. Die Synthese-Engine am anderen Ende war gezwungen, den passenden Ton zu erraten, was zu einer sterilen, roboterhaften Kadenz ohne situatives Bewusstsein führte.
Die Omni-Architektur: Zusammenbruch der Pipeline
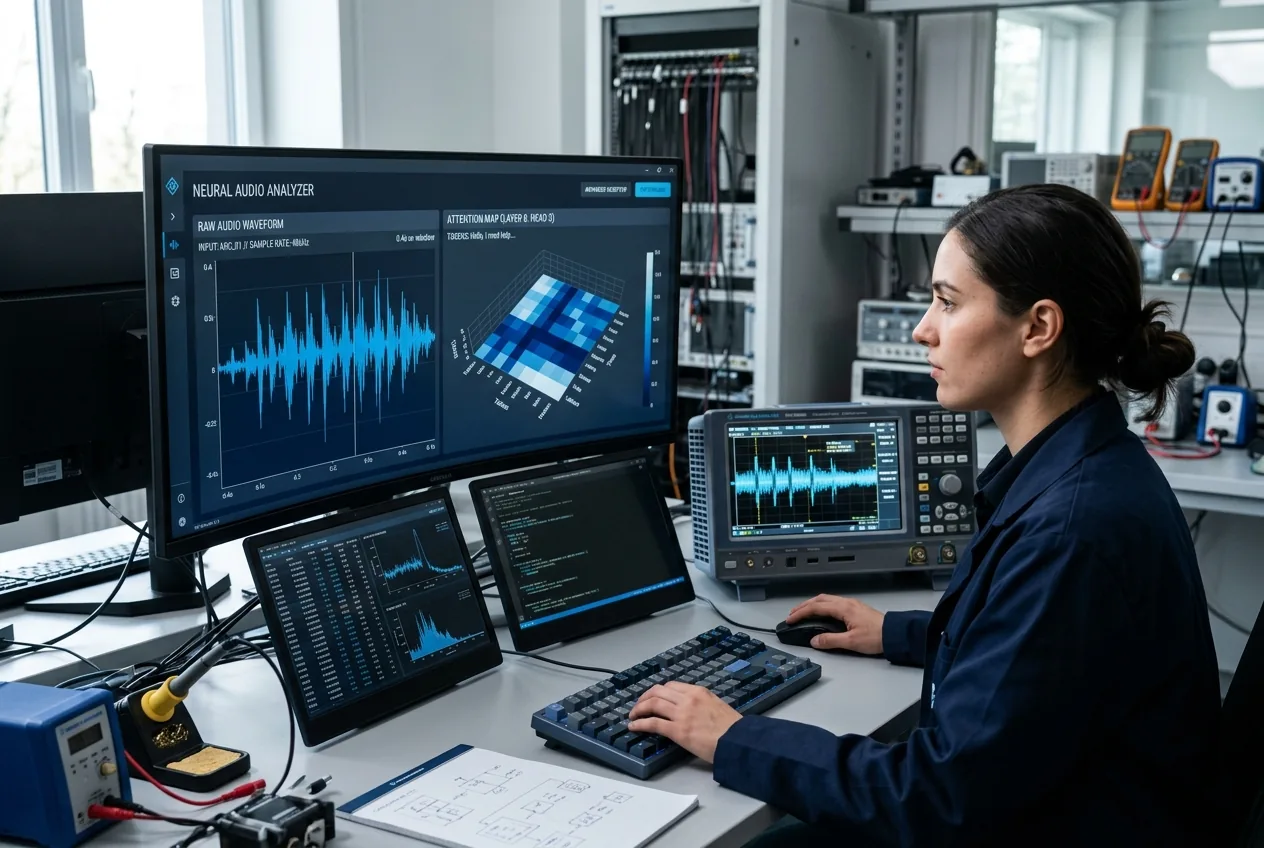
Die Kerninnovation hinter Systemen wie GPT-4o liegt in der vereinheitlichten Tokenisierung. Anstatt Audio, visuelle Frames und Text als separate Datenmodalitäten zu behandeln, die eine Übersetzung in intermediäre Textrepräsentationen erfordern, trainiert eine omnimodale Architektur einen einzigen Transformer nativ über alle Ein- und Ausgaben hinweg. Audio-Wellenformen werden direkt in den latenten Raum des Modells tokenisiert, wodurch das neuronale Netzwerk akustische Merkmale zusammen mit semantischen Text-Token innerhalb derselben Attention-Heads verarbeiten kann.
Diese architektonische Konsolidierung eliminiert die ASR- und TTS-Übergaben vollständig. Das Netzwerk empfängt rohe oder komprimierte Audio-Token und gibt entsprechende Audio-Token direkt aus, wodurch Antwortlatenzen von nur 232 Millisekunden erreicht werden, bei einem Durchschnittswert nahe 320 Millisekunden. Dieses Leistungsspektrum entspricht exakt der natürlichen Antwortdynamik eines menschlichen Gesprächs.
Noch wichtiger ist, dass die Bewahrung der Audio-Fidelity im latenten Raum eine bidirektionale Nuancierung ermöglicht, die textbasierte Modelle nicht replizieren können. Das Netzwerk kann subtile Variationen in Tonhöhe, Zögern, stimmlicher Belastung und Sprechtempo erkennen. Im Gegenzug kann das Modell seine eigene synthetische Ausgabe dynamisch anpassen – den Ton modulieren, bewusste Pausen einlegen oder in dringenden Kontexten schneller sprechen. Wenn ein Benutzer unterbricht, benötigt das Modell keinen externen "Circuit Breaker", um die Wiedergabe zu stoppen; der eingehende Audiostrom verändert sofort die Attention-Weights während der nachfolgenden Token-Generierungsschritte, wodurch das Rederecht auf natürliche Weise abgegeben wird.
Desktop-Integration und die Betriebssystemebene
Eine niedrige Latenz allein reicht nicht aus, wenn das Modell hinter einem Webbrowser-Tab gefangen bleibt. Wissensarbeit und industrielle Überwachung erfordern ständigen Zugriff auf kontextbezogene Betriebsumgebungen. OpenAI's Bestreben, diese Fähigkeiten direkt in Desktop-Betriebssysteme einzubetten, beginnend mit dedizierten Client-Anwendungen für macOS und Windows, stellt einen bewussten Versuch dar, umgebungsbezogene Maschinentelemetrie zu erfassen.
Eine Anwendung, die in der Lage ist, Framebuffer direkt vom Betriebssystem abzugreifen, umgeht diesen Engpass bei der Dateneingabe. Ein Ingenieur, der eine speicherprogrammierbare Steuerung (SPS) für die Automatisierung zur Fehlerbehebung prüft oder eine CAD-Baugruppe (Computer-Aided Design) in Echtzeit analysiert, kann sofort eine eingeblendete Inspektionsschnittstelle aufrufen. Da das zugrunde liegende Modell Bildmatrizen zusammen mit natürlichen Sprachbefehlen verarbeitet, kann der Benutzer auf visuelle Anomalien auf dem Bildschirm zeigen und gleichzeitig mündlich Strukturanalysen oder Code-Refactoring anfordern, wobei der Screen-Buffer als gemeinsame Arbeitsfläche und nicht als isoliertes Artefakt behandelt wird.
Compute-Skalierung und die Ökonomie der Echtzeit-Multimodalität
Obwohl die architektonische Eleganz vereinheitlichter multimodaler Transformer unbestreitbar ist, stellt der Betrieb dieser Systeme im Unternehmensmaßstab enorme rechnerische Herausforderungen dar. Echtzeit-Audio- und hochfrequente visuelle Streams erfordern deutlich mehr Rechenressourcen als herkömmliches textbasiertes Key-Value (KV) Caching. Ein kontinuierlicher Audiostrom erfordert eine hochfrequente Token-Abtastung, was das aktive Kontextfenster schnell erweitert und enormen Speicherdruck auf die High-Bandwidth Memory (HBM) Subsysteme in modernen Beschleuniger-Clustern wie den H100- und H200-Flotten von Nvidia ausübt.
Um diese Fähigkeiten für Hunderte Millionen von Benutzern nutzbar zu machen, müssen Infrastrukturanbieter die Ökonomie der Inferenz gegen strenge Quality of Service (QoS) Garantien abwägen. Diese wirtschaftliche Realität erklärt, warum Tiering-Mechanismen weiterhin essenziell bleiben. Zentralisierte Rechenzentren müssen Rechenzuweisungen priorisieren, Leerlaufsitzungen verschieben, intensive Videostreams ratenlimitieren und bei Spitzenlast auf kleinere Distillationsmodelle zurückgreifen.
Darüber hinaus erfordert die Verwaltung bidirektionaler Audioströme über variable Internetverbindungen robuste Client-Server-Synchronisationsprotokolle. Kleine Paketverluste, die bei der asynchronen Textgenerierung unbemerkt blieben, können in einer Live-Sprachumgebung zu hörbaren Artefakten, Stottern oder desynchronisierter Token-Generierung führen. Die Balance zwischen niedriger Latenz und verlusttoleranten Audio-Codecs ist ein aktives technisches Grenzgebiet, das den Übergang zwischen Deep-Learning-Inferenz und klassischer Telekommunikationstechnik bildet.
Jenseits des Hypes: Die operative Realität der Zukunft
Während Branchenbeobachter über spekulative Modellveröffentlichungszyklen hinwegblicken und sich auf operative Grundlagen konzentrieren, ist der Weg in die Zukunft unmissverständlich klar. Der Wert generativer KI im Unternehmensumfeld wird nicht an Benchmark-Differenzen in abstrakten standardisierten Tests gemessen. Stattdessen wird er an deterministischer Latenz, der Tiefe der Plattformintegration und der Fähigkeit des Modells bewertet, als ungehinderte Brücke zwischen menschlichen Bedienern und komplexen Softwareumgebungen zu fungieren.
Die Verlagerung der Rechenprozesse aus isolierten Pipelines hin zu nativen multimodalen Netzwerken bildet das Fundament für wirklich autonome Agenten. Wenn ein KI-System gleichzeitig den Bildschirm des Ingenieurs sehen, die Kadenz und den Tonfall seiner operativen Befehle hören und sekundenschnelle Lösungen direkt zurück in den nativen Workflow liefern kann, erreicht die Schnittstelle zwischen Mensch und digitaler Maschine ein beispielloses Maß an mechanischer Kohäsion. Bei der Zukunft der Arbeitsplatzautomatisierung geht es nicht darum, auf eine mythische Modelliteration zu warten; es geht darum, jene latenzarmen Pipelines zu entwickeln, die bestehende Intelligenz in eine natürliche, beständige Erweiterung menschlicher Industriearbeit verwandeln.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!