Il problema della latenza: perché le interfacce vocali tradizionali hanno fallito
Per comprendere il successo tecnico di un'interazione in tempo reale, è necessario innanzitutto esaminare le inefficienze cumulative dei sistemi che l'hanno preceduta. Storicamente, interagire con un'intelligenza artificiale a comando vocale comportava una sequenza di sottosistemi disaccoppiati che operavano in serie. Quando un utente parlava, il suo segnale acustico veniva catturato, digitalizzato e instradato verso un motore di riconoscimento vocale (ASR), come Whisper di OpenAI. Questo motore elaborava la forma d'onda, generava una trascrizione testuale e passava quel carico di testo al modello linguistico di grandi dimensioni principale.
L'effetto combinato di questa pipeline a tre stadi era devastante per una conversazione naturale. La latenza totale di andata e ritorno oscillava regolarmente tra i due e i quattro secondi. Nelle applicazioni pratiche, questa latenza creava un'inquietante barriera conversazionale. Gli utenti erano costretti a fare pause, attendere i cicli di elaborazione e subire goffe sovrapposizioni durante la conversazione ogni volta che si verificava un'interruzione. Inoltre, questa pipeline disaccoppiata soffriva di una catastrofica perdita di contesto. Un modello ASR rimuove l'intonazione, le inflessioni emotive, il rumore di fondo e la cadenza, riducendo i ricchi dati acustici in un piatto testo ASCII. Il motore di sintesi dall'altra parte era lasciato a indovinare il tono appropriato, generando una cadenza sterile e robotica priva di consapevolezza situazionale.
L'architettura Omni: comprimere la pipeline
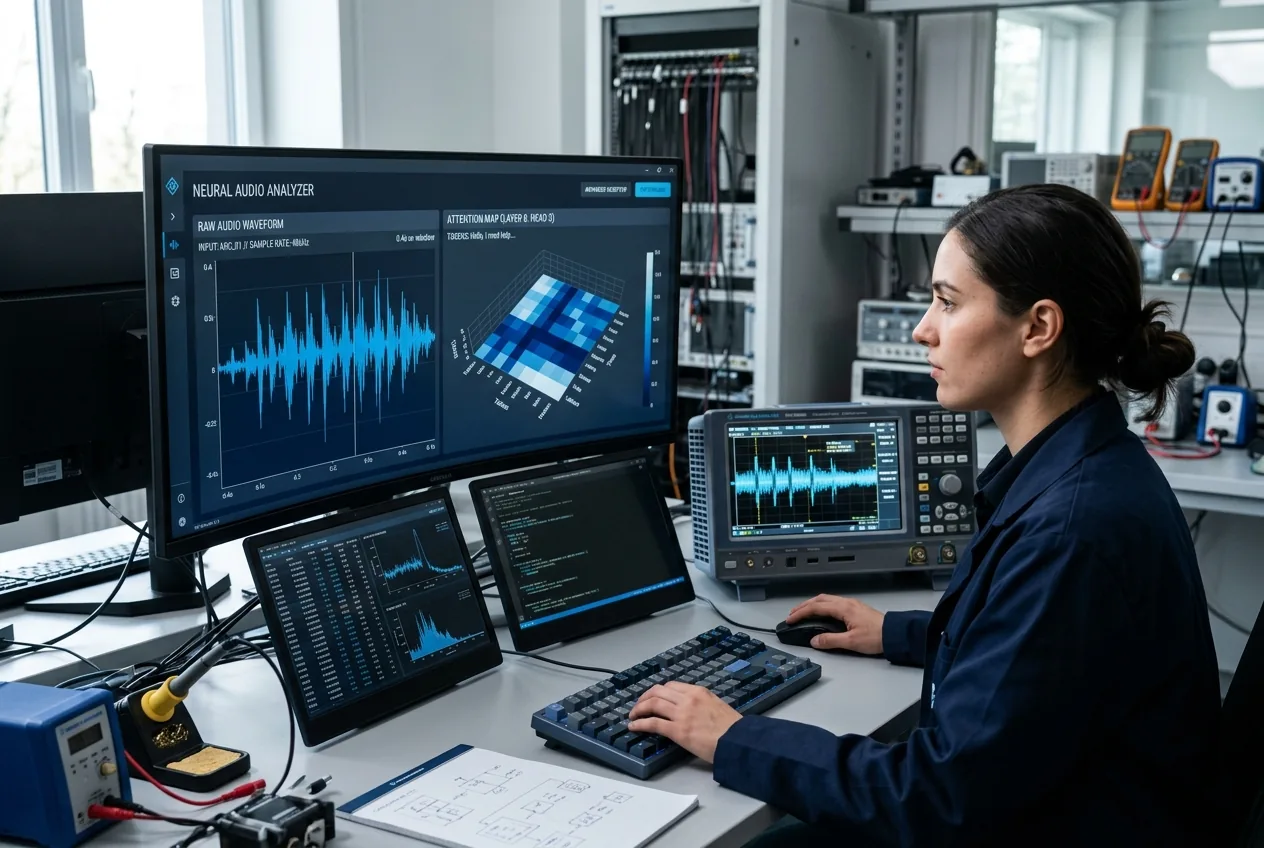
L'innovazione fondamentale alla base di sistemi come GPT-4o risiede nella tokenizzazione unificata. Invece di trattare audio, fotogrammi visivi e testo come modalità di dati separate che richiedono una traduzione in rappresentazioni testuali intermedie, un'architettura omni-modale addestra un singolo transformer su tutti gli input e gli output in modo nativo. Le forme d'onda audio vengono tokenizzate direttamente nello spazio latente del modello, consentendo alla rete neurale di elaborare le caratteristiche acustiche insieme ai token di testo semantico all'interno delle medesime teste di attenzione (attention heads).
Questo consolidamento architettonico elimina completamente gli scambi tra ASR e TTS. La rete riceve token audio grezzi o compressi ed emette i corrispondenti token audio direttamente, raggiungendo latenze di risposta fino a 232 millisecondi, con una media che si attesta intorno ai 320 millisecondi. Questo profilo di prestazioni corrisponde esattamente alle dinamiche di risposta naturali di una conversazione tra esseri umani.
Ancora più importante, preservare la fedeltà audio all'interno dello spazio latente consente sfumature bidirezionali che i modelli basati solo sul testo non possono replicare. La rete è in grado di rilevare sottili variazioni di intonazione, esitazioni, sforzo vocale e ritmo del parlato. In cambio, il modello può regolare dinamicamente il proprio output sintetico, modulando il tono, introducendo pause deliberate o parlando più rapidamente in contesti urgenti. Quando un utente interrompe, il modello non richiede un circuito di interruzione esterno per bloccare la riproduzione; il flusso audio in entrata altera immediatamente i pesi di attenzione durante le fasi successive di generazione dei token, cedendo naturalmente il turno nella conversazione.
Integrazione desktop e livello del sistema operativo
Una bassa latenza da sola non è sufficiente se il modello rimane intrappolato dietro una scheda del browser web. Il lavoro basato sulla conoscenza e il monitoraggio industriale richiedono un accesso continuo agli ambienti operativi contestuali. La spinta di OpenAI a integrare queste funzionalità direttamente nei sistemi operativi desktop, a partire dalle applicazioni client dedicate per macOS e Windows, rappresenta un tentativo intenzionale di catturare la telemetria ambientale delle macchine.
Un'applicazione in grado di catturare i buffer di frame direttamente dal sistema operativo aggira questo collo di bottiglia nell'immissione dei dati. Un ingegnere che sta risolvendo i problemi di un controllore a logica programmabile (PLC) di automazione o analizzando un assemblaggio CAD (computer-aided design) in tempo reale può far apparire istantaneamente un'interfaccia di ispezione sovrapposta. Poiché il modello sottostante elabora matrici di immagini insieme alle istruzioni vocali naturali, l'utente può indicare anomalie visive sullo schermo chiedendo verbalmente calcoli strutturali o refactoring del codice, trattando il buffer dello schermo come una tela condivisa piuttosto che come un artefatto isolato.
Scalabilità computazionale ed economia della multimodalità in tempo reale
Sebbene l'eleganza architettonica dei transformer multimodali unificati sia innegabile, l'esecuzione di questi sistemi su scala aziendale presenta sfide computazionali sbalorditive. L'audio in tempo reale e lo streaming visivo ad alto framerate richiedono molte più risorse di calcolo rispetto alla convenzionale memorizzazione nella cache chiave-valore (KV) basata sul testo. Un flusso audio continuo richiede un campionamento dei token ad alta frequenza, espandendo rapidamente la finestra di contesto attiva e imponendo un'immensa pressione sulla memoria ai sottosistemi di memoria a larghezza di banda elevata (HBM) all'interno di moderni cluster di acceleratori come le flotte H100 e H200 di Nvidia.
Per rendere queste capacità sostenibili per centinaia di milioni di utenti, i fornitori di infrastrutture devono bilanciare l'economia dell'inferenza con rigorose garanzie di Qualità del Servizio (QoS). Questa realtà economica spiega perché i meccanismi di suddivisione in livelli rimangono essenziali. I datacenter centralizzati devono dare priorità alle allocazioni di calcolo, spostando le sessioni inattive, limitando la velocità dei flussi video intensivi e ricorrendo a modelli di distillazione più piccoli quando i cluster di server affrontano picchi di capacità.
Inoltre, la gestione di flussi audio bidirezionali su connessioni internet variabili richiede protocolli di sincronizzazione client-server robusti. Piccoli cali nella trasmissione dei pacchetti, che sarebbero impercettibili nella generazione di testo asincrona, possono causare artefatti udibili, balbuzie o una generazione di token desincronizzata in un ambiente vocale dal vivo. Bilanciare la bassa latenza con codec audio tolleranti alle perdite è una frontiera ingegneristica attiva che si colloca al confine tra l'inferenza del deep learning e l'ingegneria delle telecomunicazioni classica.
Oltre l'hype: la realtà operativa che ci attende
Mentre gli osservatori del settore guardano oltre i cicli speculativi di rilascio dei modelli per concentrarsi sui fondamenti operativi, il percorso da seguire è inequivocabilmente chiaro. Il valore dell'IA generativa in ambito aziendale non sarà misurato dai differenziali di punti nei benchmark su test standardizzati astratti. Sarà invece valutato in base alla latenza deterministica, alla profondità dell'integrazione nella piattaforma e alla capacità del modello di fungere da ponte non vincolato tra operatori umani e complessi ambienti software.
Spostare l'elaborazione computazionale da pipeline isolate a reti multimodali native stabilisce le basi per agenti veramente autonomi. Quando un sistema di IA può vedere simultaneamente lo schermo dell'ingegnere, ascoltare la cadenza e il tono dei suoi comandi operativi e fornire soluzioni inferiori al secondo direttamente nel flusso di lavoro nativo, l'interfaccia tra operatore umano e macchina digitale raggiunge un livello senza precedenti di coesione meccanica. Il futuro dell'automazione sul posto di lavoro non riguarda l'attesa di una mitica iterazione del modello; riguarda la progettazione di pipeline a bassa latenza che trasformano l'intelligenza esistente in un'estensione naturale e persistente dell'industria umana.



Comments
No comments yet. Be the first!