El problema de la latencia: por qué fallaron las interfaces de voz tradicionales
Para apreciar el logro técnico de la verdadera interacción en tiempo real, primero se deben examinar las ineficiencias acumuladas de los sistemas que la precedieron. Históricamente, interactuar con una inteligencia artificial habilitada por voz implicaba una secuencia de subsistemas desacoplados que operaban en serie. Cuando un usuario hablaba, su señal acústica era capturada, digitalizada y dirigida a un motor de reconocimiento automático de voz (ASR, por sus siglas en inglés), como Whisper de OpenAI. Este motor procesaba la forma de onda, generaba una transcripción textual y pasaba ese paquete de texto al modelo de lenguaje grande principal.
El efecto acumulativo de esta canalización de tres etapas era devastador para una conversación natural. La latencia total de ida y vuelta fluctuaba habitualmente entre dos y cuatro segundos. En aplicaciones prácticas, esta latencia creaba una barrera conversacional inquietante. Los usuarios se veían obligados a hacer pausas, esperar los ciclos de procesamiento y soportar incómodas colisiones conversacionales cada vez que ocurría una interrupción. Además, esta canalización desacoplada sufría una pérdida catastrófica de contexto. Un modelo ASR elimina el tono, la inflexión emocional, el ruido de fondo y la cadencia, reduciendo los datos acústicos ricos a texto ASCII plano. El motor de síntesis en el otro extremo se veía obligado a adivinar el tono apropiado, generando una cadencia estéril y robótica desprovista de conciencia situacional.
La arquitectura Omni: colapsando la canalización
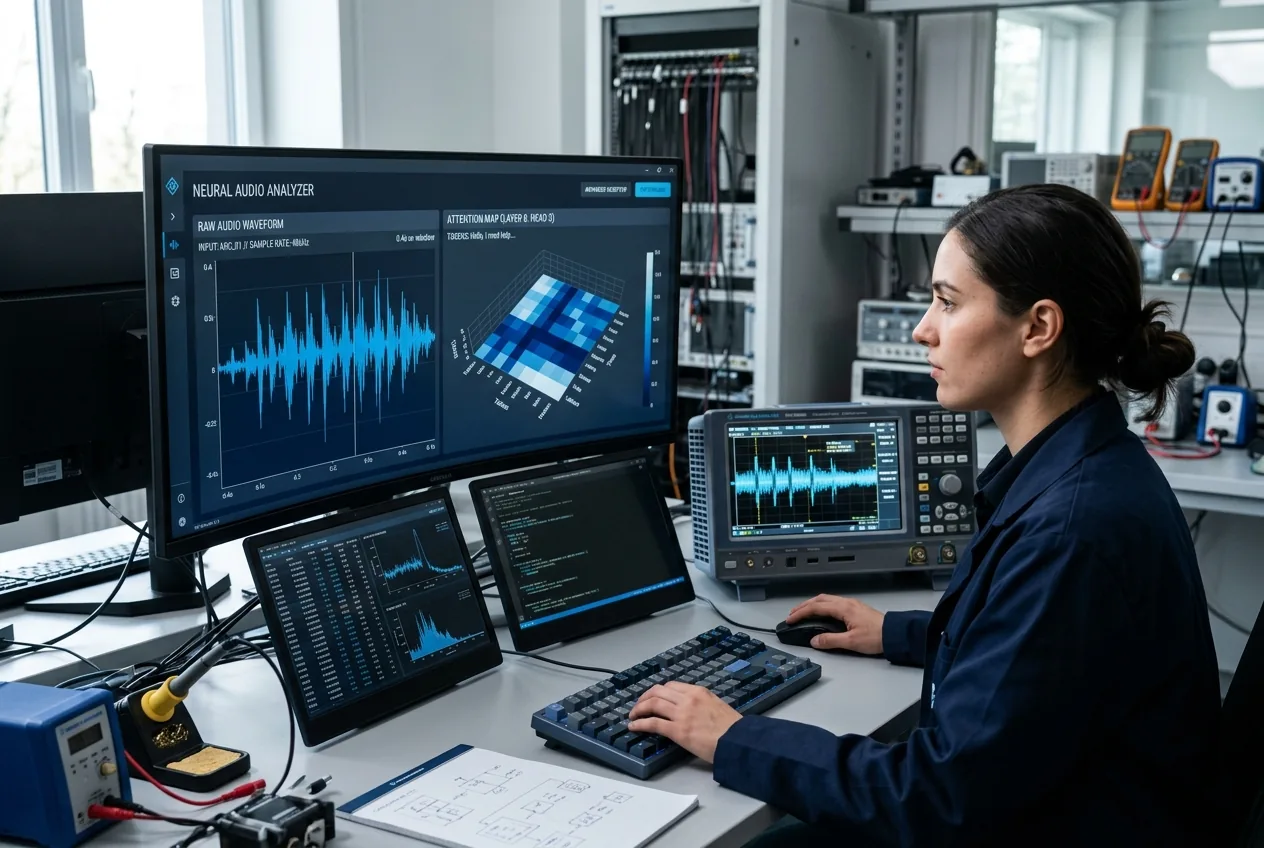
La innovación principal detrás de sistemas como GPT-4o radica en la tokenización unificada. En lugar de tratar el audio, los fotogramas visuales y el texto como modalidades de datos separadas que requieren traducción a representaciones de texto intermedias, una arquitectura omnimodal entrena un único transformador a través de todas las entradas y salidas de forma nativa. Las formas de onda de audio se tokenizan directamente en el espacio latente del modelo, lo que permite a la red neuronal procesar características acústicas junto con tokens de texto semántico dentro de las mismas cabezas de atención.
Esta consolidación arquitectónica elimina por completo las transferencias ASR y TTS. La red recibe tokens de audio brutos o comprimidos y emite los tokens de audio correspondientes directamente, logrando latencias de respuesta tan bajas como 232 milisegundos, con un promedio cercano a los 320 milisegundos. Este margen de rendimiento coincide exactamente con la dinámica de respuesta natural de la conversación humana.
Lo que es más importante, preservar la fidelidad del audio dentro del espacio latente permite una matización bidireccional que los modelos basados únicamente en texto no pueden replicar. La red puede detectar variaciones sutiles en el tono, dudas, tensión vocal y ritmo del habla. A cambio, el modelo puede ajustar dinámicamente su propia salida sintética: modulando el tono, introduciendo pausas deliberadas o hablando más rápidamente en contextos urgentes. Cuando un usuario interrumpe, el modelo no requiere un disyuntor externo para detener la reproducción; el flujo de audio entrante altera inmediatamente los pesos de atención durante los pasos subsiguientes de generación de tokens, cediendo naturalmente el turno de palabra.
Integración de escritorio y la capa del sistema operativo
La baja latencia por sí sola es insuficiente si el modelo permanece atrapado detrás de la pestaña de un navegador web. El trabajo de conocimiento y el monitoreo industrial requieren acceso continuo a entornos operativos contextuales. El impulso de OpenAI para integrar estas capacidades directamente en los sistemas operativos de escritorio, comenzando con aplicaciones cliente dedicadas para macOS y Windows, representa un esfuerzo intencional para capturar la telemetría ambiental de las máquinas.
Una aplicación capaz de capturar buffers de fotogramas directamente desde el sistema operativo evita este cuello de botella en la entrada de datos. Un ingeniero que soluciona problemas en un controlador lógico programable (PLC) de automatización o analiza un ensamblaje en diseño asistido por computadora (CAD) en tiempo real puede desplegar una interfaz de inspección superpuesta al instante. Debido a que el modelo subyacente procesa matrices de imágenes junto con instrucciones de voz naturales, el usuario puede señalar anomalías visuales en la pantalla mientras solicita verbalmente cálculos estructurales o refactorización de código, tratando el buffer de pantalla como un lienzo compartido en lugar de un artefacto aislado.
Escalamiento computacional y la economía de la multimodalidad en tiempo real
Si bien la elegancia arquitectónica de los transformadores multimodales unificados es innegable, ejecutar estos sistemas a escala empresarial presenta desafíos computacionales asombrosos. El audio en tiempo real y la transmisión visual de alta tasa de fotogramas exigen muchos más recursos computacionales que el almacenamiento en caché de clave-valor (KV) convencional basado en texto. Un flujo de audio continuo requiere un muestreo de tokens de alta frecuencia, lo que expande rápidamente la ventana de contexto activa y ejerce una inmensa presión sobre la memoria de los subsistemas de memoria de alto ancho de banda (HBM) dentro de los clústeres aceleradores modernos como las flotas H100 y H200 de Nvidia.
Para que estas capacidades sean viables para cientos de millones de usuarios, los proveedores de infraestructura deben equilibrar la economía de la inferencia con estrictas garantías de Calidad de Servicio (QoS). Esta realidad económica explica por qué los mecanismos de niveles siguen siendo esenciales. Los centros de datos centralizados deben priorizar las asignaciones de cómputo, desplazando sesiones inactivas, limitando la velocidad de flujos de video intensivos y recurriendo a modelos de destilación más pequeños cuando los clústeres de servidores enfrentan picos de capacidad.
Además, la gestión de flujos de audio bidireccionales a través de conexiones a internet variables requiere protocolos de sincronización cliente-servidor robustos. Pequeñas caídas en la transmisión de paquetes que serían imperceptibles en la generación de texto asíncrona pueden causar artefactos audibles, tartamudeo o generación de tokens desincronizada en un entorno de voz en vivo. Equilibrar la baja latencia con códecs de audio tolerantes a pérdidas es una frontera de ingeniería activa que se extiende a caballo entre la inferencia de aprendizaje profundo y la ingeniería de telecomunicaciones clásica.
Más allá del bombo publicitario: la realidad operativa que nos espera
A medida que los observadores de la industria dejan atrás los ciclos especulativos de lanzamiento de modelos y se centran en los fundamentos operativos, el camino a seguir es inequívocamente claro. El valor de la IA generativa en entornos empresariales no se medirá por diferenciales de puntos de referencia en pruebas estandarizadas abstractas. En cambio, se evaluará según la latencia determinista, la profundidad de integración en la plataforma y la capacidad del modelo para actuar como un puente sin trabas entre los operadores humanos y los entornos de software complejos.
Mover el procesamiento computacional fuera de canalizaciones aisladas y hacia redes multimodales nativas establece la base para agentes verdaderamente autónomos. Cuando un sistema de IA puede ver simultáneamente la pantalla del ingeniero, escuchar la cadencia y el tono de sus comandos operativos y entregar soluciones de sub-segundo directamente en el flujo de trabajo nativo, la interfaz entre el operador humano y la máquina digital alcanza un nivel de cohesión mecánica sin precedentes. El futuro de la automatización en el lugar de trabajo no consiste en esperar una iteración mítica del modelo; se trata de diseñar las canalizaciones de baja latencia que conviertan la inteligencia existente en una extensión natural y persistente de la industria humana.



Comments
No comments yet. Be the first!