Le problème de la latence : pourquoi les interfaces vocales héritées ont trébuché
Pour apprécier la prouesse technique d'une véritable interaction en temps réel, il faut d'abord examiner les inefficacités cumulées des systèmes qui l'ont précédée. Historiquement, interagir avec une intelligence artificielle vocale impliquait une séquence de sous-systèmes découplés fonctionnant en série. Lorsqu'un utilisateur parlait, son signal acoustique était capturé, numérisé et acheminé vers un moteur de reconnaissance automatique de la parole (ASR), tel que Whisper d'OpenAI. Ce moteur traitait la forme d'onde, générait une transcription textuelle et transmettait cette charge utile textuelle au grand modèle de langage principal.
L'effet cumulatif de ce pipeline en trois étapes était dévastateur pour la conversation naturelle. La latence totale des échanges oscillait régulièrement entre deux et quatre secondes. Dans les applications pratiques, cette latence créait une barrière conversationnelle déconcertante. Les utilisateurs étaient contraints de faire des pauses, d'attendre les cycles de traitement et de subir des chevauchements conversationnels gênants à chaque interruption. De plus, ce pipeline découplé souffrait d'une perte de contexte catastrophique. Un modèle ASR supprime la hauteur tonale, l'inflexion émotionnelle, le bruit de fond et la cadence, réduisant les données acoustiques riches à un texte ASCII plat. Le moteur de synthèse à l'autre extrémité était alors réduit à deviner le ton approprié, générant une cadence stérile et robotique dépourvue de conscience situationnelle.
L'architecture Omni : faire s'effondrer le pipeline
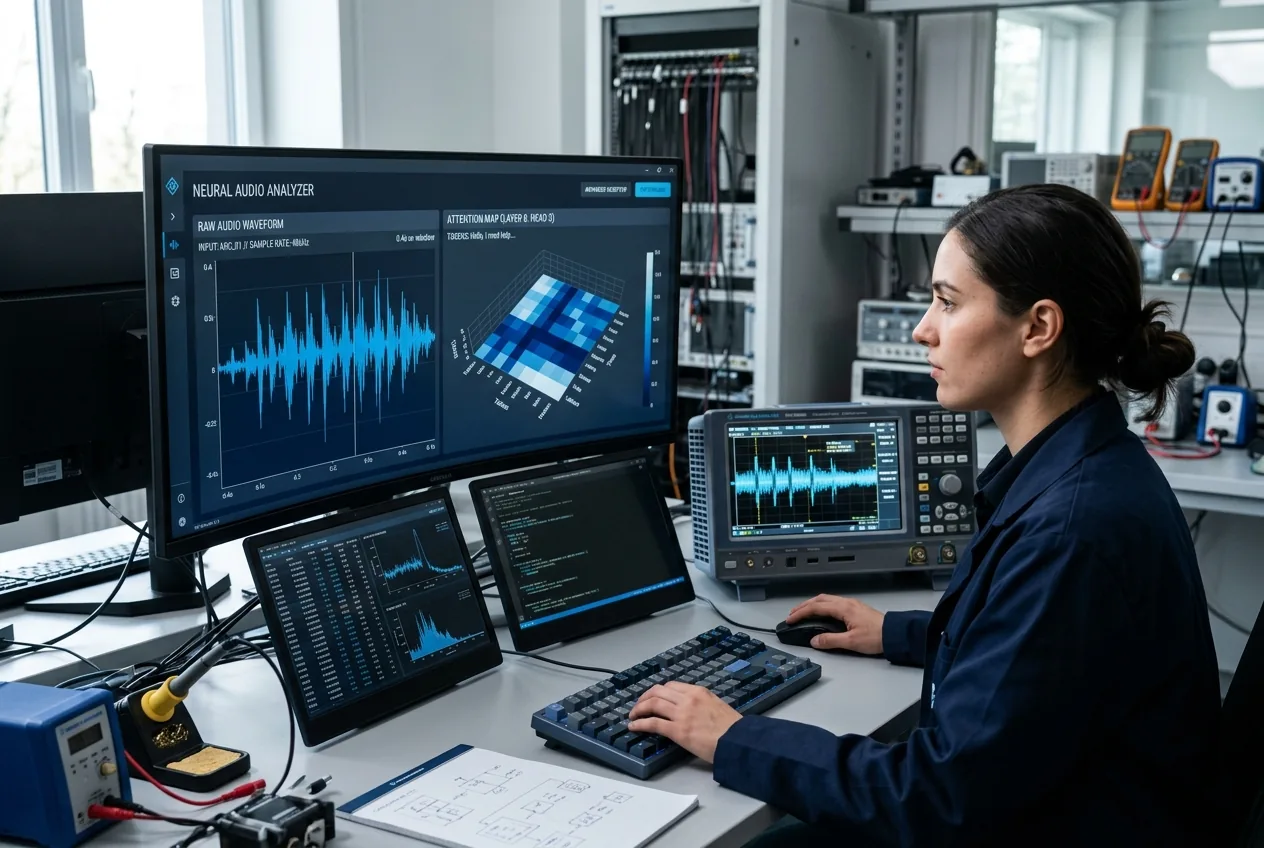
L'innovation principale derrière des systèmes comme GPT-4o réside dans la tokenisation unifiée. Plutôt que de traiter l'audio, les images visuelles et le texte comme des modalités de données distinctes nécessitant une traduction en représentations textuelles intermédiaires, une architecture omni-modale entraîne un seul transformeur sur toutes les entrées et sorties de manière native. Les formes d'onde audio sont tokenisées directement dans l'espace latent du modèle, permettant au réseau neuronal de traiter les caractéristiques acoustiques aux côtés des jetons textuels sémantiques au sein des mêmes têtes d'attention.
Cette consolidation architecturale élimine totalement les transferts ASR et TTS. Le réseau reçoit des jetons audio bruts ou compressés et émet des jetons audio correspondants directement, atteignant des latences de réponse aussi faibles que 232 millisecondes, avec une moyenne se situant autour de 320 millisecondes. Cette enveloppe de performance correspond précisément à la dynamique de réponse naturelle d'une conversation entre humains.
Plus important encore, la préservation de la fidélité audio dans l'espace latent permet une nuance bidirectionnelle que les modèles textuels ne peuvent reproduire. Le réseau peut détecter des variations subtiles dans la hauteur tonale, l'hésitation, la tension vocale et le rythme de la parole. En retour, le modèle peut ajuster dynamiquement sa propre sortie synthétique — modulant le ton, introduisant des pauses délibérées ou parlant plus rapidement dans des contextes urgents. Lorsqu'un utilisateur interrompt, le modèle n'a pas besoin d'un coupe-circuit externe pour arrêter la lecture ; le flux audio entrant modifie immédiatement les poids d'attention pendant les étapes ultérieures de génération de jetons, cédant naturellement la parole.
Intégration au bureau et couche du système d'exploitation
Une faible latence est insuffisante si le modèle reste piégé derrière un onglet de navigateur web. Le travail intellectuel et la surveillance industrielle nécessitent un accès continu aux environnements d'exploitation contextuels. La volonté d'OpenAI d'intégrer ces capacités directement dans les systèmes d'exploitation de bureau, en commençant par des applications clientes dédiées pour macOS et Windows, représente un effort intentionnel pour capturer la télémétrie ambiante des machines.
Une application capable de capturer des tampons de trames directement depuis le système d'exploitation contourne ce goulot d'étranglement de saisie de données. Un ingénieur dépannant un automate programmable industriel (API) ou analysant un assemblage de conception assistée par ordinateur (CAO) en temps réel peut faire apparaître instantanément une interface d'inspection en superposition. Comme le modèle sous-jacent traite les matrices d'images parallèlement aux instructions vocales naturelles, l'utilisateur peut pointer des anomalies visuelles sur l'écran tout en demandant verbalement des calculs structurels ou une refactorisation de code, traitant le tampon d'écran comme un canevas partagé plutôt que comme un artefact isolé.
Mise à l'échelle du calcul et économie de la multimodalité en temps réel
Bien que l'élégance architecturale des transformeurs multimodaux unifiés soit indéniable, l'exécution de ces systèmes à l'échelle de l'entreprise présente des défis informatiques stupéfiants. L'audio en temps réel et le streaming visuel à haute fréquence d'images exigent beaucoup plus de ressources de calcul que la mise en cache conventionnelle de clés-valeurs (KV) basée sur le texte. Un flux audio continu nécessite un échantillonnage de jetons à haute fréquence, étendant rapidement la fenêtre de contexte active et exerçant une pression immense sur les sous-systèmes de mémoire à large bande passante (HBM) au sein des clusters d'accélérateurs modernes comme les flottes H100 et H200 de Nvidia.
Pour rendre ces capacités viables pour des centaines de millions d'utilisateurs, les fournisseurs d'infrastructure doivent équilibrer l'économie de l'inférence avec des garanties strictes de qualité de service (QoS). Cette réalité économique explique pourquoi les mécanismes de hiérarchisation restent essentiels. Les centres de données centralisés doivent prioriser les allocations de calcul, déplacer les sessions inactives, limiter le débit des flux vidéo intensifs et recourir à des modèles de distillation plus petits lorsque les clusters de serveurs font face à des pics de capacité.
De plus, la gestion des flux audio bidirectionnels sur des connexions Internet variables nécessite des protocoles de synchronisation client-serveur robustes. De petites pertes de paquets de transmission, imperceptibles dans une génération de texte asynchrone, peuvent provoquer des artefacts audibles, des bégaiements ou une génération de jetons désynchronisée dans un environnement vocal en direct. Équilibrer une faible latence avec des codecs audio tolérants aux pertes est une frontière d'ingénierie active qui chevauche la limite entre l'inférence par apprentissage profond et l'ingénierie des télécommunications classiques.
Au-delà du battage médiatique : la réalité opérationnelle à venir
Alors que les observateurs de l'industrie tournent le regard au-delà des cycles de sortie de modèles spéculatifs pour se concentrer sur les fondamentaux opérationnels, la voie à suivre est indiscutablement claire. La valeur de l'IA générative dans les environnements d'entreprise ne sera pas mesurée par les différentiels de points de référence lors de tests standardisés abstraits. Au lieu de cela, elle sera évaluée sur la latence déterministe, la profondeur d'intégration à la plateforme et la capacité du modèle à agir comme un pont sans entrave entre les opérateurs humains et les environnements logiciels complexes.
Déplacer le traitement informatique hors des pipelines cloisonnés vers des réseaux multimodaux natifs établit les bases d'agents véritablement autonomes. Lorsqu'un système d'IA peut simultanément voir l'écran de l'ingénieur, entendre la cadence et le ton de ses commandes opérationnelles, et fournir des solutions en moins d'une seconde directement dans le flux de travail natif, l'interface entre l'opérateur humain et la machine numérique atteint un niveau inédit de cohésion mécanique. L'avenir de l'automatisation du travail ne consiste pas à attendre une itération mythique de modèle ; il s'agit de concevoir les pipelines à faible latence qui transforment l'intelligence existante en une extension naturelle et persistante de l'industrie humaine.



Comments
No comments yet. Be the first!