延迟问题:为何传统语音接口会“绊倒”
要理解实现真正实时交互的技术成就,首先必须审视其前身系统累积的低效性。从历史上看,与支持语音的人工智能交互涉及一系列串行运行的解耦子系统。当用户说话时,其音频信号会被捕获、数字化,并路由至自动语音识别(ASR)引擎(例如 OpenAI 的 Whisper)。该引擎处理波形、生成文本转录,并将该文本载荷传递给主大型语言模型。
这种三阶段流水线的累积效应对于自然对话而言是毁灭性的。总往返延迟通常在两到四秒之间波动。在实际应用中,这种延迟产生了一种不可思议的对话障碍。用户被迫停顿、等待处理周期,并不得不忍受每次中断时出现的尴尬对话碰撞。此外,这种解耦流水线还会遭受严重的上下文丢失。ASR 模型会剥离音高、情感表达、背景噪音和节奏,将丰富的声学数据简化为平面的 ASCII 文本。另一端的合成引擎只能猜测合适的语调,从而生成缺乏情境感知、机械呆板的节奏。
Omni 架构:折叠流水线
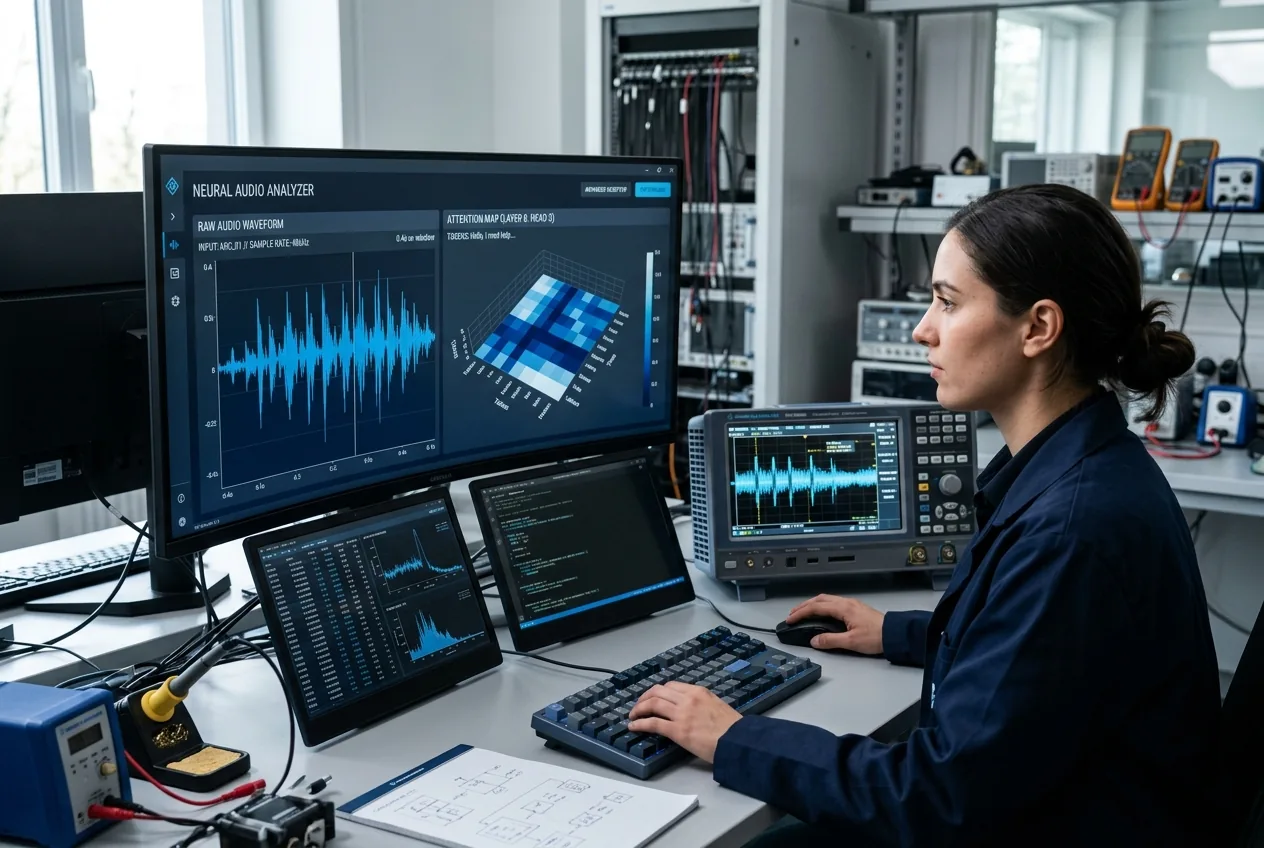
GPT-4o 等系统背后的核心创新在于统一标记化(Unified Tokenization)。全模态(omni-modal)架构并没有将音频、视觉帧和文本视为需要转换为中间文本表示的独立数据模态,而是训练了一个在所有输入和输出上进行原生处理的单一 Transformer。音频波形被直接标记化进入模型的潜在空间(latent space),使神经网络能够在完全相同的注意力头中并行处理声学特征与语义文本标记。
这种架构整合完全消除了 ASR 和 TTS 的切换。网络接收原始或压缩的音频标记,并直接输出相应的音频标记,实现了低至 232 毫秒的响应延迟,平均响应时间保持在 320 毫秒左右。这一性能指标与人类对话的自然响应动态完美匹配。
更重要的是,在潜在空间内保持音频保真度实现了纯文本模型无法复制的双向细微差别。网络可以检测音高、犹豫、声带压力和语速的细微变化。作为反馈,模型可以动态调整其自身的合成输出——调节语调、引入刻意的停顿,或在紧急语境下加快语速。当用户打断时,模型不需要外部断路器来停止播放;输入的音频流会立即在随后的标记生成步骤中改变注意力权重,从而自然地交出对话主导权。
桌面集成与操作系统层
如果模型仍被困在网页浏览器标签页中,仅有低延迟是不够的。知识工作和工业监控需要持续访问上下文操作环境。OpenAI 推动将这些功能直接嵌入桌面操作系统(始于 macOS 和 Windows 的专用客户端应用程序),代表了捕获环境机器遥测数据的刻意尝试。
能够直接从操作系统捕获帧缓冲区的应用程序绕过了这种数据录入瓶颈。负责故障排除自动化可编程逻辑控制器(PLC)或分析实时计算机辅助设计(CAD)装配的工程师可以立即调出覆盖式检查界面。由于底层模型与自然语音指令一起处理图像矩阵,用户可以在屏幕上指出视觉异常,同时口头询问结构计算或代码重构,将屏幕缓冲区视为画布而非孤立的工件。
算力扩展与实时多模态的经济学
尽管统一多模态 Transformer 的架构优雅性不可否认,但在企业规模下运行这些系统带来了巨大的计算挑战。实时音频和高帧率视觉流比传统的基于文本的键值(KV)缓存需要更多的计算资源。连续的音频流需要高频标记采样,这会迅速扩展活动上下文窗口,并对 Nvidia H100 和 H200 等现代加速器集群内部的高带宽内存(HBM)子系统造成巨大的内存压力。
为了使这些功能能够惠及数亿用户,基础设施提供商必须平衡推理经济性与严格的服务质量(QoS)保证。这种经济现实解释了为什么分级机制仍然至关重要。集中式数据中心必须优先分配算力,转移空闲会话、限制密集视频流的速率,并在服务器集群面临峰值容量压力时回退到较小的蒸馏模型。
此外,通过不稳定的互联网连接管理双向音频流需要强大的客户端-服务器同步协议。在异步文本生成中无法察觉的小型数据包传输丢失,在实时语音环境中可能导致可听到的伪影、卡顿或标记生成不同步。在平衡低延迟与容损音频编解码器方面,是一个跨越深度学习推理与经典电信工程边界的前沿工程领域。
超越炒作:未来的运营现实
随着行业观察者不再关注推测性的模型发布周期,转而关注运营基本面,前进的道路已清晰可见。生成式 AI 在企业环境中的价值将不再由抽象标准化测试中的基准分数差异来衡量。相反,它将通过确定性延迟、平台集成深度以及模型作为人类操作员与复杂软件环境之间无障碍桥梁的能力来评估。
将计算处理从孤立的流水线转移到原生多模态网络,为真正的自主代理奠定了基础。当 AI 系统能够同时看到工程师的屏幕、听到其操作指令的节奏和语调,并将亚秒级的解决方案直接传回原生工作流时,人类操作员与数字机器之间的接口将达到前所未有的机械凝聚水平。工作场所自动化的未来不在于等待神话般的模型迭代;而在于构建能够将现有智能转化为人类工业自然、持久延伸的低延迟流水线。



Comments
No comments yet. Be the first!