Eine plötzliche Welle von Branchenberichten und Leaks aus der Lieferkette hat die Sektor der Künstlichen Intelligenz in Aufruhr versetzt. Sie behaupten, dass OpenAI die Bereitstellung eines Frontier-Modells mit 10 Billionen Parametern unter dem Codenamen Astra vorbereitet, das inoffiziell als GPT-6 positioniert wird. Laut kursierenden Enthüllungen aus spezialisierten technischen Tracking-Feeds und Finanzplattformen stellt das Modell eine aggressive Verfünffachung gegenüber den geschätzten 1,8 Billionen Parametern von GPT-4 dar. Begleitende Berichte deuten auf ein noch größeres sekundäres System mit dem Codenamen Doug hin, dessen Einführung für Ende des Jahres geplant ist und das als technologische Gegenoffensive gegen die kommende Architektur-Generation von Anthropic dargestellt wird.
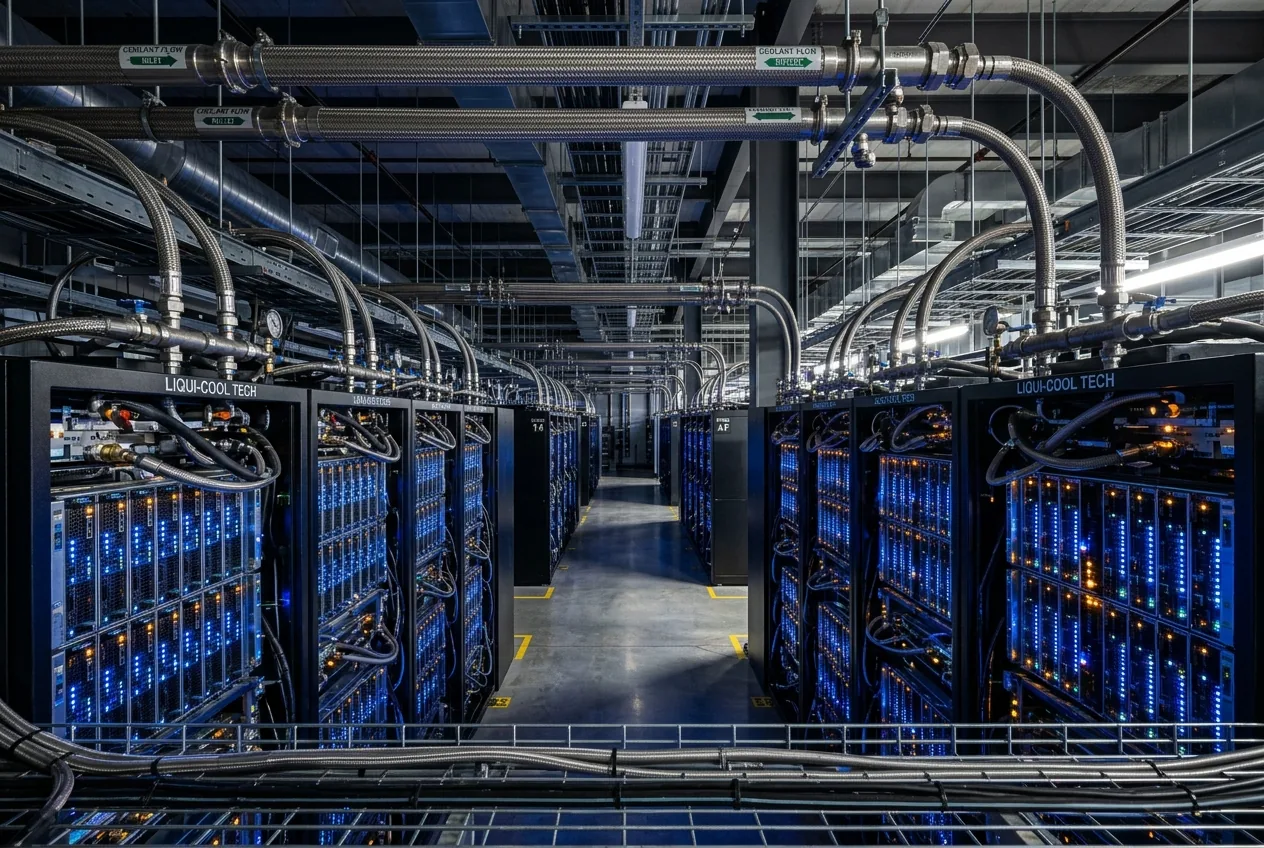
Während spekulative Leaks zu unveröffentlichten Basismodellen regelmäßig in den sozialen Medien kursieren, rechtfertigt die technische Spezifität der neuesten Berichte eine genaue Prüfung aus Ingenieurs- und Infrastruktursicht. Der Wechsel von einer Mixture-of-Experts-Architektur mit weniger als zwei Billionen Parametern zu einer Basis von zehn Billionen Parametern ist keine triviale lineare Skalierungsübung. Es handelt sich um eine kategorische Eskalation bei Rechen-Topologie, Speicherbandbreitenanforderungen, optischem Netzwerk-Fabric und einer Wärmeabfuhr im Multi-Megawatt-Bereich, die die physikalischen Grenzen aktueller Rechenzentrumshardware strapaziert.
Um zu bewerten, ob ein 10-Billionen-Parameter-Modell realistischerweise von experimentellen Pre-Training-Clustern in kommerzielle Inferenzumgebungen überführt werden kann, muss man den spekulativen Hype beiseitelegen und die zugrunde liegende Thermodynamik, die Interconnect-Bandbreite und die Silizium-Beschränkungen analysieren, die moderne Machine-Learning-Systeme bestimmen.
Die mathematische Realität eines 10-Billionen-Parameter-Footprints
In modernen Deep-Learning-Architekturen diktiert die Parametergröße direkt den rohen Speicherbedarf, bevor auch nur ein einziges Token des Aktivierungsspeichers oder des Kontext-Caches berechnet wird. Wenn Astra eine 16-Bit-Gleitkommadarstellung (bfloat16 oder FP16) verwendet, erfordert das Speichern von zehn Billionen Gewichten etwa 20 Terabyte an statischem Speicher allein für die Modellvorhaltung. Selbst bei aggressiver 8-Bit-Quantisierung (FP8), die zum Standard für modernes Enterprise-Pre-Training und Hochleistungs-Inferenz geworden ist, erfordert die rohe statische Gewichtslast mindestens 10 Terabyte an ultraschnellem Speicher, der über einen vereinheitlichten Cluster verteilt ist.
Dieser statische Fußabdruck erweitert sich exponentiell, wenn man den dynamischen Speicher berücksichtigt, der für erweiterte Kontextfenster erforderlich ist. Kursierende Berichte deuten auf Kontextlängen von bis zu 1,5 Millionen Token hin, eine Fähigkeit, die massive Engpässe bei der Speicherung des Key-Value (KV) Caches einführt. In Standard-Multi-Head-Attention-Mechanismen skaliert der KV-Cache linear sowohl mit der Sequenzlänge als auch mit der Batch-Größe, was terabyteweise zusätzliche Kapazität über den Cluster hinweg erfordert. Ohne ausgefeilte architektonische Eingriffe – wie Grouped-Query Attention (GQA), Multi-Latent-Attention-Sharding oder starke Kontextkompression – wird der Hardware-Aufwand, der erforderlich ist, um auch nur eine einzige Benutzersitzung mit geringer Auslastung zu bedienen, kommerziell unerschwinglich.
Folglich beruht jede tragfähige 10-Billionen-Parameter-Architektur mit ziemlicher Sicherheit eher auf Sparse-Routing als auf dichter Berechnung. Wenn Astra als ultra-breites Mixture-of-Experts-System (MoE) implementiert ist, würde nur ein Bruchteil seiner Gesamtparameter – vielleicht 500 bis 800 Milliarden – pro Token aktiviert. Während MoE-Modelle die Gesamtkapazität der Parameter von den FLOP-Anforderungen pro Forward-Pass entkoppeln, entlasten sie nicht die physische Speicheranforderung. Jeder einzelne Parameter muss im High-Bandwidth Memory (HBM) über Tausende von vernetzten Beschleunigern hinweg resident bleiben, um akzeptable Latenzschwellen einzuhalten.
Hat OpenAI endlich die Pre-Training-Mauer durchbrochen?
Seit mehr als vierundzwanzig Monaten kämpft die Entwicklung von Frontier-KI mit dem, was Forscher als die Pre-Training-Mauer bezeichnen. Während Modelle wie die o-Serie zeigten, dass Test-Time-Compute – die Zuweisung von Inferenz-FLOPs an Chain-of-Thought-Verifizierung und Monte-Carlo-Baumsuche – sprunghafte Gewinne bei der mathematischen und programmiertechnischen Logik freisetzen könnte, blieben die zugrunde liegenden, vortrainierten Basismodelle weitgehend inkrementelle Weiterentwicklungen der Grundlagen von 2023. Algorithmische Engpässe, die Erschöpfung hochwertiger menschlicher Texte und katastrophale Divergenz der Loss-Funktion bei extremen Skalen zwangen Labore dazu, sich auf Verfeinerungen nach dem Training (Post-Training) statt auf Pre-Training-Sprünge mit roher Gewalt zu verlassen.
Die Überwindung dieses Plateaus erfordert mehr, als nur zusätzliche Beschleuniger-Knoten auf einen Standard-Transformer zu werfen. Stabile Trainingsläufe dieser Größenordnung erfordern umfassende Pipelines zur Generierung synthetischer Daten, automatisiertes Curriculum-Filtering und neuartige Regime für die Optimiererstabilität, um Gradientenexplosionen zu verhindern. Branchengerüchte, die auf interne explorative Prototypen mit dem Codenamen Garlic hinweisen, deuten darauf hin, dass die Ingenieure von OpenAI Monate damit verbrachten, kritische Trainingsinstabilitäten zu beheben, bevor sie die Architektur auf die für Astra und Doug erforderliche Clustergröße skalierten.
Wenn die geleakten Parameter tatsächliche Produktionsläufe widerspiegeln, bestätigen sie, dass die Skalierungsgesetze für das Pre-Training keine dauerhafte mathematische Obergrenze erreicht haben. Stattdessen scheint die Mauer ein Hindernis für Infrastruktur und Optimierung gewesen zu sein. Der Nachweis einer stabilen Konvergenz über Billionen von Token hinweg auf der 10-Billionen-Parameter-Skala signalisiert, dass algorithmische Durchbrüche bei der Loss-Stabilisierung und kuratierten synthetischen Datentopologien die Lücke zwischen theoretischen Skalierungskurven und physikalischer Realität erfolgreich geschlossen haben.
Das Compute-Fabric: Silizium-Interconnects und Cluster-Überlebensfähigkeit
Die Durchführung eines Pre-Training-Laufs, der 10 Billionen Parameter aufnehmen kann, erfordert zehntausende modernster Beschleuniger, die monatelang im synchronen Gleichschritt arbeiten. Bei dieser Größenordnung sind die dominierenden Ausfallmodi nicht mehr algorithmisch; sie sind mechanisch, elektrisch und thermisch. Die mittlere Zeit zwischen Ausfällen (MTBF) für einzelne Komponenten in einem Cluster mit 80.000 Beschleunigern wird in Stunden gemessen, nicht in Wochen. Ein tragfähiger Trainingslauf in diesem Maßstab hängt von automatisiertem, verteiltem Checkpointing, schneller Fehlerbehebung und blockierungsfreien optischen Switching-Fabrics ab, die verhindern, dass isolierte Hardware-Ausfälle die gesamte Gradienten-Aggregations-Pipeline korrumpieren.
Gerüchte, die das größere Doug-Modell für Ende des Jahres mit Siliziumarchitekturen der nächsten Generation, wie NVIDIAs kommender Vera-Rubin-Plattform, in Verbindung bringen, unterstreichen die sich verändernden Hardware-Paradigmen, die zur Aufrechterhaltung dieser Workloads erforderlich sind. Hopper-Cluster (H100/H200) und Blackwell-Cluster (B200) der aktuellen Generation stehen vor schwerwiegenden Bandbreitenengpässen bei der Skalierung der Tensor-Parallelität über nicht benachbarte Racks hinweg. Ultradichte Modelle erfordern mehrdimensionale Modellparallelität – die Kombination von Tensor-Sharding im Megatron-Stil, Pipeline-Parallelität und Fully Sharded Data Parallel (FSDP)-Konfigurationen –, was einen enormen Druck auf die Bisektionsbandbreite ausübt.
Parallelberichte über die Entwicklung eines proprietären internen Inferenz-ASICs durch OpenAI, umgangssprachlich unter internen Projektbezeichnungen wie Jalapeño geführt, deuten darauf hin, dass sich das Unternehmen der Falle der Inferenz-Ökonomie durchaus bewusst ist. Sich vollständig auf Allzweck-GPUs zu verlassen, um eine Architektur mit 10 Billionen Parametern im globalen Maßstab zu bedienen, würde eine unhaltbare Belastung für Stromverbrauch und Margen bedeuten. Dediziertes Inferenz-Silizium, das speziell auf Tensor-Operationen mit niedriger Präzision, extreme Speicherbandbreite und statisches Sparse-Routing optimiert ist, stellt den einzig wirtschaftlich tragfähigen Weg zur Kommerzialisierung von Modellen dieser Größenordnung dar, ohne ganze regionale Stromnetze zu beanspruchen.
Können Unternehmensökonomien die Inferenz mit zehn Billionen Parametern rechtfertigen?
Die zentrale Frage, mit der sich Maschinenbauingenieure, Rechenzentrumsbetreiber und Führungskräfte in der Technologiebranche konfrontiert sehen, ist, ob die marginalen Intelligenzgewinne eines Systems mit 10 Billionen Parametern die erschütternden thermodynamischen und finanziellen Betriebskosten rechtfertigen. Bei einem Einsatz in Industrie oder Unternehmen ist jeder API-Aufruf mit Betriebskosten verbunden, die direkt an die verbrauchten Kilowattstunden, den Kühlaufwand für Racks und die Abschreibung des Siliziums gekoppelt sind. Wenn ein System mit 10 Billionen Parametern mehrere Megawatt dedizierte Dauerleistung allein dafür benötigt, um die aktiven Gewichte im Speicher zu halten, muss der Preis pro generiertem Token erheblich steigen.
Unternehmen haben bereits eine wachsende Kostensensibilität bewiesen und entscheiden sich häufig für destillierte, quantisierte oder domänenspezifische Modelle mit 8 bis 70 Milliarden Parametern, die effizient auf lokalen Edge-Servern oder kostengünstigen Cloud-Instanzen laufen. Ein monolithisches oder ultrabreites Frontier-Modell kann nicht nur marginale Verbesserungen der Konversationsflüssigkeit liefern, um seine Existenz zu rechtfertigen. Es muss eindeutige, unternehmenskritische Kompetenzen bei komplexem Zero-Shot-Reasoning, autonomer, mehrstufiger Software-Synthese, fortschrittlicher mechanischer Simulation oder hochdimensionaler wissenschaftlicher Analyse demonstrieren, bei denen die Kosten eines Scheiterns die hohen API-Preise bei weitem übersteigen.
Darüber hinaus hat sich die Verfügbarkeit von Strom für Rechenzentren als die primäre geopolitische Einschränkung der Tech-Infrastruktur herauskristallisiert. Große städtische Versorgungsnetze sehen sich mit mehrjährigen Verzögerungen bei der Genehmigung von Anschlüssen für Anlagen konfrontiert, die mehr als 100 Megawatt benötigen. Der Betrieb von Modellen in der Größenordnung von Astra und Doug zwingt Frontier-Labore dazu, Stromabnahmeverträge parallel zu Übertragungskorridoren im Versorgungsmaßstab auszuhandeln, wodurch Softwarekapazitäten grundlegend an die physischen Grenzen der Schwerstromtechnik und der Flüssigkeitskühlungsinfrastruktur geknüpft werden.
Die sich verengende Grenze und das beschleunigte Rennen
Das intensive Tempo gleichzeitiger Entwicklungen – einschließlich geleakter Gegenstrategien von Anthropic, die iterative Veröffentlichungen seiner Fable- und Mythos-Architekturen beinhalten, sowie plötzlicher Führungswechsel innerhalb konkurrierender Legacy-Forschungslabore – unterstreicht eine aggressive Konsolidierung an der Grenze der Künstlichen Intelligenz. Die finanzielle und infrastrukturelle Eintrittsbarriere für das Training von Frontier-Basis-Modellen ist inzwischen auf Milliarden von Dollar pro individuellem Trainings-Cluster gestiegen, was das primäre Rennen effektiv auf eine Handvoll außergewöhnlich gut kapitalisierter Unternehmen verengt.
Ob Astra innerhalb weniger Wochen in öffentlichen Unternehmenskanälen auftaucht oder hinter kontrollierten Cybersecurity-Red-Teaming-Protokollen beschränkt bleibt, die technische Flugbahn ist unverkennbar. Die Ära, in der man sich ausschließlich auf Inferenz-Tricks nach dem Training verließ, um strukturelle Intelligenzgewinne vorzutäuschen, scheint in eine aggressive Rückkehr zur Skalierung überzugehen. Wenn OpenAI eine 10-Billionen-Parameter-Maschine erfolgreich stabilisiert hat, wird die industrielle KI-Landschaft erneut gezwungen sein, ihre Erwartungen daran neu zu kalibrieren, was Rechendichte, Rechenzentrumstechnik und Hardware-Infrastruktur physisch leisten können.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!