Une vague soudaine de rapports de l'industrie et de fuites dans la chaîne d'approvisionnement a fait trembler le secteur de l'intelligence artificielle, alléguant qu'OpenAI se prépare à déployer un modèle de pointe de 10 000 milliards de paramètres, portant le nom de code Astra et officieusement positionné comme étant GPT-6. Selon des révélations circulant sur des fils de suivi technique spécialisés et des plateformes financières, ce modèle représente une expansion agressive par rapport aux 1 800 milliards de paramètres estimés de GPT-4, soit une multiplication par cinq. Des rapports concomitants font état d'un système secondaire encore plus vaste, baptisé Doug, prévu pour un déploiement en fin d'année, présenté comme une contre-offensive technique face aux prochaines architectures de nouvelle génération d'Anthropic.
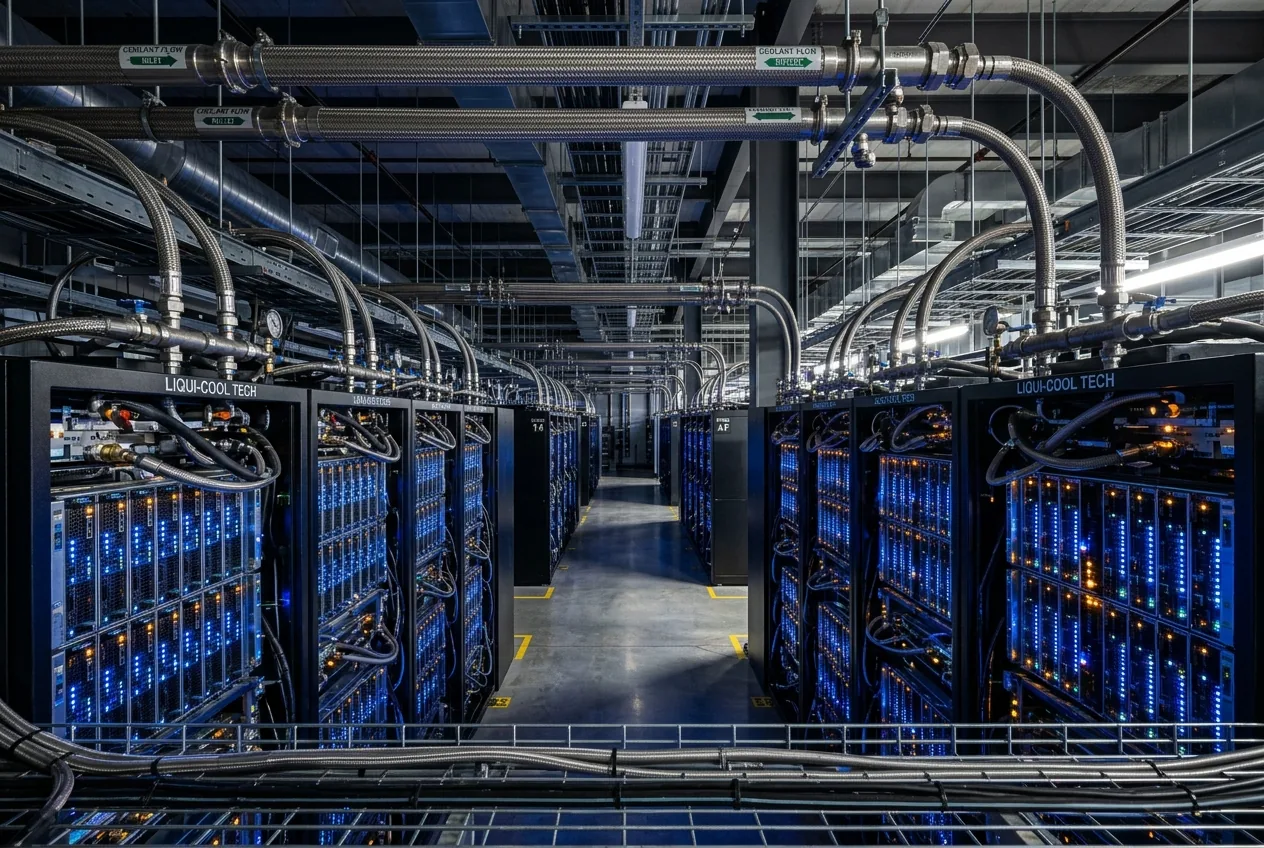
Bien que les fuites spéculatives concernant les modèles de fondation inédits prolifèrent régulièrement sur les réseaux sociaux, la précision technique des derniers rapports mérite un examen rigoureux sous l'angle de l'ingénierie et de l'infrastructure. Passer d'une architecture Mixture-of-Experts (MoE) de moins de deux mille milliards de paramètres à une base de dix mille milliards n'est pas un simple exercice de mise à l'échelle linéaire. Il s'agit d'une escalade catégorique en termes de topologie de calcul, de demande en mémoire à large bande passante (HBM), de structure de réseau optique et de dissipation thermique de plusieurs mégawatts, qui met à rude épreuve les limites physiques du matériel actuel des centres de données.
Pour évaluer si un modèle de 10 000 milliards de paramètres peut passer de manière réaliste des clusters de pré-entraînement expérimentaux aux environnements d'inférence commerciale, il faut écarter le battage médiatique spéculatif et analyser la thermodynamique sous-jacente, la bande passante d'interconnexion et les contraintes liées au silicium qui régissent les systèmes d'apprentissage automatique contemporains.
La réalité mathématique d'une empreinte de 10 000 milliards de paramètres
Dans les architectures d'apprentissage profond modernes, l'échelle des paramètres dicte directement la surcharge mémoire brute avant même qu'un seul jeton (token) de mémoire d'activation ou de cache de contexte ne soit calculé. Si Astra utilise une représentation en virgule flottante 16 bits (bfloat16 ou FP16), le stockage de dix mille milliards de poids nécessite environ 20 téraoctets de mémoire statique uniquement pour la rétention du modèle. Même avec une quantification agressive à 8 bits (FP8), devenue la norme pour le pré-entraînement en entreprise et l'inférence haute performance, la charge utile brute des poids statiques exige un minimum de 10 téraoctets de mémoire ultrarapide répartie sur un cluster unifié.
Cette empreinte statique augmente de façon exponentielle si l'on prend en compte la mémoire dynamique nécessaire aux fenêtres de contexte étendues. Les rapports qui circulent suggèrent des longueurs de contexte allant jusqu'à 1,5 million de jetons, une capacité qui introduit des goulots d'étranglement massifs pour le stockage du cache Clé-Valeur (KV). Dans les mécanismes d'attention multi-têtes standard, le cache KV évolue linéairement avec la longueur de la séquence et la taille des lots, exigeant des téraoctets de capacité supplémentaire dans le cluster. Sans interventions architecturales sophistiquées — telles que l'attention par groupes de requêtes (GQA), le partitionnement de l'attention multi-latente ou une compression de contexte sévère — l'empreinte matérielle nécessaire pour servir ne serait-ce qu'une seule session utilisateur à faible concurrence devient commercialement prohibitive.
Par conséquent, toute architecture viable de 10 000 milliards de paramètres repose presque certainement sur le routage épars (sparse) plutôt que sur le calcul dense. Si Astra est mis en œuvre sous forme de système Mixture-of-Experts (MoE) ultra-large, seule une fraction de ses paramètres totaux — peut-être 500 à 800 milliards — serait activée par jeton. Si les modèles MoE découplent la capacité totale des paramètres des besoins en FLOP par passe directe, ils ne suppriment pas l'exigence de mémoire physique. Chaque paramètre doit rester résident dans la mémoire à large bande passante (HBM) à travers des milliers d'accélérateurs en réseau pour maintenir des seuils de latence acceptables.
OpenAI a-t-il enfin franchi le mur du pré-entraînement ?
Pendant plus de vingt-quatre mois, le développement de l'IA de pointe a été confronté à ce que les chercheurs décrivent comme le "mur du pré-entraînement". Si des modèles tels que la série o ont démontré que le calcul au moment du test — en allouant des FLOP d'inférence à la vérification par chaîne de pensée et à la recherche arborescente de Monte Carlo — pouvait débloquer des gains substantiels en logique mathématique et en codage, les modèles de base pré-entraînés sous-jacents restaient largement des évolutions incrémentales des fondations de 2023. Les goulots d'étranglement algorithmiques, l'épuisement des textes humains de haute qualité et la divergence catastrophique des pertes à des échelles extrêmes ont contraint les laboratoires à s'appuyer sur le raffinement post-entraînement plutôt que sur des bonds de pré-entraînement par force brute.
Surmonter ce plateau nécessite bien plus que l'ajout de nœuds d'accélération supplémentaires à un transformeur standard. Des entraînements stables de cette magnitude exigent des pipelines complets de génération de données synthétiques, un filtrage automatisé des programmes d'entraînement et de nouveaux régimes de stabilité des optimiseurs pour éviter les explosions de gradients. Les rumeurs du secteur concernant des prototypes exploratoires internes nommés Garlic suggèrent que les ingénieurs d'OpenAI ont passé des mois à résoudre des instabilités d'entraînement critiques avant de faire évoluer l'architecture à la taille de cluster requise pour Astra et Doug.
Si les paramètres ayant fuité reflètent les exécutions réelles en production, ils confirment que les lois d'échelle du pré-entraînement n'ont pas atteint un plafond mathématique permanent. Au contraire, le mur semble avoir été une barrière d'infrastructure et d'optimisation. Démontrer une convergence stable sur des milliers de milliards de jetons à l'échelle de 10 000 milliards de paramètres indique que les percées algorithmiques dans la stabilisation des pertes et les topologies de données synthétiques organisées ont réussi à combler le fossé entre les courbes de mise à l'échelle théoriques et la réalité physique.
La structure de calcul : interconnexions de silicium et survie des clusters
Le déploiement d'une exécution de pré-entraînement capable d'absorber 10 000 milliards de paramètres nécessite des dizaines de milliers d'accélérateurs de pointe fonctionnant en parfaite synchronisation pendant des mois. À cette échelle, les modes de défaillance dominants ne sont plus algorithmiques ; ils sont mécaniques, électriques et thermiques. Le temps moyen entre deux pannes (MTBF) pour les composants individuels d'un cluster de 80 000 accélérateurs se mesure en heures, pas en semaines. Une exécution d'entraînement viable à cette échelle dépend du contrôle automatisé des points de vérification (checkpointing), d'une récupération rapide après défaillance et de structures de commutation optique non bloquantes qui empêchent les pannes matérielles isolées de corrompre l'ensemble du pipeline d'agrégation de gradients.
Les rumeurs liant le modèle Doug, plus large et prévu pour la fin de l'année, aux architectures de silicium de nouvelle génération, telles que la future plateforme Vera Rubin de NVIDIA, soulignent les changements de paradigmes matériels nécessaires pour soutenir ces charges de travail. Les clusters de génération actuelle Hopper (H100/H200) et Blackwell (B200) font face à de graves goulots d'étranglement de bande passante lors de la mise à l'échelle du parallélisme tensoriel entre des racks non adjacents. Les modèles ultra-denses nécessitent un parallélisme de modèle multidimensionnel — combinant le partitionnement tensoriel de type Megatron, le parallélisme de pipeline et les configurations Fully Sharded Data Parallel (FSDP) — ce qui exerce une immense pression sur la bande passante de bissection.
Des rapports parallèles concernant le développement par OpenAI d'un ASIC d'inférence propriétaire, familièrement désigné en interne par des noms comme Jalapeño, indiquent que l'entreprise est parfaitement consciente du piège économique de l'inférence. S'appuyer entièrement sur des GPU à usage général pour servir une architecture de 10 000 milliards de paramètres à l'échelle mondiale imposerait une charge énergétique et une pression sur les marges intenables. Un silicium d'inférence dédié, optimisé spécifiquement pour les opérations tensorielles de basse précision, une bande passante mémoire extrême et un routage épars statique, représente la seule voie économiquement viable pour commercialiser des modèles de cette envergure sans consommer les réseaux énergétiques de régions entières.
L'économie d'entreprise peut-elle justifier une inférence à 10 000 milliards de paramètres ?
La question centrale à laquelle sont confrontés les ingénieurs mécaniques, les exploitants de centres de données et les dirigeants technologiques est de savoir si les gains d'intelligence marginaux d'un système à 10 000 milliards de paramètres justifient ses coûts de fonctionnement thermodynamiques et financiers stupéfiants. Dans un déploiement industriel ou d'entreprise, chaque appel d'API entraîne un coût opérationnel directement lié aux kilowattheures consommés, aux frais de refroidissement des racks et à la dépréciation du silicium. Si un système de 10 000 milliards de paramètres nécessite plusieurs mégawatts d'énergie continue dédiée rien que pour maintenir les poids actifs en mémoire, le prix par jeton généré devra augmenter considérablement.
Les entreprises ont déjà manifesté une sensibilité croissante aux coûts, optant fréquemment pour des modèles distillés, quantifiés ou spécifiques à un domaine, allant de 8 à 70 milliards de paramètres, qui s'exécutent efficacement sur des serveurs locaux en périphérie (edge) ou des instances cloud rentables. Un modèle de pointe monolithique ou ultra-large ne peut pas se contenter d'apporter des améliorations marginales dans la fluidité conversationnelle pour justifier son existence. Il doit démontrer une compétence incontestable et critique dans le raisonnement complexe en "zero-shot", la synthèse logicielle autonome en plusieurs étapes, la simulation mécanique avancée ou l'analyse scientifique de haute dimension, là où les coûts de l'échec dépassent largement les prix élevés des API.
En outre, la disponibilité de l'énergie pour les centres de données est devenue la principale contrainte géopolitique de l'infrastructure technologique. Les réseaux électriques des grandes métropoles font face à des retards de plusieurs années dans l'approbation des interconnexions pour les installations consommant plus de 100 mégawatts. Exploiter des modèles à l'échelle d'Astra et de Doug oblige les laboratoires de pointe à négocier des contrats d'achat d'électricité parallèlement à des corridors de transmission à l'échelle industrielle, liant fondamentalement les capacités logicielles aux contraintes physiques de l'ingénierie énergétique lourde et de l'infrastructure de refroidissement liquide.
La frontière se resserre et la course s'accélère
Le rythme intense des développements simultanés — y compris les fuites sur les contre-stratégies d'Anthropic impliquant des versions itératives de ses architectures Fable et Mythos, ainsi que les transitions soudaines de leadership au sein des laboratoires de recherche historiques concurrents — souligne une consolidation agressive à la frontière de l'intelligence artificielle. La barrière financière et infrastructurelle à l'entrée pour l'entraînement des modèles de fondation de pointe s'élève désormais à plusieurs milliards de dollars par cluster d'entraînement individuel, ce qui restreint de fait la course principale à une poignée d'entités exceptionnellement bien capitalisées.
Qu'Astra fasse son apparition dans les canaux publics des entreprises dans les prochaines semaines ou qu'il reste restreint derrière des protocoles contrôlés de "red-teaming" en cybersécurité, la trajectoire technique est indéniable. L'ère où l'on comptait uniquement sur les astuces d'inférence post-entraînement pour imiter les gains d'intelligence structurelle semble laisser place à un retour agressif à l'échelle. Si OpenAI a réussi à stabiliser un moteur de 10 000 milliards de paramètres, le paysage de l'IA industrielle sera une fois de plus contraint de recalibrer ses attentes quant à ce que la densité de calcul, l'ingénierie des centres de données et l'infrastructure matérielle peuvent physiquement offrir.



Comments
No comments yet. Be the first!