Un'improvvisa ondata di resoconti del settore e di indiscrezioni sulla catena di approvvigionamento ha scosso il comparto dell'intelligenza artificiale, suggerendo che OpenAI stia preparando il lancio di un modello di frontiera da 10 trilioni di parametri nome in codice Astra, informalmente identificato come GPT-6. Secondo le informazioni circolate attraverso feed tecnici specializzati e piattaforme finanziarie, il modello rappresenta un'aggressiva espansione di cinque volte rispetto ai circa 1,8 trilioni di parametri di GPT-4. Rapporti concomitanti indicano l'esistenza di un secondo sistema ancora più grande, nome in codice Doug, previsto per il lancio entro la fine dell'anno e concepito come una controffensiva ingegneristica contro le imminenti architetture di prossima generazione di Anthropic.
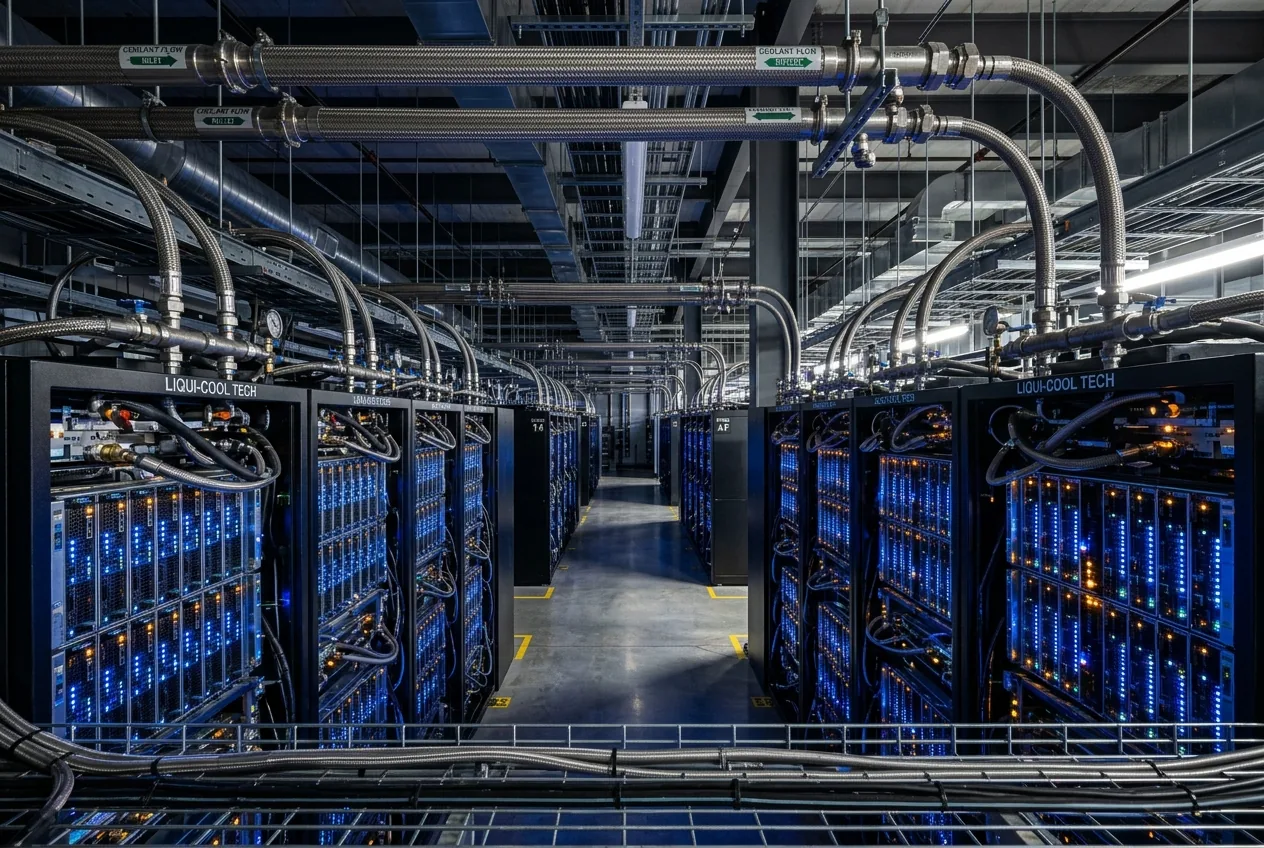
Sebbene i leak speculativi riguardanti modelli fondamentali non ancora rilasciati proliferino regolarmente sui social media, la specificità tecnica degli ultimi resoconti merita un attento scrutinio dal punto di vista dell'ingegneria e dell'infrastruttura. Passare da un'architettura Mixture-of-Experts inferiore ai due trilioni di parametri a una base da dieci trilioni non è un semplice esercizio di scalabilità lineare. Rappresenta un'escalation categorica in termini di topologia di calcolo, domanda di memoria a elevata larghezza di banda, tessuto di rete ottica e dissipazione termica multi-megawatt, che mette a dura prova i limiti fisici dell'hardware attuale dei data center.
Per valutare se un modello da 10 trilioni di parametri possa effettivamente passare da cluster di pre-addestramento sperimentali ad ambienti di inferenza commerciale, è necessario spogliarsi dell'hype speculativo e analizzare la termodinamica sottostante, la larghezza di banda delle interconnessioni e i vincoli del silicio che governano i sistemi di apprendimento automatico contemporanei.
La realtà matematica di un'impronta da dieci trilioni di parametri
Nelle moderne architetture di deep learning, la scala dei parametri determina direttamente il sovraccarico di memoria grezza prima ancora che venga calcolato un singolo token di memoria di attivazione o cache di contesto. Se Astra utilizza una rappresentazione in virgola mobile a 16 bit (bfloat16 o FP16), l'archiviazione di dieci trilioni di pesi richiede circa 20 terabyte di memoria statica esclusivamente per il mantenimento del modello. Anche con un'aggressiva quantizzazione a 8 bit (FP8), divenuta lo standard per il pre-addestramento aziendale moderno e l'inferenza ad alte prestazioni, il carico utile dei pesi statici grezzi richiede un minimo di 10 terabyte di memoria ultra-rapida distribuita su un cluster unificato.
Questa impronta statica si espande esponenzialmente se si considera la memoria dinamica necessaria per finestre di contesto estese. I rapporti suggeriscono lunghezze di contesto fino a 1,5 milioni di token, una capacità che introduce colossali colli di bottiglia nell'archiviazione della cache Key-Value (KV). Nei meccanismi standard di multi-head attention, la cache KV scala linearmente sia con la lunghezza della sequenza che con la dimensione del batch, richiedendo terabyte di capacità aggiuntiva in tutto il cluster. Senza sofisticati interventi architettonici — come la Grouped-Query Attention (GQA), lo sharding dell'attenzione multi-latente o una severa compressione del contesto — l'impronta hardware necessaria per servire anche una singola sessione utente a bassa concorrenza diventa commercialmente proibitiva.
Di conseguenza, qualsiasi architettura da 10 trilioni di parametri che si rispetti fa quasi certamente affidamento sul routing sparso piuttosto che sul calcolo denso. Se Astra fosse implementato come un sistema Mixture-of-Experts (MoE) ultra-ampio, solo una frazione dei suoi parametri totali — forse tra i 500 e gli 800 miliardi — verrebbe attivata per ogni token. Sebbene i modelli MoE scostino la capacità totale dei parametri dai requisiti FLOP per singolo passaggio in avanti (forward pass), non eliminano il requisito di memoria fisica. Ogni singolo parametro deve rimanere residente nella memoria ad alta larghezza di banda (HBM) attraverso migliaia di acceleratori interconnessi per mantenere soglie di latenza accettabili.
OpenAI ha finalmente infranto il muro del pre-addestramento?
Per oltre ventiquattro mesi, lo sviluppo dell'IA di frontiera ha lottato con quello che i ricercatori descrivono come il muro del pre-addestramento. Sebbene modelli come la serie o abbiano dimostrato che il calcolo in fase di test — allocando FLOP di inferenza per la verifica della catena di pensiero (chain-of-thought) e la ricerca ad albero Monte Carlo — possa sbloccare guadagni significativi nella logica matematica e di codifica, i modelli di base pre-addestrati sottostanti sono rimasti in gran parte evoluzioni incrementali delle fondamenta dell'era 2023. I colli di bottiglia algoritmici, l'esaurimento di testo umano di alta qualità e la divergenza catastrofica della perdita (loss) su scale estreme hanno costretto i laboratori a fare affidamento sul perfezionamento post-addestramento piuttosto che su salti di pre-addestramento basati sulla forza bruta.
Superare questo plateau richiede molto più che aggiungere semplicemente ulteriori nodi acceleratori a un trasformatore standard. Esecuzioni di addestramento stabili di questa portata richiedono pipeline complete di generazione di dati sintetici, filtraggio automatizzato dei curriculum e nuovi regimi di stabilità dell'ottimizzatore per prevenire esplosioni del gradiente. Le voci del settore che indicano prototipi esplorativi interni chiamati Garlic suggeriscono che gli ingegneri di OpenAI abbiano trascorso mesi a risolvere critiche instabilità di addestramento prima di scalare l'architettura alla dimensione del cluster richiesta per Astra e Doug.
Se i parametri trapelati riflettono le effettive esecuzioni di produzione, confermano che le leggi di scala del pre-addestramento non hanno raggiunto un tetto matematico permanente. Al contrario, il muro sembra essere stato una barriera di infrastruttura e ottimizzazione. Dimostrare una convergenza stabile su trilioni di token alla scala dei dieci trilioni di parametri segnala che le scoperte algoritmiche nella stabilizzazione della perdita e nelle topologie di dati sintetici curati hanno colmato con successo il divario tra le curve di scala teoriche e la realtà fisica.
Il tessuto di calcolo: interconnessioni in silicio e sopravvivenza del cluster
L'implementazione di un'esecuzione di pre-addestramento capace di assorbire 10 trilioni di parametri richiede decine di migliaia di acceleratori all'avanguardia che operano in perfetta sincronia per mesi. A questa magnitudo, le modalità di guasto dominanti non sono più algoritmiche, ma meccaniche, elettriche e termiche. Il tempo medio tra i guasti (MTBF) per i singoli componenti in un cluster da 80.000 acceleratori si misura in ore, non in settimane. Un'esecuzione di addestramento praticabile su questa scala dipende dal checkpointing distribuito automatizzato, dal rapido ripristino dei guasti e da tessuti di commutazione ottica non bloccanti che impediscono a cadute isolate dell'hardware di corrompere l'intera pipeline di aggregazione del gradiente.
Le voci che collegano il modello Doug, più grande e previsto per la fine dell'anno, ad architetture in silicio di prossima generazione, come la piattaforma Vera Rubin di NVIDIA, evidenziano il cambiamento di paradigma hardware necessario per sostenere questi carichi di lavoro. I cluster Hopper (H100/H200) e Blackwell (B200) di attuale generazione affrontano gravi colli di bottiglia nella larghezza di banda quando si scala il parallelismo tensoriale attraverso rack non adiacenti. I modelli ultra-densi richiedono un parallelismo di modello multidimensionale — combinando sharding tensoriale in stile Megatron, parallelismo di pipeline e configurazioni Fully Sharded Data Parallel (FSDP) — che esercita un'immensa pressione sulla larghezza di banda di bisezione.
Rapporti paralleli riguardanti lo sviluppo da parte di OpenAI di un ASIC proprietario per l'inferenza, colloquialmente riferito sotto designazioni di progetto interne come Jalapeño, indicano che l'azienda è pienamente consapevole della trappola economica dell'inferenza. Affidarsi interamente a GPU per uso generico per servire un'architettura da 10 trilioni di parametri su scala globale imporrebbe un onere in termini di energia e margini insostenibile. Un silicio dedicato all'inferenza, ottimizzato specificamente per operazioni tensoriali a bassa precisione, un'estrema larghezza di banda di memoria e un routing sparso statico rappresenta l'unico percorso economicamente sostenibile verso la commercializzazione di modelli di questa portata senza consumare intere reti energetiche regionali.
L'economia aziendale può giustificare l'inferenza da dieci trilioni di parametri?
La questione centrale che devono affrontare ingegneri meccanici, operatori di data center ed executive tecnologici è se i guadagni marginali di intelligenza di un sistema da 10 trilioni di parametri giustifichino i suoi sbalorditivi costi termodinamici e operativi finanziari. In un'implementazione industriale o aziendale, ogni chiamata API comporta un costo operativo direttamente legato ai chilowattora consumati, al sovraccarico di raffreddamento dei rack e all'ammortamento del silicio. Se un sistema da 10 trilioni di parametri richiede diversi megawatt di potenza continua dedicata solo per mantenere i pesi attivi in memoria, il prezzo per token generato deve aumentare sostanzialmente.
Le aziende hanno già dimostrato una crescente sensibilità ai costi, optando frequentemente per modelli distillati, quantizzati o specifici per dominio da 8 a 70 miliardi di parametri che funzionano in modo efficiente su server edge locali o istanze cloud convenienti. Un modello di frontiera monolitico o ultra-ampio non può semplicemente offrire miglioramenti marginali nella fluidità conversazionale per giustificare la propria esistenza. Deve dimostrare una competenza inequivocabile e mission-critical nel ragionamento complesso zero-shot, nella sintesi autonoma di software multi-step, nella simulazione meccanica avanzata o nell'analisi scientifica ad alta dimensionalità, dove i costi di un fallimento superano di gran lunga i prezzi elevati delle API.
Inoltre, la disponibilità di energia nei data center è emersa come il principale vincolo geopolitico nell'infrastruttura tecnologica. Le principali reti di servizi pubblici metropolitani stanno affrontando ritardi pluriennali nelle approvazioni di interconnessione per strutture che assorbono oltre 100 megawatt. Operare modelli su scala di Astra e Doug costringe i laboratori di frontiera a negoziare accordi di acquisto di energia accanto a corridoi di trasmissione su scala di rete, collegando fondamentalmente le capacità del software ai vincoli fisici dell'ingegneria elettrica pesante e dell'infrastruttura di raffreddamento a liquido.
La frontiera che si restringe e la corsa che accelera
L'intenso ritmo degli sviluppi concomitanti — incluse le contro-strategie trapelate da Anthropic che prevedono rilasci iterativi delle sue architetture Fable e Mythos, insieme alle improvvise transizioni di leadership all'interno di laboratori di ricerca storici concorrenti — sottolinea un'aggressiva consolidamento alla frontiera dell'intelligenza artificiale. La barriera finanziaria e infrastrutturale all'ingresso per l'addestramento di modelli fondamentali di frontiera è ormai salita a miliardi di dollari per singolo cluster di addestramento, restringendo di fatto la corsa primaria a una manciata di entità eccezionalmente ben capitalizzate.
Che Astra appaia nei canali aziendali pubblici nel giro di settimane o rimanga limitato dietro protocolli controllati di red-teaming per la sicurezza informatica, la traiettoria tecnica è inequivocabile. L'era dell'affidarsi esclusivamente a trucchi di inferenza post-addestramento per imitare i guadagni di intelligenza strutturale sembra transitare verso un aggressivo ritorno alla scala. Se OpenAI è riuscita a stabilizzare un motore da 10 trilioni di parametri, il panorama dell'IA industriale sarà nuovamente costretto a ricalibrare le sue aspettative su ciò che la densità di calcolo, l'ingegneria dei data center e l'infrastruttura hardware possono fisicamente offrire.



Comments
No comments yet. Be the first!