近期行业报道与供应链泄密引发了一阵波澜,称 OpenAI 正准备部署代号为 Astra、被非正式定位为 GPT-6 的 10 万亿参数前沿模型。据来自专业技术追踪源和金融平台的消息显示,该模型参数规模达到了 GPT-4 预估的 1.8 万亿参数的五倍之多。随后的报告还指出,还有一个代号为 Doug 的更大规模二级系统计划于今年晚些时候部署,旨在作为针对 Anthropic 即将推出的下一代架构的工程反击。
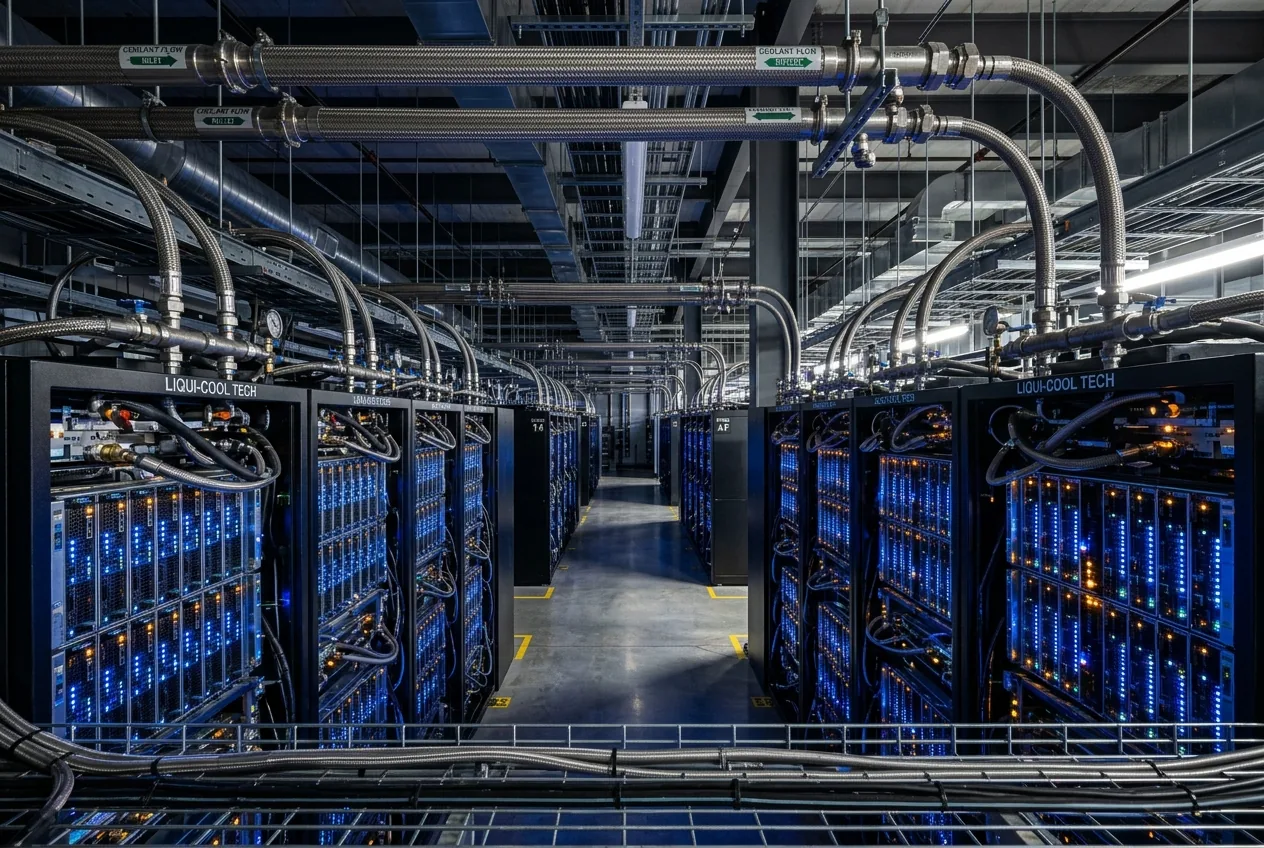
尽管关于未发布基础模型的猜测性泄密在社交媒体上屡见不鲜,但最新报告中提及的技术细节,从工程和基础设施的角度来看,值得严谨审视。从不足 2 万亿参数的混合专家(Mixture-of-Experts)架构过渡到 10 万亿参数基准,绝非简单的线性扩展。这代表了计算拓扑、高带宽内存需求、光网络结构以及多兆瓦级散热等方面的重大升级,这些都已逼近当前数据中心硬件的物理极限。
要评估 10 万亿参数模型能否从实验性预训练集群平稳过渡到商业推理环境,就必须剥离炒作,分析决定当代机器学习系统的底层热力学、互联带宽和硅片约束。
10 万亿参数规模的数学现实
在现代深度学习架构中,参数规模直接决定了原始内存开销,这还不包括激活内存或上下文缓存的计算。如果 Astra 使用 16 位浮点表示(bfloat16 或 FP16),仅保留模型权重就需要约 20 TB 的静态内存。即使在已成为现代企业预训练和高性能推理标准的 8 位量化(FP8)下,原始静态权重负载也至少需要 10 TB 超高速内存分布在统一集群中。
当考虑到长上下文窗口所需的动态内存时,这一静态占用空间会呈指数级增长。流传的报告显示,上下文长度有望扩展至 150 万个 token,这一能力带来了巨大的键值(KV)缓存存储瓶颈。在标准的多头注意力机制中,KV 缓存随序列长度和批处理大小线性扩展,需要集群提供数 TB 的额外容量。如果没有复杂的架构干预——例如分组查询注意力(GQA)、多隐层注意力分片或深度上下文压缩——那么即便只为一个低并发用户会话提供服务,其硬件开销在商业上也难以承受。
因此,任何可行的 10 万亿参数架构几乎肯定会高度依赖稀疏路由而非密集计算。如果 Astra 被实现为超宽的混合专家(MoE)系统,每个 token 可能仅激活其总参数的一小部分——或许是 5000 亿到 8000 亿。虽然 MoE 模型将总参数容量与前向传递所需的 FLOP(浮点运算次数)要求分离开来,但它们并未减轻物理内存需求。每一个参数都必须驻留在跨数千个联网加速器的高带宽内存(HBM)中,以维持可接受的延迟阈值。
OpenAI 是否终于突破了预训练壁垒?
在过去二十四个月中,前沿 AI 开发一直深受研究人员所描述的“预训练壁垒”困扰。虽然像 o 系列这样的模型证明了测试时计算(test-time compute)——即为思维链验证和蒙特卡洛树搜索分配推理 FLOP——可以解锁数学和编码逻辑的阶梯式提升,但作为基础的预训练模型在很大程度上仍只是 2023 年技术的渐进演变。算法瓶颈、高质量人类文本的枯竭以及极端规模下的损失函数发散,迫使实验室只能依赖训练后优化,而非单纯依靠暴力预训练实现飞跃。
克服这一瓶颈所需的不仅仅是在标准 Transformer 上堆叠更多的加速器节点。如此大规模的稳定训练需要全面的合成数据生成流水线、自动化的课程过滤以及新颖的优化器稳定性方案,以防止梯度爆炸。指向内部代号为 Garlic 的探索性原型的行业传言表明,OpenAI 的工程师在将架构扩展到 Astra 和 Doug 所需的集群规模之前,花费了数月时间解决关键的训练不稳定问题。
如果泄露的参数反映了实际的生产运行情况,则证实预训练缩放定律并未触及永久的数学上限。相反,这堵“墙”似乎是一个基础设施和优化障碍。在 10 万亿参数规模下实现跨万亿 token 的稳定收敛,表明损失稳定性和精选合成数据拓扑方面的算法突破,已成功弥合了理论缩放曲线与物理现实之间的鸿沟。
计算架构:硅片互联与集群生存能力
执行一个能够容纳 10 万亿参数的预训练任务,需要数万个最先进的加速器在数月内保持同步运行。在此规模下,主要的失效模式不再是算法问题,而是机械、电气和热学问题。在拥有 8 万个加速器的集群中,单个组件的平均故障间隔时间(MTBF)是以小时而非周来计算的。如此规模的训练能否成功,取决于自动化分布式检查点、快速故障恢复以及非阻塞光交换架构,以防止个别硬件掉线导致整个梯度聚合流水线崩溃。
将更大规模的年度后期模型 Doug 与 NVIDIA 即将推出的 Vera Rubin 平台等下一代硅片架构联系起来的传言,突显了维持这些工作负载所需的硬件范式转移。当前的 Hopper(H100/H200)和 Blackwell(B200)集群在跨非相邻机架扩展张量并行性时,面临严重的带宽瓶颈。超密集模型需要多维模型并行性——结合 Megatron 风格的张量分片、流水线并行性和全分片数据并行(FSDP)配置——这对对分带宽造成了巨大压力。
关于 OpenAI 开发专有内部推理 ASIC(内部项目代号通常称为 Jalapeño)的平行报告表明,该公司非常清楚推理经济学的陷阱。完全依赖通用 GPU 在全球范围内为 10 万亿参数架构提供服务,将带来无法承受的电力和利润压力。专为低精度张量运算、极端内存带宽和静态稀疏路由而优化的专用推理硅片,是实现此类大规模模型商业化且不消耗整个区域电网的唯一经济可行途径。
企业经济效益能否支撑 10 万亿参数推理?
机械工程师、数据中心运营商和技术高管面临的核心问题是,10 万亿参数系统带来的边际智能提升,是否足以抵消其惊人的热力学和财务运营成本。在工业或企业部署中,每一次 API 调用都带有与千瓦时功耗、机架冷却成本和硅片折旧直接相关的运营成本。如果一个 10 万亿参数的系统仅为了在内存中保持活跃权重就需要数兆瓦的持续电力,那么生成的每个 token 的价格必须大幅上涨。
企业已经表现出越来越强的成本敏感度,经常选择经过蒸馏、量化或特定领域的 80 亿到 700 亿参数模型,这些模型在本地边缘服务器或高性价比云实例上运行效率更高。单体或超宽前沿模型若要证明其存在价值,不能仅仅提供边际上的对话流畅度提升。它必须在零样本复杂推理、自主多步软件合成、高级机械仿真或高维科学分析方面表现出明确的、关键任务级的专业能力,且这些应用场景下的故障成本远高于昂贵的 API 定价。
此外,数据中心电力可用性已成为科技基础设施的主要地缘政治制约因素。主要大都市的公用事业电网在审批用电量超过 100 兆瓦的设施互联时,面临数年的延误。在 Astra 和 Doug 的规模下运营模型,迫使前沿实验室在公用事业级输电走廊旁谈判购电协议,从根本上将软件能力与重型电力工程和液冷基础设施的物理限制挂钩。
缩窄的前沿与加速的竞赛
持续发展的激烈节奏——包括 Anthropic 泄露的涉及迭代发布其 Fable 和 Mythos 架构的反制策略,以及竞争性传统研究实验室内部突然的领导层变动——突显了人工智能前沿领域的激进整合。训练前沿基础模型的财务和基础设施准入门槛现已上升到单个训练集群数十亿美元的规模,有效地将主要竞争限制在极少数资本极其雄厚的实体之间。
无论 Astra 是在几周内通过公共企业渠道发布,还是被限制在受控的网络安全红队协议之后,技术轨迹都是毋庸置疑的。仅依靠训练后推理技巧来模仿结构性智能增长的时代,似乎正在向激进的规模扩张回归。如果 OpenAI 已经成功稳定了一个 10 万亿参数的引擎,工业 AI 环境将再次被迫重新校准其对计算密度、数据中心工程和硬件基础设施物理交付能力的预期。



Comments
No comments yet. Be the first!