Una oleada repentina de informes de la industria y filtraciones de la cadena de suministro ha sacudido al sector de la inteligencia artificial, alegando que OpenAI se prepara para desplegar un modelo de frontera de 10 billones de parámetros con nombre en clave Astra, posicionado informalmente como GPT-6. Según las revelaciones que circulan a través de feeds de seguimiento técnico especializado y plataformas financieras, el modelo representa una expansión agresiva cinco veces mayor que los aproximadamente 1,8 billones de parámetros de GPT-4. Informes adjuntos apuntan a un sistema secundario aún mayor con nombre en clave Doug, programado para un despliegue a finales de año, planteado como una contraofensiva de ingeniería frente a las próximas arquitecturas de nueva generación de Anthropic.
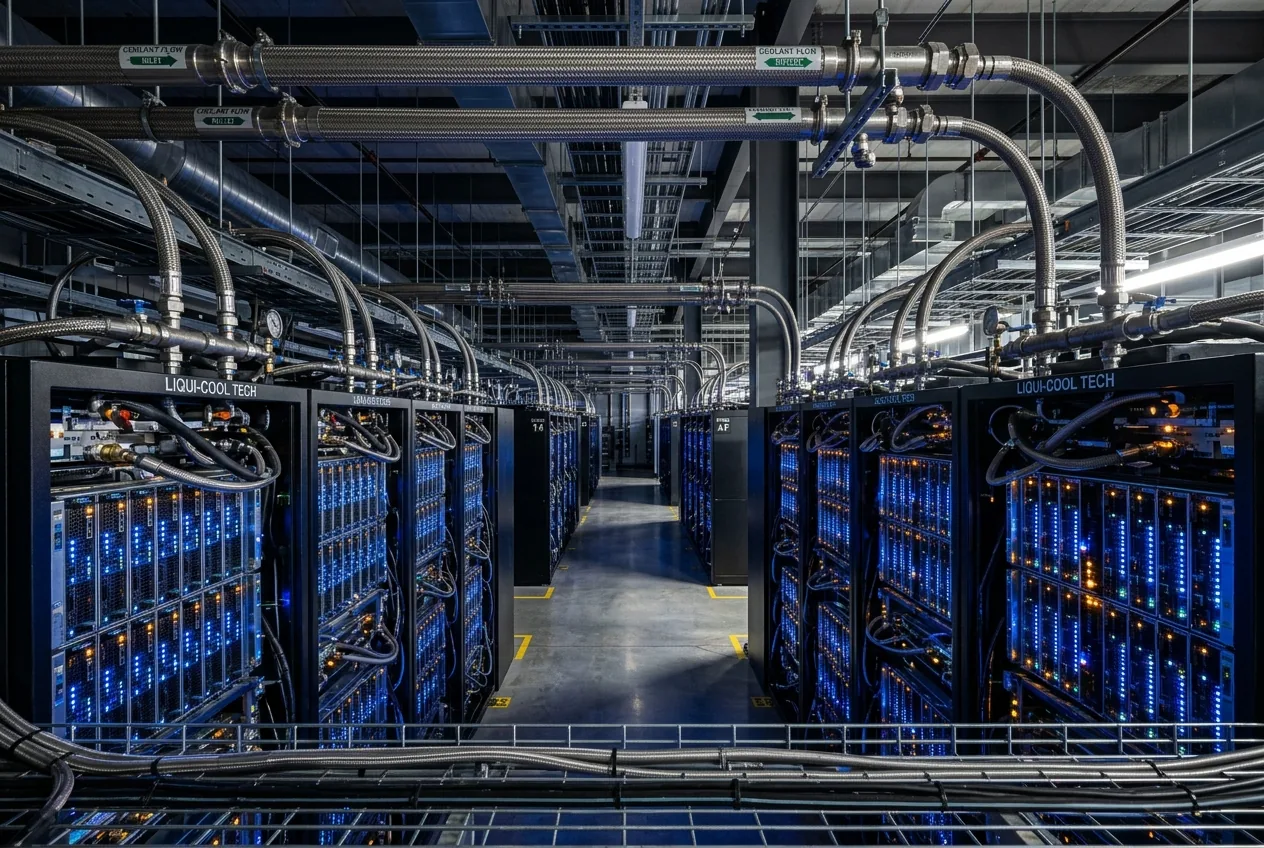
Si bien las filtraciones especulativas en torno a modelos fundacionales no lanzados proliferan rutinariamente en las redes sociales, la especificidad técnica de los informes más recientes justifica un examen riguroso desde el punto de vista de la ingeniería y la infraestructura. Pasar de una arquitectura de Mezcla de Expertos (Mixture-of-Experts) de menos de dos billones de parámetros a una base de diez billones no es un ejercicio de escalado lineal trivial. Representa una escalada categórica en topología de computación, demanda de memoria de gran ancho de banda, tejido de redes ópticas y disipación térmica de varios megavatios que tensa los límites físicos del hardware actual de los centros de datos.
Para evaluar si un modelo de 10 billones de parámetros puede pasar de forma viable de clústeres experimentales de preentrenamiento a entornos de inferencia comercial, es necesario despojarse de la especulación publicitaria y analizar la termodinámica subyacente, el ancho de banda de interconexión y las limitaciones de silicio que rigen los sistemas de aprendizaje automático contemporáneos.
La realidad matemática de una huella de diez billones de parámetros
En las arquitecturas modernas de aprendizaje profundo, la escala de los parámetros dicta directamente la sobrecarga de memoria bruta antes de que se calcule un solo token de memoria de activación o caché de contexto. Si Astra utiliza una representación de punto flotante de 16 bits (bfloat16 o FP16), almacenar diez billones de pesos requiere aproximadamente 20 terabytes de memoria estática puramente para la retención del modelo. Incluso bajo una cuantización agresiva de 8 bits (FP8), que se ha convertido en el estándar para el preentrenamiento empresarial moderno y la inferencia de alto rendimiento, la carga útil de pesos estáticos brutos exige un mínimo de 10 terabytes de memoria ultrarrápida distribuida a través de un clúster unificado.
Esta huella estática se expande exponencialmente al tener en cuenta la memoria dinámica requerida para ventanas de contexto extendidas. Los informes que circulan sugieren longitudes de contexto que se expanden hasta 1,5 millones de tokens, una capacidad que introduce cuellos de botella masivos en el almacenamiento de caché de Clave-Valor (KV). En los mecanismos estándar de atención de múltiples cabezales, la caché KV escala linealmente tanto con la longitud de la secuencia como con el tamaño del lote, exigiendo terabytes de capacidad adicional en todo el clúster. Sin intervenciones arquitectónicas sofisticadas —como la Atención de Consulta Agrupada (GQA), el fragmentado de atención multilatente o una compresión de contexto severa—, la huella de hardware necesaria para atender incluso una sola sesión de usuario de baja concurrencia se vuelve comercialmente prohibitiva.
En consecuencia, cualquier arquitectura viable de 10 billones de parámetros depende casi con toda seguridad en gran medida del enrutamiento disperso (sparse routing) en lugar de la computación densa. Si Astra se implementa como un sistema de Mezcla de Expertos (MoE) ultra amplio, solo una fracción de sus parámetros totales —quizás entre 500.000 y 800.000 millones— se activaría por token. Aunque los modelos MoE desacoplan la capacidad total de parámetros de los requisitos de FLOPs por pase hacia adelante, no alivian el requisito de memoria física. Cada parámetro debe permanecer residente en la Memoria de Gran Ancho de Banda (HBM) a través de miles de aceleradores en red para mantener umbrales de latencia aceptables.
¿Ha superado finalmente OpenAI el muro del preentrenamiento?
Durante más de veinticuatro meses, el desarrollo de la IA de frontera ha lidiado con lo que los investigadores describen como el muro del preentrenamiento. Aunque modelos como la serie o demostraron que la computación en tiempo de prueba —asignando FLOPs de inferencia a la verificación de cadena de pensamiento y búsqueda en árbol de Monte Carlo— podía desbloquear ganancias de salto en la lógica matemática y de codificación, los modelos base preentrenados fundamentales subyacentes siguieron siendo en gran medida evoluciones incrementales de las bases de la era de 2023. Los cuellos de botella algorítmicos, el agotamiento del texto humano de alta calidad y la divergencia de pérdida catastrófica en escalas extremas obligaron a los laboratorios a depender del refinamiento posterior al entrenamiento en lugar de saltos de preentrenamiento por fuerza bruta.
Superar este estancamiento requiere algo más que simplemente añadir nodos de aceleración adicionales a un transformador estándar. Las ejecuciones de entrenamiento estables de esta magnitud exigen tuberías de generación de datos sintéticos integrales, filtrado de planes de estudio automatizado y nuevos regímenes de estabilidad de optimizadores para evitar explosiones de gradiente. Los comentarios de la industria que apuntan a prototipos exploratorios internos con nombre en clave Garlic sugieren que los ingenieros de OpenAI pasaron meses resolviendo inestabilidades críticas de entrenamiento antes de escalar la arquitectura al tamaño de clúster requerido para Astra y Doug.
Si los parámetros filtrados reflejan ejecuciones de producción reales, confirman que las leyes de escala de preentrenamiento no han alcanzado un techo matemático permanente. En cambio, el muro parece haber sido una barrera de infraestructura y optimización. Demostrar una convergencia estable a través de billones de tokens a la escala de diez billones de parámetros indica que los avances algorítmicos en la estabilización de pérdidas y las topologías de datos sintéticos curados han salvado con éxito la brecha entre las curvas teóricas de escala y la realidad física.
El tejido de computación: interconexiones de silicio y supervivencia del clúster
Desplegar una ejecución de preentrenamiento capaz de absorber 10 billones de parámetros requiere decenas de miles de aceleradores de última generación operando en sincronía durante meses. A esta magnitud, los modos de fallo dominantes ya no son algorítmicos; son mecánicos, eléctricos y térmicos. El Tiempo Medio Entre Fallos (MTBF) de los componentes individuales en un clúster de 80.000 aceleradores se mide en horas, no en semanas. Una ejecución de entrenamiento viable a esta escala depende de puntos de control distribuidos automatizados, una rápida recuperación de fallos y tejidos de conmutación óptica sin bloqueo que eviten que las caídas de hardware aisladas corrompan toda la tubería de agregación de gradientes.
Los rumores que vinculan el modelo Doug, más grande y previsto para finales de año, con arquitecturas de silicio de próxima generación, como la plataforma Vera Rubin de NVIDIA, destacan los paradigmas de hardware cambiantes necesarios para sostener estas cargas de trabajo. Los clústeres de la generación actual Hopper (H100/H200) y Blackwell (B200) enfrentan severos cuellos de botella de ancho de banda al escalar el paralelismo de tensores a través de racks no adyacentes. Los modelos ultradensos requieren un paralelismo de modelo multidimensional —combinando el fragmentado de tensores al estilo Megatron, el paralelismo de tuberías y las configuraciones de Datos Totalmente Fragmentados en Paralelo (FSDP)—, lo que ejerce una inmensa presión sobre el ancho de banda de bisección.
Los informes paralelos sobre el desarrollo por parte de OpenAI de un ASIC de inferencia interno propietario, referido coloquialmente bajo designaciones de proyectos internos como Jalapeño, indican que la empresa es muy consciente de la trampa económica de la inferencia. Confiar totalmente en las GPU de propósito general para servir una arquitectura de 10 billones de parámetros a escala global impondría una carga de energía y margen insostenible. El silicio de inferencia dedicado, optimizado específicamente para operaciones de tensores de baja precisión, ancho de banda de memoria extremo y enrutamiento disperso estático, representa el único camino económicamente viable hacia la comercialización de modelos de esta escala sin consumir redes energéticas regionales enteras.
¿Puede la economía empresarial justificar la inferencia de diez billones de parámetros?
La pregunta central que enfrentan los ingenieros mecánicos, los operadores de centros de datos y los ejecutivos de tecnología es si las ganancias marginales de inteligencia de un sistema de 10 billones de parámetros justifican sus asombrosos costos operativos termodinámicos y financieros. En un despliegue industrial o empresarial, cada llamada a la API conlleva un costo operativo directamente relacionado con los kilovatios-hora consumidos, la sobrecarga de refrigeración del rack y la depreciación del silicio. Si un sistema de 10 billones de parámetros requiere múltiples megavatios de energía continua dedicada solo para mantener los pesos activos en la memoria, el precio por token generado debe aumentar sustancialmente.
Las empresas ya han demostrado una creciente sensibilidad a los costos, optando frecuentemente por modelos destilados, cuantizados o específicos de dominio de 8.000 a 70.000 millones de parámetros que se ejecutan de manera eficiente en servidores locales o instancias en la nube rentables. Un modelo de frontera monolítico o ultra amplio no puede simplemente ofrecer mejoras marginales en la fluidez conversacional para justificar su existencia. Debe demostrar una competencia inequívoca y crítica para la misión en razonamiento complejo de disparo cero (zero-shot), síntesis de software autónoma de múltiples pasos, simulación mecánica avanzada o análisis científico de alta dimensión donde los costos de fallo superan con creces los altos precios de las API.
Además, la disponibilidad de energía en los centros de datos ha surgido como la principal limitación geopolítica en la infraestructura tecnológica. Las redes eléctricas de las principales áreas metropolitanas enfrentan retrasos de varios años en las aprobaciones de interconexión para instalaciones que consumen más de 100 megavatios. Operar modelos a la escala de Astra y Doug obliga a los laboratorios de frontera a negociar acuerdos de compra de energía junto con corredores de transmisión a escala de servicios públicos, vinculando fundamentalmente las capacidades de software con las restricciones físicas de la ingeniería de potencia pesada y la infraestructura de refrigeración líquida.
La frontera que se estrecha y la carrera acelerada
El ritmo intenso de los desarrollos concurrentes —incluidas las contraestrategias filtradas de Anthropic que implican lanzamientos iterativos de sus arquitecturas Fable y Mythos, junto con transiciones de liderazgo repentinas dentro de laboratorios de investigación heredados de la competencia— subraya una consolidación agresiva en la frontera de la inteligencia artificial. La barrera financiera e infraestructural de entrada para entrenar modelos fundacionales de frontera ha ascendido ahora a miles de millones de dólares por cada clúster de entrenamiento individual, estrechando efectivamente la carrera principal a un puñado de entidades excepcionalmente bien capitalizadas.
Ya sea que Astra aparezca en canales empresariales públicos en cuestión de semanas o permanezca restringido detrás de protocolos controlados de red-teaming de ciberseguridad, la trayectoria técnica es inconfundible. La era de confiar únicamente en trucos de inferencia post-entrenamiento para imitar las ganancias de inteligencia estructural parece estar dando paso a un regreso agresivo a la escala. Si OpenAI ha estabilizado con éxito un motor de 10 billones de parámetros, el panorama de la IA industrial se verá obligado una vez más a recalibrar sus expectativas sobre lo que la densidad de computación, la ingeniería de centros de datos y la infraestructura de hardware pueden ofrecer físicamente.



Comments
No comments yet. Be the first!