Die wahre Geschichte hinter der Bilanz von OpenAI ist nicht die eines Unternehmens, das das Bruttoinlandsprodukt eines kleinen Staates für banale Gemeinkosten verbrennt, sondern die einer grundlegenden Kollision zwischen traditioneller Softwareökonomie und physischer Infrastruktur. Während schlagzeilenträchtige Zahlen häufig nicht zahlungswirksame aktienbasierte Vergütungen, Neubewertungen von Vorzugsaktien und aus dem Kontext gerissene Yuan-Beträge vermischen, ist die tatsächliche operative Burn-Rate, die erforderlich ist, um Modellparameter in den Bereich der nächsten Generation zu heben, für sich genommen bereits atemberaubend. Für Maschinenbauingenieure und Industrieanalysten, die Hardware-Lebenszyklen verfolgen, wirkt die Bilanz von OpenAI weit weniger wie die eines Softwareunternehmens aus dem Silicon Valley, sondern eher wie die eines Schwerindustrieunternehmens, das ein unbewiesenes nationales Stromnetz aufbaut.
Buchhalterische Realitäten versus rechnergestützte Investitionsausgaben (Capex)
Um zu verstehen, wie Gerüchte über massive Verluste in Höhe einer Viertelbillion Dollar entstehen, muss man zunächst analysieren, wie Technologieunternehmen, die in einer Größenordnung vor dem Börsengang operieren, schnelle Bewertungssteigerungen verbuchen. Als OpenAI seine jüngsten Finanzierungsrunden abschloss und seine Privatbewertung auf rund 157 Milliarden Dollar anhob, erforderten Standard-Rechnungslegungsmethoden buchhalterische Anpassungen, die eine Bilanz auf dem Papier als strukturell insolvent erscheinen lassen können. Vorzugsaktienbewertungen, Wandelanleihen strategischer Partner wie Microsoft und massive aktienbasierte Vergütungspakete für Elite-KI-Forschungspersonal werden gemäß den Standard-Berichtslinien als schwere Verbindlichkeiten oder Verluste verbucht, obwohl kein tatsächliches Bargeld aus den Unternehmenskassen abfließt.
Das tatsächlich abfließende Kapital offenbart jedoch den wahren finanziellen Flaschenhals: die brutalen Kosten für den Betrieb von Millionen täglicher Inferenzabfragen in Verbindung mit mehrmonatigen Trainingsläufen auf zehntausenden synchronisierten Beschleunigern. Branchenberichten zufolge erreichte der jährliche operative Cash-Burn von OpenAI etwa 5 Milliarden Dollar bei einem annualisierten Umsatz von rund 3,7 bis 4 Milliarden Dollar. Obwohl dies weit entfernt von Hunderten Milliarden an liquider Zerstörung ist, stellt der Betrieb mit einem annualisierten Verlust, der höher ist als der Umsatz der meisten Fortune-500-Fertigungsunternehmen, ein gewaltiges strukturelles Problem dar, das sich mit der Rhetorik von Softwaremargen nicht länger kaschieren lässt.
Die zentrale Spannung liegt in der Verschiebung von klassischer Software-Distribution hin zur aktiven Compute-Generierung. Bei herkömmlichen Software-as-a-Service-Paradigmen tendieren die Grenzkosten für die Bedienung eines zusätzlichen Nutzers gegen Null, sobald der Programmcode geschrieben und gehostet ist. Bei Frontier-KI verursacht jedes generierte Token messbare thermische, rechnerische und elektrische Kosten. Es gibt keine Transaktionen mit Grenzkosten von Null in der generativen Intelligenz, was bedeutet, dass die Bruttomargen einem harten mechanischen Limit unterliegen, das durch Hardware-Effizienz, thermische Dynamik in Rechenzentren und Stromgroßhandelstarife vorgegeben wird.
Der wahre Preis von Gleitkommaoperationen
Jeder Durchbruch bei Reasoning-Modellen und multimodaler Verarbeitung führt direkt zu Hardware-Beschaffungsaufträgen, die die globalen Lieferketten belasten. Ein Trainingscluster, das in der Lage ist, Modelle an der technologischen Grenze zu produzieren, erfordert zehntausende modernste Beschleuniger, Stacks mit hoher Speicherbandbreite und komplexe optische Interconnect-Strukturen. Wenn ein Unternehmen einen Infrastruktur-Fußabdruck aus Nvidia Hopper- und den kommenden Blackwell-Architekturen einsetzt, steigen die Investitionsausgaben rasch in den zweistelligen Milliardenbereich.
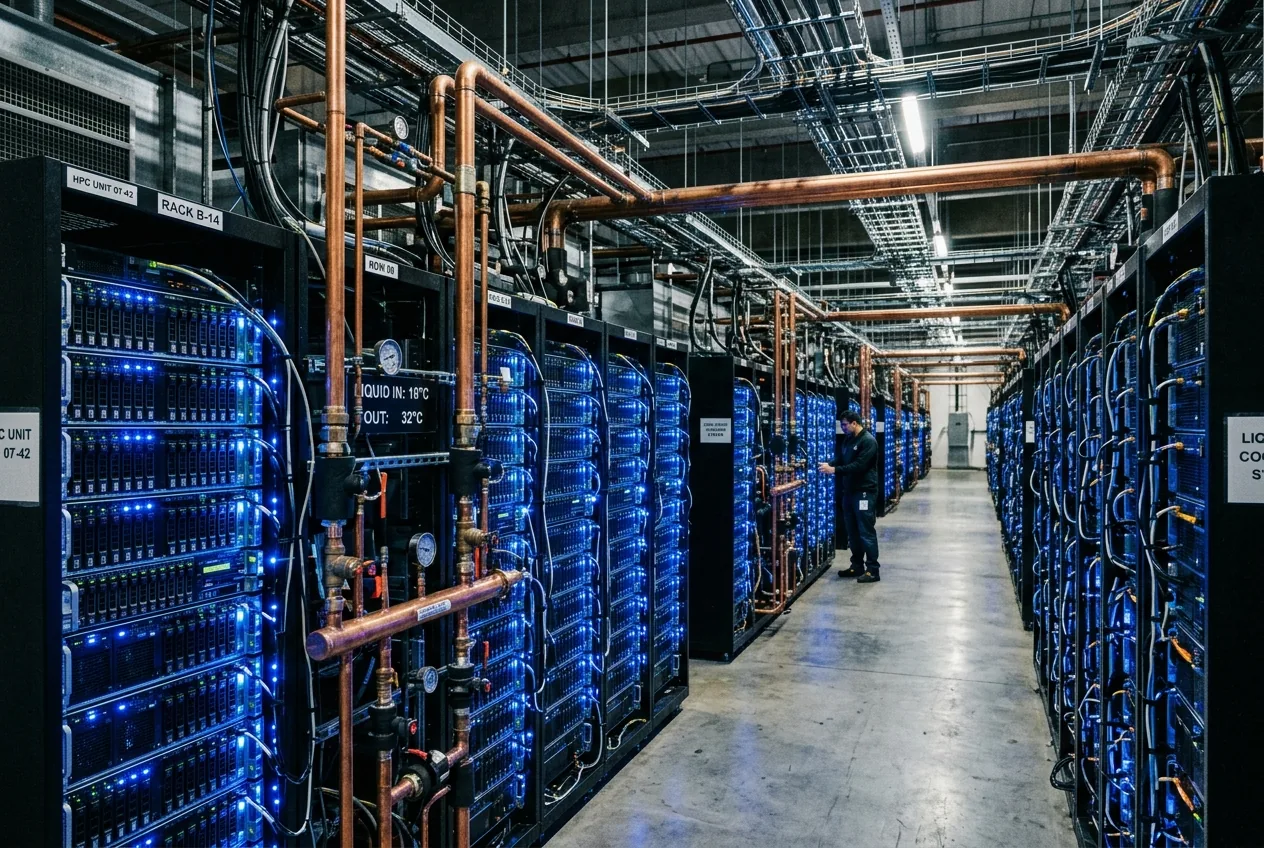
Die Hardware-Stückliste ist nur die erste Hürde. Ein modernes KI-Cluster erfordert einen extrem dichten physischen Platzbedarf, wobei die Leistungsdichte in den Racks häufig 100 Kilowatt pro Schrank übersteigt. Die Abführung dieser thermischen Leistung erfordert hochentwickelte, geschlossene Flüssigkeitskühlsysteme direkt am Chip, industrielle Pumpensysteme und speziell gebaute Kühltürme. Dieser mechanische Aufwand lässt sich nicht einfach über eine automatisierte Cloud-Konsole hochfahren; er erfordert baurechtliche Genehmigungen, Zuweisungen für Umspannwerke und elektrische Transformatoren mit langen Lieferzeiten, für die derzeit mehrjährige industrielle Rückstände bestehen.
Wenn diese Infrastrukturverpflichtungen auf typische Abschreibungszeiträume für Unternehmen umgelegt werden, wird die Rechnung bestrafend. Hochleistungsbeschleuniger, die mit einer dauerhaften thermischen Designleistung von 80 bis 90 Prozent laufen, erleiden innerhalb von drei bis vier Jahren einen Leistungsabfall und eine schnelle technologische Veralterung. OpenAI ist faktisch gezwungen, Hardware-Cluster im Wert von mehreren Milliarden Dollar abzuschreiben, bevor das Silizium seine ursprüngliche Einsatzgarantie überhaupt vollständig erfüllt hat, was einen ewigen Kreislauf der Kapitalreinvestition erzwingt, nur um die Latenzzeiten bei der Inferenz auf dem neuesten Stand zu halten.
Inferenz-Workloads und der Latenz-Overhead
Während millionenschwere Trainingsläufe die technischen Forschungsarbeiten dominieren, ist der stille Bilanzkiller die Steady-State-Inferenz. Während Millionen von Endverbrauchern und Unternehmenskunden mit generativen Schnittstellen interagieren, müssen Server kontinuierliche Gleitkommaoperationen aufrechterhalten. Der jüngste architektonische Wandel hin zu Modellen, die eine Test-Time-Compute durchführen – also versteckte Gedankengänge generieren, bevor sie eine finale Antwort ausgeben – erhöht das pro Nutzerabfrage erforderliche Compute-Budget exponentiell.
Aus ingenieurwissenschaftlicher Sicht verlagert dies die finanzielle Last direkt in die Pipeline des Rechenzentrums. Komplexe Überlegungen über lange Kontexte erfordern eine immense, kontinuierliche VRAM-Zuweisung, was zu Engpässen bei der Speicherbandbreite führt, die Rechenzentrumsbetreiber dazu zwingen, Cluster bei suboptimaler thermischer Effizienz zu betreiben. Die Hardware kann nicht effizient im Leerlauf betrieben werden; die grundlegende elektrische Auslastung bleibt unabhängig vom vorübergehenden Abfragevolumen hoch. Wenn Nutzer feste Pauschalabonnements für den Zugang zu fortgeschrittenen Reasoning-Engines bezahlen, kehrt ein hohes Nutzungsaufkommen die Stückökonomie um, was bedeutet, dass Vielnutzer die Kapitalreserven des Anbieters mit jeder erweiterten Inferenz-Sitzung aktiv aufzehren.
Unternehmenslizenzen und maßgeschneiderte API-Bereitstellungen bieten zwar bessere Margen, bringen aber auch strenge Service-Level-Agreements mit sich, die erhebliche Reserven an freier Kapazität erfordern. OpenAI muss kostspielige Compute-Reserven vorhalten, um globale Verkehrsspitzen abzufedern, und zahlt für ungenutzten Rack-Platz, Stromnetzreservierungen und Flüssigkeitskühlung, die während der Nebenzeiten keinen Umsatz generieren. In der industriellen Fertigung ist eine ungenutzte Kapazität ein sofortiges Warnsignal; im Bereich der Hyperscale-KI ist sie zum Standardpreis für den Erhalt von Marktanteilen geworden.
Die Kapitalobergrenze der algorithmischen Expansion
Die Entwicklung der Bilanz von OpenAI verdeutlicht letztlich einen breiteren Makrotrend im aufstrebenden Technologiesektor: Das Wettrüsten um Rechenleistung hat das Risikokapital hinter sich gelassen und erfordert nun die Finanzmechanismen von Staatsfonds und industriellen Schulden. Prognosen, wonach Frontier-Entwickler bis Ende der 2020er Jahre eine kumulative Recheninfrastruktur im Wert von 100 bis 200 Milliarden Dollar benötigen könnten, werden nicht mehr als Übertreibung abgetan. Es handelt sich um mechanische Berechnungen, die auf den empirischen Skalierungsgesetzen basieren, die das Parameterwachstum und das Datenvolumen diktieren.
Diese Abhängigkeit von einer beispiellosen Bilanzskalierung stellt eine existenzielle ingenieurwissenschaftliche Herausforderung dar. Wenn algorithmische Fortschritte auf abnehmende Grenzerträge stoßen – bei denen jeder Bruchteil an Genauigkeitsgewinn bei Benchmarks einen exponentiellen Sprung bei den Trainings-FLOPs und dem Stromverbrauch erfordert –, wird sich die Rendite auf das investierte Kapital rapide umkehren. Um die prognostizierten kumulativen Betriebskosten in Höhe von Hunderten Milliarden Dollar zu rechtfertigen, müssen diese Systeme über konversationelle Produktivitätstools hinausgehen und eine massive arbeitsersetzende Produktivität in zentralen Industrie-, Ingenieur- und Fertigungssektoren nachweisen.
Die verzerrten Gerüchte über astronomische Verluste, die in der Finanzpresse kursieren, entspringen letztlich einer grundlegenden Erkenntnis: Die Revolution der künstlichen Intelligenz ist kein ätherisches Softwareereignis, sondern eine massive Expansion der physischen Infrastruktur. Solange Frontier-Modelle an Silizium-Skalierung, komplexe Flüssigkeitskühlkreisläufe und dedizierte Multi-Gigawatt-Netzanschlüsse gebunden bleiben, wird die Bilanz des führenden Unternehmens weiterhin der eines hochverschuldeten Schwerindustrieunternehmens ähneln, das gegen mechanische Abschreibungen und algorithmische Grenzen ankämpft.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!