OpenAI 资产负债表的真实情况并非一家公司在琐碎的间接成本上挥霍相当于一个小国 GDP 的资金,而是传统软件经济学与物理基础设施之间发生的一次根本性碰撞。虽然博人眼球的数字往往将非现金股权激励、优先股重估以及未经情境说明的美元兑换人民币数据混为一谈,但为了将模型参数推向下一代水平所需的真实运营烧钱率本身就已经足够惊人。对于追踪硬件生命周期的机械工程师和工业分析师而言,OpenAI 的资产负债表看起来远不像一家硅谷软件企业,反而更像是一家正在建设未经测试的国家级电网的重工业公用事业公司。
会计现实与计算资本支出
要了解关于 2500 亿美元巨额亏损的传言是如何产生的,首先必须剖析处于 IPO 前规模的科技公司如何核算估值的快速增长。当 OpenAI 完成最近的融资轮次,使其私人估值达到约 1570 亿美元时,标准的会计准则强制要求进行账面调整,这可能使资产负债表在账面上看起来资不抵债。尽管实际上并没有现金离开公司金库,但优先股估值、由 Microsoft 等战略合作伙伴持有的可转换债券,以及针对顶尖人工智能研究人员的大额股权激励计划,在标准报告准则下都被计为严重的负债或损失。
然而,真正流出的现金揭示了其财务瓶颈:在数万个同步加速器上进行为期数月的训练运行,以及每日处理数百万次推理查询,其成本是残酷的。行业披露显示,OpenAI 的年化运营现金消耗约为 50 亿美元,而年化收入约为 37 亿至 40 亿美元。虽然这远非数千亿美元的流动性损毁,但其年化亏损额超过了大多数财富 500 强制造企业的收入,这是一个软件边际效益论调无法再掩盖的严峻结构性问题。
核心矛盾在于从传统的软件分发向主动计算生成的转变。在传统的软件即服务(SaaS)范式中,一旦代码编写并托管完毕,服务额外用户的边际成本趋近于零。在尖端人工智能领域,每一个生成的 Token 都会产生可衡量的热能、计算和电力成本。生成式智能中不存在零边际成本交易,这意味着毛利率面临着由硬件效率、数据中心热力学和批发用电费率决定的硬性机械底线。
浮点运算的真实价格
推理模型和多模态处理的每一次突破,都直接转化为加剧全球供应链紧张的硬件采购订单。一个能够生成尖端模型的训练集群需要数万个最先进的加速器、高带宽内存堆栈和复杂的互联光纤织物。当一家企业部署由 Nvidia Hopper 和即将推出的 Blackwell 架构组成的物理基础设施时,资本支出会迅速飙升至数百亿美元。
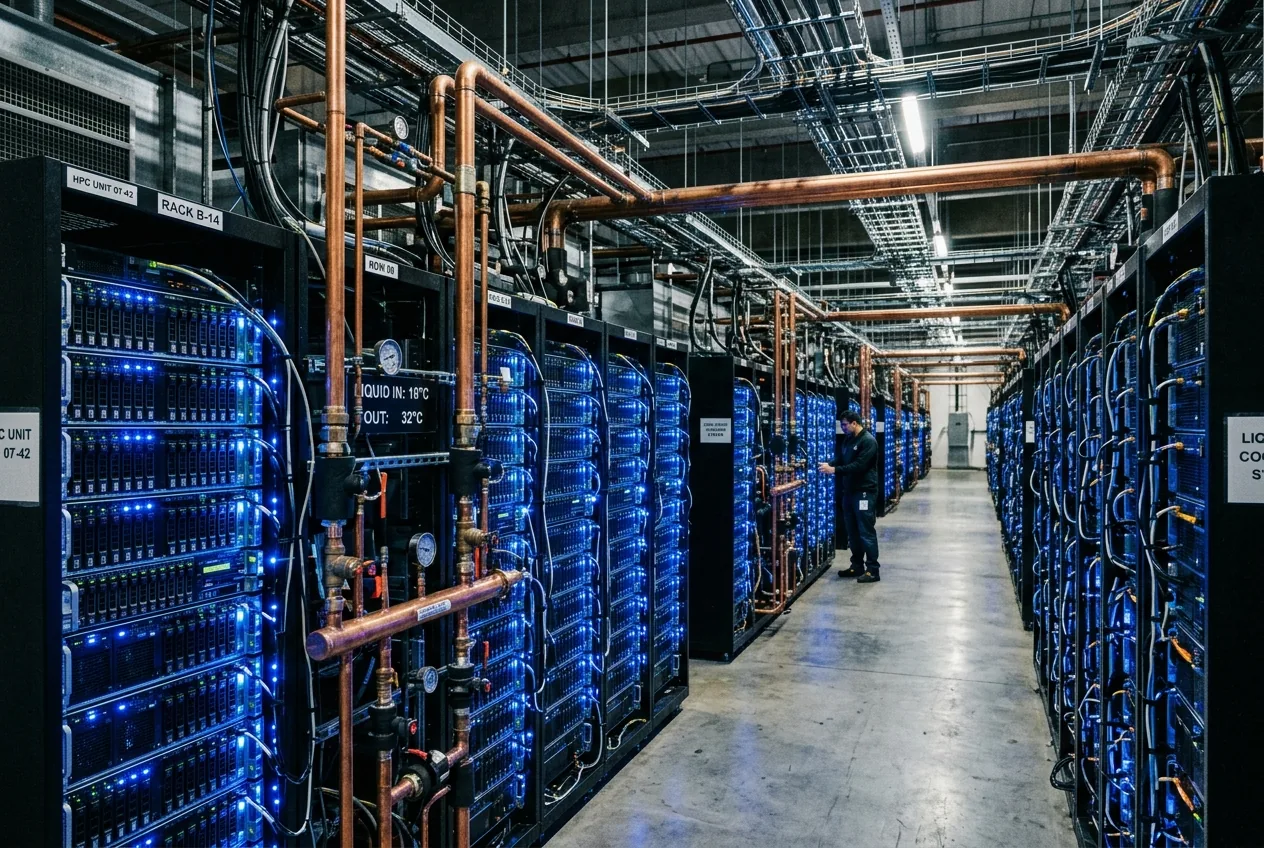
硬件物料清单仅仅是最初的障碍。现代 AI 集群需要超高密度的物理空间,机柜功耗密度经常超过每机柜 100 千瓦。散发这些热量需要复杂的闭环芯片直连液冷系统、工业泵组和专用冷却塔。这种机械开销无法仅仅通过自动化云控制台来启动;它需要土木工程许可、变电站配额以及目前面临多年工业积压的长交期电力变压器。
当这些基础设施投入被分摊到典型的企业折旧周期时,计算结果将变得极其沉重。以 80% 至 90% 持续热设计功耗运行的高性能加速器,在三到四年内就会出现性能下降和快速技术过时。OpenAI 实际上被迫在硅片甚至还没完全过完最初部署保修期之前就摊销价值数十亿美元的硬件集群,从而陷入了为了维持最先进的推理延迟而不得不进行的永续资本再投资循环。
推理工作负载与延迟开销
尽管数百万美元的训练运行占据了技术研究论文的主导地位,但资产负债表中沉默的杀手是稳态推理。随着数百万消费者和企业用户与生成式界面交互,服务器必须维持持续的浮点运算。近期向执行测试时计算(在输出最终答案前生成隐性思维链)的模型架构转变,呈指数级增加了每个用户查询所需的计算预算。
从工程角度来看,这直接将财务负担转移到了数据中心流水线中。在长上下文中提供复杂的推理需要巨大的持续显存(VRAM)分配,造成内存带宽瓶颈,迫使数据中心运营商在次优的热效率下运行集群。硬件无法高效闲置;无论瞬时查询量如何,基准电力开销始终保持在高位。当用户支付固定费用订阅以访问高级推理引擎时,高频使用模式会颠覆单位经济效益,这意味着高频用户每一次扩展推理会话都在主动消耗供应商的资本储备。
企业许可和定制化的 API 部署提供了更高的利润率,但也带来了严格的服务等级协议,要求预留大量的备用容量。OpenAI 必须维持高昂的计算余量来缓冲全球流量高峰,为闲置的机架空间、电网预留和液冷操作付费,这些在非高峰时段无法产生任何收入。在工业制造中,闲置产能是一个明显的危险信号;而在超大规模 AI 领域,这已成为维持市场份额的默认代价。
算法扩张的资本上限
OpenAI 资产负债表的轨迹最终凸显了新兴技术领域更广泛的宏观趋势:计算军备竞赛已经超越了风险投资,现在需要主权财富和工业债务等财务机制的支持。预测称尖端开发者到 2020 年代末可能需要 1000 亿至 2000 亿美元的累计计算基础设施,这已不再是夸大其词,而是源于决定参数增长和数据集规模的经验性缩放定律所作出的机械计算。
这种对前所未有的资产负债表规模的依赖,带来了生存性的工程挑战。如果算法进步达到边际收益递减点——即基准测试准确率的每一个微小提升都需要训练浮点运算(FLOPs)和用电量的指数级飞跃——那么投资资本的回报率将迅速倒挂。为了证明数千亿美元的预期累计运营成本是合理的,这些系统必须超越对话式生产力工具的范畴,在核心工业、工程和制造垂直领域展现出巨大的劳动力替代生产力。
金融媒体中流传的关于天文数字亏损的扭曲传言,最终源于一个基本的认知:人工智能革命不是一场虚幻的软件事件,而是一场大规模的物理基础设施扩张。只要尖端模型仍然受限于硅片缩放、复杂的液冷回路和专用的多吉瓦级电网互联,那么处于领先地位的公司的资产负债表,将继续像一家背负沉重债务、在机械折旧和算法极限中赛跑的重工业制造商。



Comments
No comments yet. Be the first!