La verdadera historia del balance financiero de OpenAI no es la de una empresa que gasta el PIB de una nación pequeña en gastos generales mundanos, sino la de una colisión fundamental entre la economía tradicional del software y la infraestructura física. Si bien las cifras que ocupan los titulares a menudo confunden la compensación en acciones no monetarias, las revalorizaciones de acciones preferentes y las cifras en yuanes chinos traducidas sin contexto, la tasa de consumo operativo real requerida para llevar los parámetros de los modelos al territorio de la próxima generación ya es, por sí sola, asombrosa. Para los ingenieros mecánicos y analistas industriales que siguen los ciclos de vida del hardware, el balance de OpenAI se parece mucho menos a una empresa de software de Silicon Valley y mucho más a una industria pesada que construye una red eléctrica nacional aún no probada.
Realidades contables frente a Capex computacional
Para entender cómo se originan los rumores de pérdidas masivas de un cuarto de billón de dólares, primero hay que diseccionar cómo las empresas tecnológicas que operan a una escala previa a la salida a bolsa contabilizan los rápidos aumentos de valoración. Cuando OpenAI cerró sus recientes rondas de financiación, elevando su valoración privada a aproximadamente 157.000 millones de dólares, los marcos contables estándar exigieron ajustes contables que pueden hacer que un balance parezca estructuralmente insolvente sobre el papel. Las valoraciones de acciones preferentes, los bonos convertibles en manos de socios estratégicos como Microsoft y los enormes paquetes de compensación en acciones para el personal de élite de investigación en IA se registran como graves pasivos o pérdidas según las directrices de información estándar, a pesar de que no sale dinero en efectivo de las arcas corporativas.
Sin embargo, el dinero en efectivo que realmente sale revela el verdadero cuello de botella financiero: el brutal costo de ejecutar millones de consultas de inferencia diarias junto con ciclos de entrenamiento de varios meses en decenas de miles de aceleradores sincronizados. Las divulgaciones de la industria indican que el consumo de efectivo operativo anual de OpenAI alcanzó aproximadamente los 5.000 millones de dólares sobre unos ingresos anualizados de entre 3.700 y 4.000 millones de dólares. Aunque está lejos de ser una destrucción de liquidez de cientos de miles de millones, operar con una pérdida anualizada mayor que los ingresos de la mayoría de las empresas manufactureras de la lista Fortune 500 presenta un problema estructural formidable que la retórica del margen de software ya no puede ocultar.
La tensión central reside en el cambio de la distribución clásica de software a la generación activa de computación. En los paradigmas tradicionales de software como servicio (SaaS), el costo marginal de atender a un usuario adicional converge hacia cero una vez que el código base está escrito y alojado. En la IA de vanguardia, cada token generado incurre en un costo térmico, computacional y eléctrico medible. No existen transacciones de costo marginal cero en la inteligencia generativa, lo que significa que los márgenes brutos enfrentan un límite mecánico estricto dictado por la eficiencia del hardware, la dinámica térmica de los centros de datos y las tarifas eléctricas mayoristas.
El precio real de las operaciones de punto flotante
Cada avance en los modelos de razonamiento y el procesamiento multimodal se traduce directamente en órdenes de adquisición de hardware que ponen a prueba las cadenas de suministro globales. Un clúster de entrenamiento capaz de producir modelos de vanguardia requiere decenas de miles de aceleradores de última generación, pilas de memoria de gran ancho de banda y complejas estructuras de interconexión óptica. Cuando una empresa despliega una huella de infraestructura compuesta por arquitecturas Nvidia Hopper y las próximas Blackwell, los gastos de capital ascienden rápidamente a decenas de miles de millones de dólares.
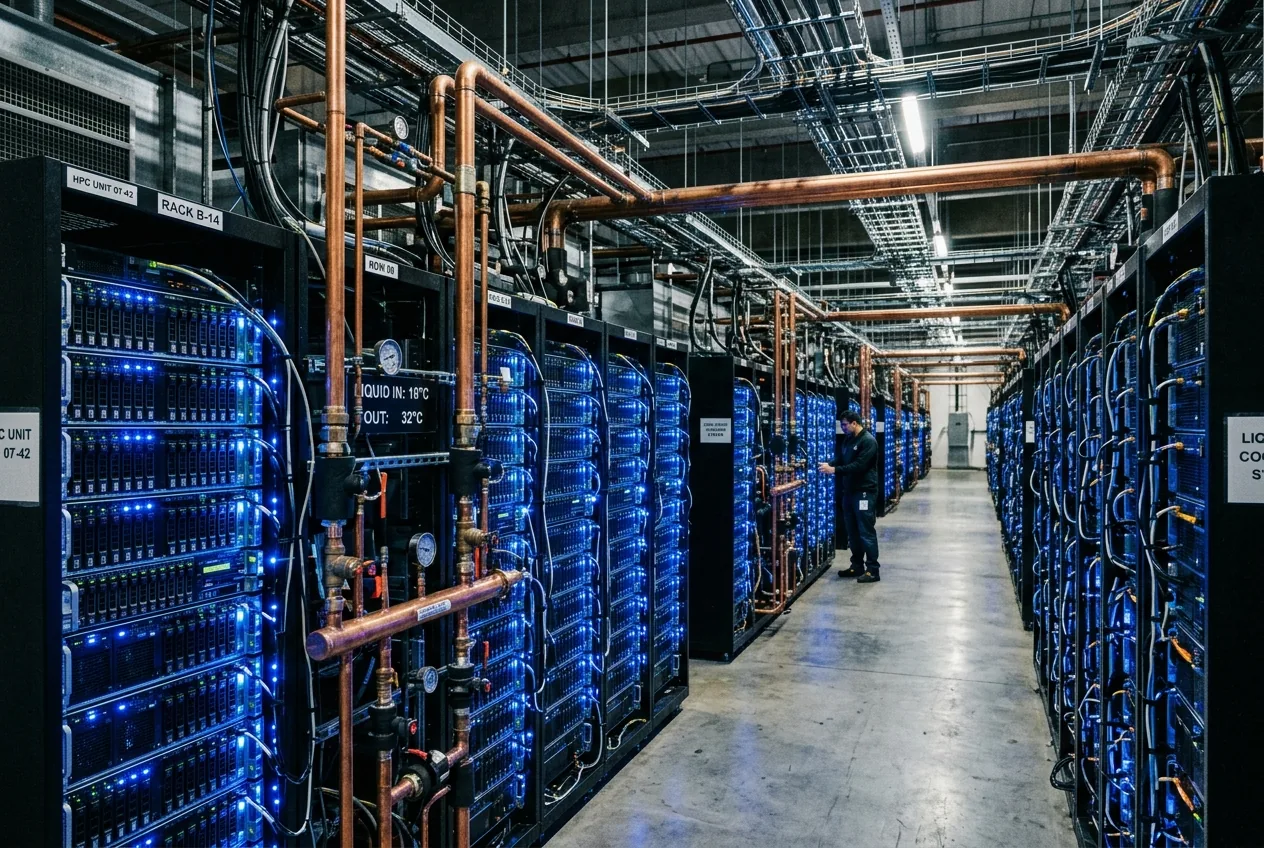
La lista de materiales del hardware es solo el obstáculo inicial. Un clúster de IA moderno exige una huella física ultradensa, con densidades de potencia en los racks que a menudo superan los 100 kilovatios por armario. Disipar esa salida térmica requiere sofisticados sistemas de refrigeración líquida directa al chip en circuito cerrado, conjuntos de bombeo industriales y torres de refrigeración construidas para tal fin. Estos gastos mecánicos no pueden simplemente ponerse en marcha a través de una consola en la nube automatizada; requieren permisos de ingeniería civil, asignaciones de subestaciones eléctricas y transformadores eléctricos de largo plazo de entrega que actualmente enfrentan retrasos industriales de varios años.
Cuando estos compromisos de infraestructura se calculan a lo largo de los plazos típicos de depreciación empresarial, las matemáticas se vuelven punitivas. Los aceleradores de alto rendimiento que funcionan a una potencia de diseño térmico sostenida del 80 al 90 por ciento sufren una degradación del rendimiento y una rápida obsolescencia tecnológica en un plazo de tres a cuatro años. OpenAI se ve efectivamente obligada a amortizar clústeres de hardware multimillonarios antes incluso de que el silicio haya superado por completo su garantía de despliegue inicial, lo que obliga a una cinta de correr perpetua de reinversión de capital simplemente para mantener la latencia de inferencia de vanguardia.
Cargas de trabajo de inferencia y la sobrecarga de latencia
Aunque los ciclos de entrenamiento multimillonarios dominan los trabajos de investigación técnica, el asesino silencioso del balance financiero es la inferencia en estado estacionario. A medida que millones de usuarios consumidores y empresariales interactúan con interfaces generativas, los servidores deben mantener operaciones de punto flotante continuas. El reciente giro arquitectónico hacia modelos que realizan cálculos durante el tiempo de prueba (generando cadenas de pensamiento ocultas antes de emitir una respuesta final) aumenta exponencialmente el presupuesto de cómputo requerido por consulta de usuario.
Desde una perspectiva de ingeniería, esto traslada la carga financiera directamente a la tubería del centro de datos. Proporcionar un razonamiento complejo sobre contextos largos exige una inmensa asignación continua de VRAM, creando cuellos de botella en el ancho de banda de la memoria que obligan a los operadores de centros de datos a ejecutar clústeres con eficiencias térmicas subóptimas. El hardware no puede mantenerse inactivo de manera eficiente; la sobrecarga eléctrica base sigue siendo alta independientemente del volumen de consultas transitorias. Cuando los usuarios pagan suscripciones de tarifa plana fija por el acceso a motores de razonamiento avanzados, los patrones de uso intenso invierten la economía unitaria, lo que significa que los usuarios de alto volumen consumen activamente las reservas de capital del proveedor con cada sesión de inferencia extendida.
Las licencias empresariales y los despliegues de API personalizados ofrecen márgenes superiores, pero también conllevan estrictos acuerdos de nivel de servicio que exigen importantes reservas de capacidad excedente. OpenAI debe mantener un costoso margen de cómputo para amortiguar los picos de tráfico global, pagando por espacio de rack inactivo, reservas de red eléctrica y operaciones de refrigeración líquida que no generan ingresos durante las horas de menor actividad. En la fabricación industrial, la capacidad ociosa es una señal de alerta inmediata; en el sector de la IA a hiperescala, se ha convertido en el precio por defecto para mantener la cuota de mercado.
El techo de capital de la expansión algorítmica
La trayectoria del balance financiero de OpenAI destaca en última instancia una tendencia macro más amplia en todo el sector de las tecnologías emergentes: la carrera armamentística computacional ha trascendido al capital de riesgo y ahora requiere los mecanismos financieros de la riqueza soberana y la deuda industrial. Las proyecciones que indican que los desarrolladores de vanguardia podrían requerir de 100.000 a 200.000 millones de dólares en infraestructura de computación acumulada para finales de la década de 2020 ya no se descartan como hipérboles. Son cálculos mecánicos derivados de las leyes de escala empíricas que dictan el crecimiento de los parámetros y el volumen de los conjuntos de datos.
Esta dependencia de una escala de balance sin precedentes crea un desafío de ingeniería existencial. Si los avances algorítmicos alcanzan rendimientos marginales decrecientes (donde cada ganancia fraccionaria en la precisión de referencia requiere un salto exponencial en los FLOPs de entrenamiento y el consumo eléctrico), el retorno sobre el capital invertido se invertirá rápidamente. Para justificar los cientos de miles de millones de dólares en costos operativos acumulados proyectados, estos sistemas deben ir más allá de las herramientas de productividad conversacional y demostrar una productividad masiva de reemplazo de mano de obra en sectores industriales, de ingeniería y de fabricación básicos.
Los rumores distorsionados de pérdidas astronómicas que circulan en la prensa financiera surgen en última instancia de una constatación básica: la revolución de la inteligencia artificial no es un evento de software etéreo, sino una expansión masiva de la infraestructura física. Mientras los modelos de vanguardia sigan atados al escalado del silicio, a los complejos bucles de refrigeración líquida y a las interconexiones de red dedicadas de varios gigavatios, el balance de la empresa que lidera la carga seguirá pareciéndose al de un fabricante industrial pesado fuertemente endeudado que compite contra la depreciación mecánica y los límites algorítmicos.



Comments
No comments yet. Be the first!