La véritable histoire du bilan comptable d'OpenAI n'est pas celle d'une entreprise engloutissant le PIB d'une petite nation dans des frais généraux banals, mais celle d'une collision fondamentale entre l'économie traditionnelle du logiciel et les infrastructures physiques. Si les chiffres qui font les gros titres confondent souvent les rémunérations en actions sans impact sur la trésorerie, les réévaluations d'actions privilégiées et les chiffres en yuans chinois traduits sans contexte, le taux de consommation opérationnelle réelle nécessaire pour propulser les paramètres des modèles vers le territoire de la nouvelle génération est déjà suffisamment stupéfiant en soi. Pour les ingénieurs en mécanique et les analystes industriels qui suivent les cycles de vie du matériel, le bilan d'OpenAI ressemble beaucoup moins à celui d'une entreprise de logiciels de la Silicon Valley qu'à celui d'une industrie lourde construisant un réseau électrique national dont la viabilité reste à prouver.
Réalités comptables et dépenses d'investissement en calcul
Pour comprendre l'origine des rumeurs faisant état de pertes massives se chiffrant en centaines de milliards de dollars, il faut d'abord analyser la manière dont les entreprises technologiques opérant à une échelle pré-introduction en bourse comptabilisent les augmentations rapides de valorisation. Lorsqu'OpenAI a clôturé ses récents cycles de financement, portant sa valorisation privée à environ 157 milliards de dollars, les cadres comptables standard ont imposé des ajustements théoriques qui peuvent faire paraître un bilan structurellement insolvable sur le papier. Les valorisations des actions privilégiées, les obligations convertibles détenues par des partenaires stratégiques comme Microsoft et les énormes plans de rémunération en actions pour les chercheurs en IA de haut niveau sont enregistrés comme des passifs ou des pertes importants selon les directives de reporting standard, bien qu'aucune somme en espèces ne sorte réellement des coffres de l'entreprise.
Cependant, les sorties de fonds réelles révèlent le véritable goulot d'étranglement financier : le coût brutal de l'exécution de millions de requêtes d'inférence quotidiennes couplées à des cycles d'entraînement de plusieurs mois sur des dizaines de milliers d'accélérateurs synchronisés. Les divulgations du secteur indiquent que la consommation annuelle de trésorerie opérationnelle d'OpenAI a atteint environ 5 milliards de dollars pour un chiffre d'affaires annualisé d'environ 3,7 à 4 milliards de dollars. Bien qu'on soit loin des centaines de milliards de destruction de liquidités, opérer avec une perte annualisée supérieure au chiffre d'affaires de la plupart des entreprises manufacturières du Fortune 500 présente un problème structurel majeur que la rhétorique sur les marges logicielles ne peut plus occulter.
La tension centrale réside dans le passage d'une distribution logicielle classique à une génération de calcul actif. Dans les paradigmes hérités du logiciel en tant que service (SaaS), le coût marginal de traitement d'un utilisateur supplémentaire converge vers zéro une fois que la base de code est écrite et hébergée. Dans l'IA de pointe, chaque jeton généré entraîne un coût thermique, computationnel et électrique mesurable. Il n'existe pas de transactions à coût marginal nul dans l'intelligence générative, ce qui signifie que les marges brutes sont confrontées à un plancher mécanique strict dicté par l'efficacité du matériel, la dynamique thermique des centres de données et les tarifs de gros de l'électricité.
Le prix réel des opérations à virgule flottante
Chaque percée dans les modèles de raisonnement et le traitement multimodal se traduit directement par des commandes d'achat de matériel qui pèsent sur les chaînes d'approvisionnement mondiales. Un cluster d'entraînement capable de produire des modèles à la pointe de la technologie nécessite des dizaines de milliers d'accélérateurs de pointe, des piles de mémoire à large bande passante et des tissus d'interconnexion optiques complexes. Lorsqu'une entreprise déploie une infrastructure composée d'architectures Nvidia Hopper et des futures Blackwell, les dépenses d'investissement atteignent rapidement des dizaines de milliards de dollars.
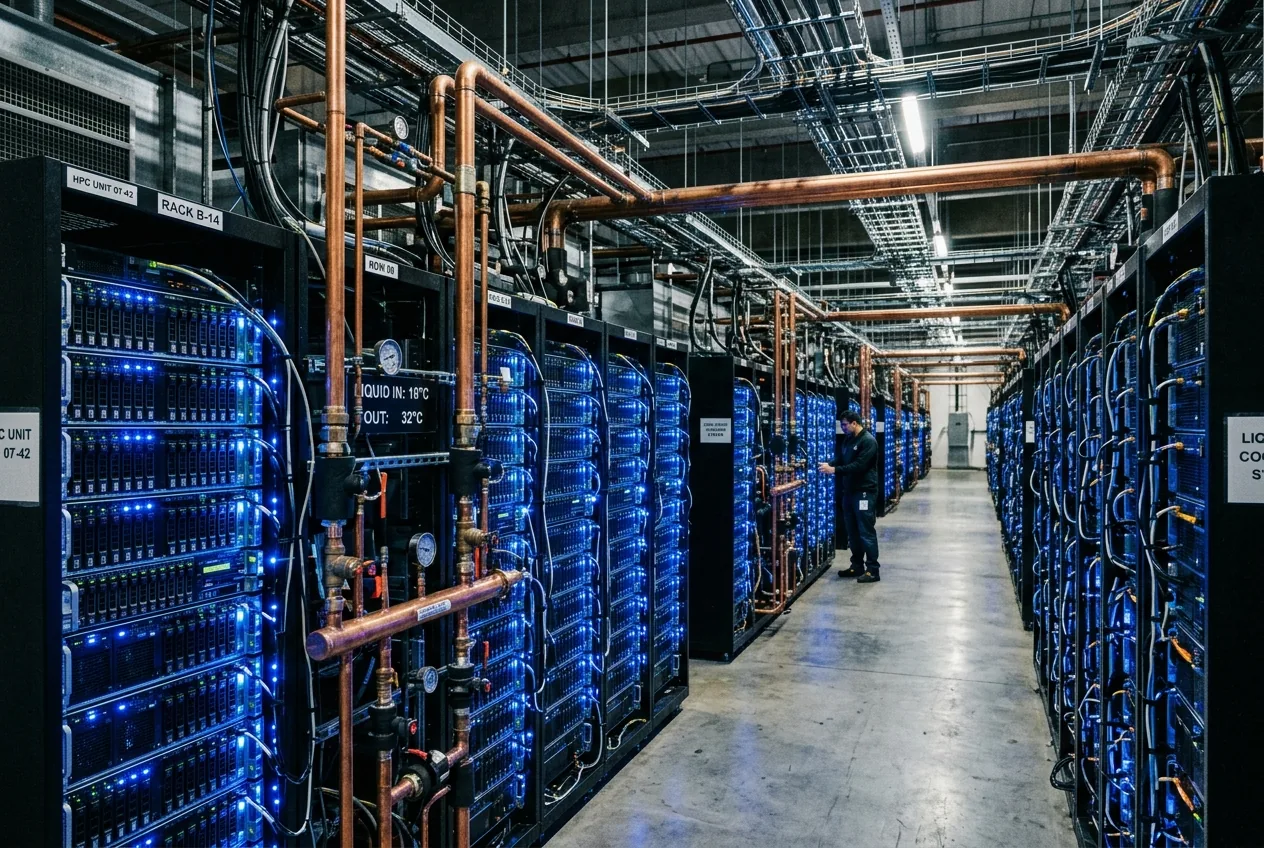
La nomenclature du matériel n'est que le premier obstacle. Un cluster d'IA moderne exige une empreinte physique ultra-dense, avec des densités de puissance en rack dépassant fréquemment 100 kilowatts par baie. La dissipation de cette puissance thermique nécessite des systèmes sophistiqués de refroidissement liquide direct sur puce en boucle fermée, des réseaux de pompage industriels et des tours de refroidissement conçues à cet effet. Ces frais généraux mécaniques ne peuvent pas simplement être mis en service via une console cloud automatisée ; ils nécessitent des permis de génie civil, des allocations de sous-stations électriques et des transformateurs électriques à long délai d'approvisionnement qui font actuellement l'objet de retards industriels se comptant en années.
Lorsque ces engagements en infrastructures sont calculés sur des périodes d'amortissement typiques des entreprises, les calculs deviennent punitifs. Les accélérateurs haute performance fonctionnant à une puissance thermique soutenue de 80 à 90 % subissent une dégradation des performances et une obsolescence technologique rapide en trois à quatre ans. OpenAI est effectivement contraint d'amortir des clusters matériels de plusieurs milliards de dollars avant même que le silicium n'ait épuisé sa garantie de déploiement initiale, forçant un cycle perpétuel de réinvestissement en capital simplement pour maintenir une latence d'inférence de pointe.
Charges de travail d'inférence et surcharge de latence
Bien que les cycles d'entraînement de plusieurs millions de dollars dominent les articles de recherche technique, le tueur silencieux du bilan comptable est l'inférence en régime permanent. Alors que des millions d'utilisateurs grand public et professionnels interagissent avec des interfaces génératives, les serveurs doivent maintenir des opérations à virgule flottante en continu. Le pivot architectural récent vers des modèles qui effectuent du calcul au moment du test — générant des chaînes de pensée cachées avant de fournir une réponse finale — augmente de façon exponentielle le budget de calcul requis par requête utilisateur.
D'un point de vue technique, cela déplace le fardeau financier directement dans le pipeline du centre de données. Fournir un raisonnement complexe sur de longs contextes exige une allocation de mémoire vidéo (VRAM) continue et immense, créant des goulots d'étranglement au niveau de la bande passante mémoire qui forcent les opérateurs de centres de données à faire fonctionner les clusters avec des efficacités thermiques sous-optimales. Le matériel ne peut pas être mis au ralenti efficacement ; la consommation électrique de base reste élevée quel que soit le volume transitoire des requêtes. Lorsque les utilisateurs paient des abonnements à tarif fixe pour accéder à des moteurs de raisonnement avancés, les habitudes de consommation intensive inversent l'économie unitaire, ce qui signifie que les utilisateurs à fort volume épuisent activement les réserves de capital du fournisseur à chaque session d'inférence prolongée.
Les licences d'entreprise et les déploiements d'API personnalisés offrent de meilleures marges, mais ils imposent également des accords de niveau de service (SLA) stricts qui exigent d'importantes réserves de capacité inutilisée. OpenAI doit maintenir une marge de calcul coûteuse pour se prémunir contre les pics de trafic mondiaux, en payant pour l'espace rack inutilisé, les réservations de réseau électrique et les opérations de refroidissement liquide qui ne génèrent aucun revenu pendant les heures creuses. Dans l'industrie manufacturière, la capacité inutilisée est un signal d'alarme immédiat ; dans le secteur de l'IA à très grande échelle, c'est devenu le prix à payer pour conserver des parts de marché.
Le plafond de capital de l'expansion algorithmique
La trajectoire du bilan d'OpenAI souligne en fin de compte une tendance macroéconomique plus large dans le secteur des technologies émergentes : la course aux armements computationnels a dépassé le capital-risque et nécessite désormais les mécanismes financiers des fonds souverains et de la dette industrielle. Les projections indiquant que les développeurs de systèmes de pointe pourraient avoir besoin de 100 à 200 milliards de dollars en infrastructures de calcul cumulées d'ici la fin des années 2020 ne sont plus rejetées comme des exagérations. Ce sont des calculs mécaniques dérivés des lois d'échelle empiriques qui dictent la croissance des paramètres et le volume des jeux de données.
Cette dépendance à une échelle de bilan sans précédent crée un défi technique existentiel. Si les avancées algorithmiques atteignent des rendements marginaux décroissants — où chaque gain fractionnaire de précision de référence nécessite un bond exponentiel des FLOP d'entraînement et de la consommation électrique — le retour sur investissement en capital s'inversera rapidement. Pour justifier les centaines de milliards de dollars de coûts opérationnels cumulés projetés, ces systèmes doivent dépasser le stade des outils de productivité conversationnelle et démontrer une productivité massive de remplacement de la main-d'œuvre dans les secteurs industriels, techniques et manufacturiers de base.
Les rumeurs déformées de pertes astronomiques circulant dans la presse financière découlent finalement d'une prise de conscience fondamentale : la révolution de l'intelligence artificielle n'est pas un événement logiciel éthéré, mais une expansion massive des infrastructures physiques. Tant que les modèles de pointe resteront liés à la mise à l'échelle du silicium, aux boucles de refroidissement liquide complexes et aux interconnexions réseau dédiées de plusieurs gigawatts, le bilan de l'entreprise en tête de file continuera de ressembler à celui d'un fabricant industriel lourdement endetté, en course contre la dépréciation mécanique et les limites algorithmiques.



Comments
No comments yet. Be the first!