La vera storia del bilancio di OpenAI non è quella di un'azienda che brucia il PIL di una piccola nazione in spese generali banali, ma quella di una collisione fondamentale tra l'economia tradizionale del software e l'infrastruttura fisica. Sebbene i numeri che fanno notizia spesso confondano la compensazione azionaria non monetaria, le rivalutazioni delle azioni privilegiate e le cifre in yuan cinesi tradotte senza contesto, l'effettivo tasso di consumo operativo necessario per spingere i parametri dei modelli nel territorio della nuova generazione è di per sé sbalorditivo. Per gli ingegneri meccanici e gli analisti industriali che monitorano i cicli di vita dell'hardware, il bilancio di OpenAI assomiglia molto meno a quello di un'impresa di software della Silicon Valley e molto più a quello di una utility industriale pesante che sta costruendo una rete elettrica nazionale non ancora collaudata.
Realtà contabili contro Capex computazionale
Per capire da dove provengano le voci di perdite massicce, nell'ordine dei 250 miliardi di dollari, bisogna innanzitutto analizzare come le aziende tecnologiche che operano a una scala pre-IPO contabilizzino i rapidi aumenti di valutazione. Quando OpenAI ha chiuso i suoi recenti round di finanziamento, portando la sua valutazione privata a circa 157 miliardi di dollari, i quadri contabili standard hanno imposto adeguamenti cartacei che possono far apparire un bilancio strutturalmente insolvente sulla carta. Le valutazioni delle azioni privilegiate, le obbligazioni convertibili detenute da partner strategici come Microsoft e gli ingenti pacchetti di compensi basati su azioni per il personale di ricerca AI d'élite vengono registrati come gravi passività o perdite secondo le linee guida di rendicontazione standard, nonostante non ci sia alcuna uscita reale di cassa dalle casse aziendali.
Tuttavia, il denaro che effettivamente esce rivela il vero collo di bottiglia finanziario: il costo brutale della gestione di milioni di query di inferenza giornaliere accanto a sessioni di addestramento della durata di mesi su decine di migliaia di acceleratori sincronizzati. Le comunicazioni del settore indicano che il consumo annuo di cassa operativa di OpenAI ha raggiunto circa 5 miliardi di dollari su un fatturato annualizzato di circa 3,7-4 miliardi di dollari. Sebbene sia lontano da centinaia di miliardi di distruzione di liquidità, operare con una perdita annualizzata superiore al fatturato della maggior parte delle aziende manifatturiere della classifica Fortune 500 presenta un problema strutturale formidabile che la retorica dei margini del software non può più ignorare.
La tensione centrale risiede nel passaggio dalla classica distribuzione di software alla generazione attiva di calcolo. Nei paradigmi legacy di software-as-a-service, il costo marginale per servire un utente aggiuntivo converge verso lo zero una volta che il codice è stato scritto e ospitato. Nell'AI di frontiera, ogni singolo token generato comporta un costo termico, computazionale ed elettrico misurabile. Non esistono transazioni a costo marginale zero nell'intelligenza generativa, il che significa che i margini lordi devono affrontare un limite meccanico rigido dettato dall'efficienza dell'hardware, dalle dinamiche termiche dei data center e dalle tariffe elettriche all'ingrosso.
Il prezzo reale delle operazioni in virgola mobile
Ogni svolta nei modelli di ragionamento e nell'elaborazione multimodale si traduce direttamente in ordini di approvvigionamento di hardware che mettono sotto pressione le catene di approvvigionamento globali. Un cluster di addestramento in grado di produrre modelli all'avanguardia richiede decine di migliaia di acceleratori all'avanguardia, stack di memoria a banda larga elevata e complessi tessuti di interconnessione ottica. Quando un'azienda distribuisce un'impronta infrastrutturale composta dalle architetture Nvidia Hopper e dalle imminenti Blackwell, le spese in conto capitale salgono rapidamente nell'ordine delle decine di miliardi di dollari.
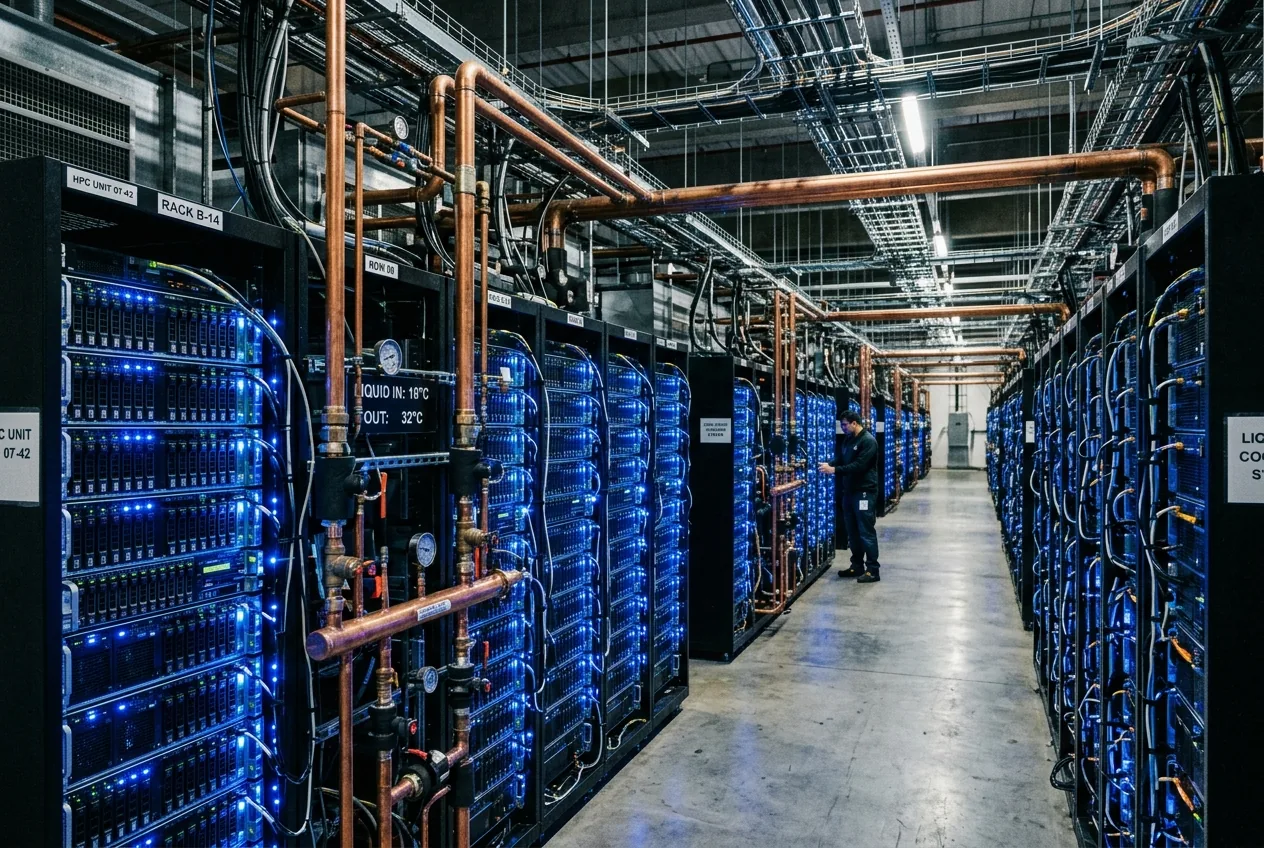
La distinta base dell'hardware è solo l'ostacolo iniziale. Un moderno cluster AI richiede un'impronta fisica ultra-densa, con densità di potenza dei rack che spesso superano i 100 kilowatt per armadio. Dissipare tale produzione termica richiede sofisticati sistemi di raffreddamento a liquido a circuito chiuso diretto al chip, schiere di pompe industriali e torri di raffreddamento costruite appositamente. Questo sovraccarico meccanico non può essere semplicemente avviato tramite una console cloud automatizzata; richiede permessi di ingegneria civile, assegnazioni di sottostazioni elettriche e trasformatori elettrici a lunga scadenza che attualmente affrontano arretrati industriali pluriennali.
Quando questi impegni infrastrutturali vengono calcolati secondo i tipici tempi di ammortamento aziendali, la matematica diventa punitiva. Gli acceleratori ad alte prestazioni che operano con una potenza di progettazione termica sostenuta tra l'80 e il 90 percento subiscono un degrado delle prestazioni e una rapida obsolescenza tecnologica entro tre o quattro anni. OpenAI è effettivamente costretta ad ammortizzare cluster hardware da miliardi di dollari prima ancora che il silicio abbia completamente esaurito la sua garanzia di distribuzione iniziale, costringendo a un tapis roulant perpetuo di reinvestimento di capitale semplicemente per mantenere una latenza di inferenza all'avanguardia.
Carichi di lavoro di inferenza e sovraccarico di latenza
Mentre i cicli di addestramento da milioni di dollari dominano i documenti di ricerca tecnica, il killer silenzioso del bilancio è l'inferenza a stato stazionario. Poiché milioni di utenti consumer e aziendali interagiscono con interfacce generative, i server devono sostenere operazioni continue in virgola mobile. Il recente pivot architettonico verso modelli che eseguono calcoli durante il test — generando catene di pensiero nascoste prima di produrre una risposta finale — aumenta esponenzialmente il budget di calcolo richiesto per ogni query dell'utente.
Dal punto di vista ingegneristico, questo sposta l'onere finanziario direttamente nella pipeline del data center. Fornire un ragionamento complesso su contesti lunghi richiede un'immensa allocazione continua di VRAM, creando colli di bottiglia nella larghezza di banda della memoria che costringono gli operatori dei data center a far funzionare i cluster a efficienze termiche non ottimali. L'hardware non può essere lasciato inattivo in modo efficiente; il sovraccarico elettrico di base rimane elevato indipendentemente dal volume transitorio delle query. Quando gli utenti pagano abbonamenti a tariffa fissa per l'accesso a motori di ragionamento avanzati, i modelli di utilizzo intensivo invertono l'economia unitaria, il che significa che gli utenti ad alto volume bruciano attivamente le riserve di capitale del fornitore con ogni sessione di inferenza prolungata.
Le licenze aziendali e le distribuzioni API personalizzate offrono margini superiori, ma comportano anche rigorosi accordi sul livello di servizio che richiedono significative riserve di capacità di riserva. OpenAI deve mantenere costosi margini di calcolo per proteggersi da picchi di traffico globali, pagando per spazio rack inattivo, prenotazioni della rete elettrica e operazioni di raffreddamento a liquido che non generano alcun ricavo durante le ore non di punta. Nella produzione industriale, la capacità inattiva è un segnale di allarme immediato; nel settore dell'AI su iperscala, è diventato il prezzo predefinito per mantenere la quota di mercato.
Il tetto di capitale dell'espansione algoritmica
La traiettoria del bilancio di OpenAI evidenzia in definitiva una tendenza macroeconomica più ampia in tutto il settore tecnologico emergente: la corsa agli armamenti computazionali ha superato il capitale di rischio e ora richiede i meccanismi finanziari della ricchezza sovrana e del debito industriale. Le proiezioni che indicano che gli sviluppatori di frontiera potrebbero richiedere da 100 a 200 miliardi di dollari in infrastrutture di calcolo cumulative entro la fine degli anni 2020 non sono più liquidate come iperbole. Sono calcoli meccanici derivati dalle leggi di scala empiriche che dettano la crescita dei parametri e il volume dei dataset.
Questa dipendenza da una scala di bilancio senza precedenti crea una sfida ingegneristica esistenziale. Se i progressi algoritmici raggiungono rendimenti marginali decrescenti — dove ogni guadagno frazionario nell'accuratezza del benchmark richiede un salto esponenziale nei FLOP di addestramento e nell'assorbimento elettrico — il ritorno sul capitale investito si invertirà rapidamente. Per giustificare le centinaia di miliardi di dollari di costi operativi cumulativi previsti, questi sistemi devono andare oltre gli strumenti di produttività conversazionale e dimostrare una massiccia produttività di sostituzione del lavoro attraverso i principali settori industriali, ingegneristici e manifatturieri.
Le voci distorte di perdite astronomiche che circolano nella stampa finanziaria derivano in definitiva da una constatazione fondamentale: la rivoluzione dell'intelligenza artificiale non è un evento software etereo, ma una massiccia espansione dell'infrastruttura fisica. Finché i modelli di frontiera rimarranno legati al ridimensionamento del silicio, ai complessi circuiti di raffreddamento a liquido e alle interconnessioni di rete multi-gigawatt dedicate, il bilancio dell'azienda che guida la carica continuerà a somigliare a quello di un produttore industriale pesante fortemente indebitato, in corsa contro l'ammortamento meccanico e i limiti algoritmici.



Comments
No comments yet. Be the first!