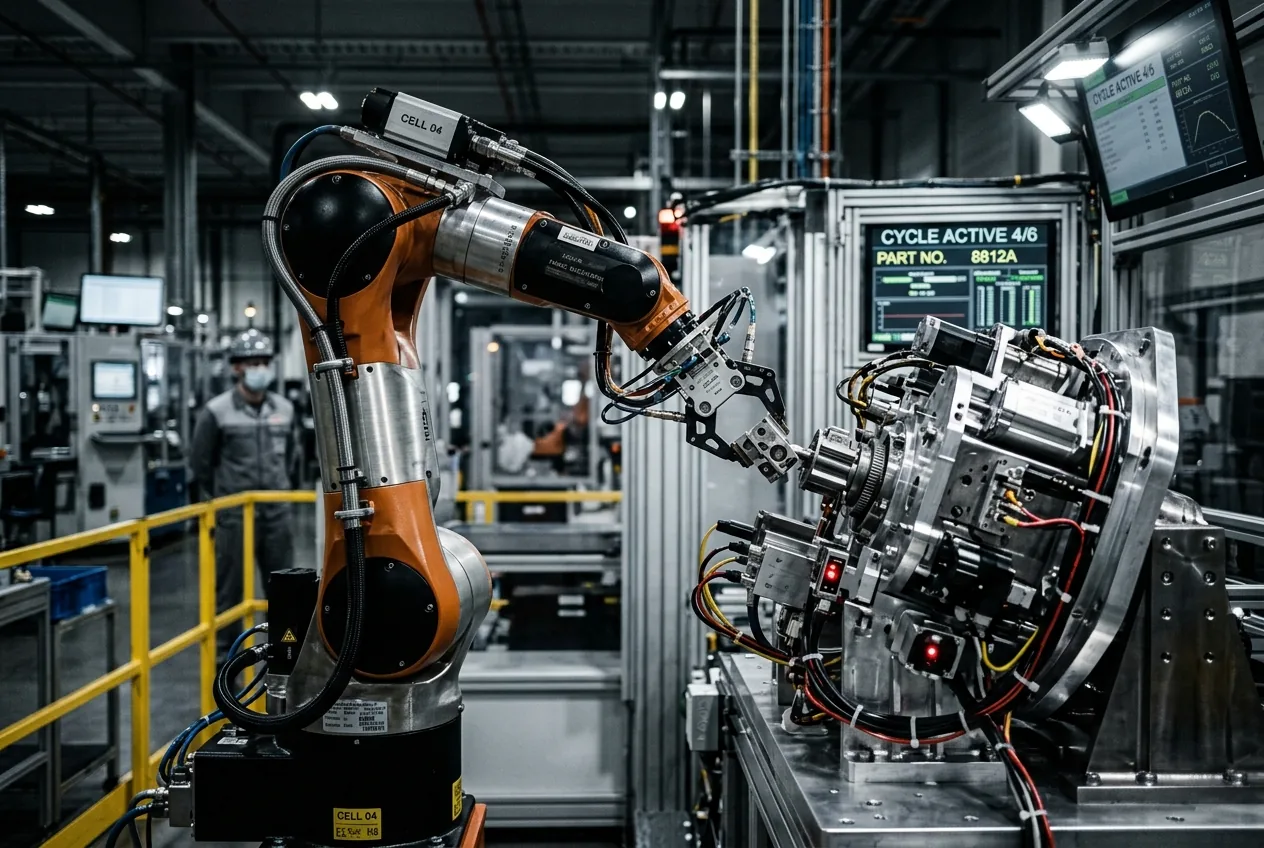
Lorsque les modèles d'intelligence artificielle de pointe effectuent leurs démonstrations traditionnelles, la Silicon Valley les évalue généralement à travers le prisme étroit de la productivité numérique : codage automatisé, fluidité conversationnelle et génération de contenus synthétiques. Pourtant, les dernières démonstrations de capacités issues de l'écosystème technique d'OpenAI et de Microsoft indiquent un changement bien plus significatif. Les modèles de pointe ne se contentent plus d'analyser des requêtes en langage naturel ; ils naviguent systématiquement dans une logique causale complexe, un raisonnement spatial et une télémétrie opérationnelle en temps réel. Pour ceux d'entre nous qui observent depuis l'atelier et le laboratoire de robotique, les derniers benchmarks de modèles représentent quelque chose de fondamentalement différent des itérations précédentes. Nous assistons à la transition progressive des grands modèles de langage, passant de scribes numériques haute vitesse à des moteurs de planification généralisés capables d'interfacer avec des systèmes mécaniques.
Les démonstrations techniques mettent l'accent sur une architecture affinée autour du calcul adaptatif durant l'inférence (test-time compute), de la fusion multimodale de capteurs et de la décomposition structurelle des problèmes. Plutôt que de s'appuyer entièrement sur le « force brute » de la correspondance statistique de jetons acquise lors du pré-entraînement, le dernier pipeline de pointe consacre des budgets d'inférence variables pour vérifier ses propres étapes intermédiaires avant de générer un résultat. Dans le développement logiciel, cela évite les bugs logiques silencieux. Dans l'ingénierie mécanique, l'automatisation et la logistique de la chaîne d'approvisionnement, cette capacité modifie le calcul fondamental visant à déterminer si un réseau de neurones peut être utilisé à proximité d'équipements physiques.
La mécanique du calcul durant l'inférence
Pour comprendre pourquoi la dernière itération est importante pour l'industrie lourde, il faut décrypter l'évolution de la manière dont les ressources informatiques sont allouées. Pendant plusieurs années, le progrès de l'IA de pointe a suivi des lois d'échelle empiriques dominées par le pré-entraînement : alimenter de plus vastes ensembles de textes et d'images dans des clusters plus grands d'unités de traitement graphique (GPU) lors de cycles d'entraînement plus longs. Bien qu'efficace pour élargir la base de connaissances latente d'un modèle, cette approche produisait régulièrement des modèles sujets à des hallucinations catastrophiques lorsqu'ils étaient confrontés à des cas limites en physique réelle ou à des calculs cinématiques en plusieurs étapes.
Le nouveau paradigme opérationnel déplace une charge computationnelle importante vers des chaînes de raisonnement effectuées au moment de l'inférence. Lorsqu'il est confronté à un problème de diagnostic multicouche — tel qu'une signature de vibration thermique inhabituelle sur l'arbre d'une turbine secondaire — le modèle ne génère pas instantanément une réponse superficielle. Au lieu de cela, il formule systématiquement des hypothèses internes, interroge des contraintes physiques simulées, vérifie les incohérences mathématiques et élague les branches de décision invalides avant de conclure. Cette boucle de raisonnement délibérée et pseudo-déterministe réduit considérablement les modes de défaillance erratiques qui ont longtemps rendu les ingénieurs en mécanique hésitants à déployer des grands modèles de langage dans des boucles de contrôle critiques.
Dans les démonstrations pratiques, cette architecture a traité des schémas structurels complexes, analysant des dessins d'ingénierie multidimensionnels (métadonnées CAO) parallèlement à une télémétrie de séries temporelles en temps réel. Les modèles multimodaux précédents pouvaient identifier des composants dans une image, reconnaissant une pompe hydraulique ou un moteur pas à pas électrique avec une précision raisonnable. Les dernières démonstrations vont plus loin : le modèle trace les chemins du fluide hydraulique, calcule les restrictions de débit basées sur la documentation des états des vannes et déduit pourquoi une chute de pression spécifique sur le collecteur s'est produite trois étapes plus loin dans la chaîne mécanique.
Relier l'intelligence du cloud et le goulot d'étranglement local
Malgré les percées analytiques présentées, une réalité technique tempère l'optimisme effréné entourant les modèles de pointe hébergés dans le cloud : la latence. Les démonstrations de pointe reposent sur des centres de données à haute densité ancrés par les clusters de supercalculateurs de Microsoft Azure, tirant parti d'accélérateurs personnalisés, d'une mémoire à large bande passante et de racks de matériel refroidis par liquide. La communication avec ces clusters introduit des latences d'aller-retour mesurées en centaines de millisecondes, voire en secondes.
Dans l'automatisation industrielle, la planification de haut niveau fonctionne sur un domaine d'horloge totalement différent de l'exécution matérielle en temps réel. Un bras robotique prélevant des pièces forgées non triées dans un bac repose sur des protocoles de bus de terrain déterministes comme EtherCAT ou PROFINET, avec des temps de cycle compris entre une et dix millisecondes. Si un signal de commande manque sa fenêtre déterministe, un arrêt d'urgence est déclenché pour éviter les collisions mécaniques ou les blessures des travailleurs. Par conséquent, les moteurs de raisonnement de pointe ne remplaceront pas de sitôt les automates programmables industriels (API) ou les contrôleurs de moteur embarqués.
Au lieu de cela, l'architecture viable émergeant de ces démonstrations repose sur des topologies de contrôle hiérarchiques. Le modèle de pointe fonctionne comme un superviseur cognitif, positionné au niveau de la technologie opérationnelle. Il surveille le débit au niveau macro, planifie des trajectoires d'outils dynamiques, diagnostique la dégradation intermittente des machines et recompile dynamiquement des routines de contrôle de haut niveau. Ces routines compilées sont ensuite transmises vers le bas aux ordinateurs industriels durcis et aux microcontrôleurs exécutant des systèmes d'exploitation temps réel. Cette division du travail préserve la sécurité physique tout en offrant enfin aux installations automatisées un degré de flexibilité opérationnelle qu'une logique câblée classique ne pourrait jamais fournir.
Intelligence spatiale et défi cinématique
Le front techniquement le plus exigeant affiché dans les derniers travaux d'OpenAI est sans doute la synthèse de l'intelligence spatiale. En robotique, la vision a historiquement été traitée comme un pipeline découplé : un algorithme de détection d'objets encadre un élément, un capteur de profondeur externe génère un nuage de points et un solveur de cinématique inverse calcule les angles des articulations pour un effecteur. Cette approche fragmentée est notoirement fragile, peinant face aux surfaces métalliques réfléchissantes, aux objets déformables et aux changements d'éclairage ambiant en usine.
Les modèles multimodaux unifiés digèrent directement les flux visuels bruts, les cartes de profondeur et les réseaux de retour tactile, construisant une représentation latente interne du volume physique et de la distribution de masse. Dans les évaluations récentes, le modèle a démontré sa capacité à prédire comment des composants non organisés se déplaceraient lorsqu'ils sont soumis à un contact mécanique, exécutant efficacement une approximation physique interne. Pour les hubs logistiques gérant du fret hétérogène et les lignes de fabrication jonglant avec des changements rapides de produits, cela fait la différence entre un robot qui s'arrête face à une résistance physique inattendue et un robot qui ajuste sa prise en fonction de la redistribution dynamique du poids.
Cependant, l'exécution de simulations physiques entièrement dans l'espace vectoriel latent reste sujette à des erreurs physiques subtiles. Bien que le modèle excelle dans le bon sens visuel, il lui manque encore une compréhension intrinsèque et fondamentale de la thermodynamique, de l'usure métallurgique et des coefficients de friction sous des charges extrêmes. Les ingénieurs ne peuvent pas simplement confier les calculs d'usure des outils ou les prédictions de fatigue structurelle à un réseau neuronal profond sans ancrer ses résultats dans des bibliothèques physiques déterministes et vérifiées, comme les logiciels d'analyse par éléments finis (FEA). Les démonstrations actuelles prouvent que l'IA peut formuler la configuration du problème ; les ingénieurs humains et les solveurs numériques classiques doivent toujours valider les calculs.
L'économie du calcul des chaînes d'approvisionnement modernes
Au-delà de l'architecture technique réside la réalité incontournable de l'économie unitaire. L'entraînement et l'exploitation des modèles de pointe exigent des dépenses en capital stupéfiantes, reflétées par les expansions massives de l'infrastructure des centres de données, des sous-stations électriques spécialisées et des interconnexions haute performance de Microsoft. Pour qu'une entreprise justifie l'intégration d'un modèle de pointe dans son empreinte de fabrication ou d'entreposage, le système doit offrir des réductions de coûts opérationnels claires qui compensent les frais de jetons d'inférence.
L'automatisation actuelle des entreprises repose sur une standardisation rigide, car standardiser une chaîne de montage coûte moins cher que d'embaucher des ingénieurs d'intégration pour reprogrammer constamment les robots. Si les modèles de pointe réduisent le coût d'intégration logicielle de la robotique industrielle en générant de manière autonome du code machine valide et vérifié pour des cycles de fabrication personnalisés, l'équilibre des dépenses en capital bascule. Les petits et moyens fabricants pourraient soudainement atteindre une automatisation à forte mixité et faible volume — une capacité historiquement réservée aux immenses usines d'assemblage automobile dotées de solides équipes d'ingénierie.
Le retour sur investissement ne viendra pas du remplacement des opérateurs humains par des robots humanoïdes utilisant des API cloud. Il viendra de la réduction des temps d'arrêt non planifiés dans les industries de transformation lourde. Lorsqu'une installation de traitement chimique ou une aciérie à coulée continue subit une interruption imprévue, les pertes se mesurent en dizaines de milliers de dollars par minute. Un modèle de pointe superviseur capable de croiser des capteurs acoustiques, l'imagerie thermique, l'historique de maintenance et les manuels d'utilisation pour isoler une défaillance mécanique imminente des heures avant une panne catastrophique rembourse son budget informatique annuel en une seule équipe.
Le long chemin du benchmark à l'atelier
Les avancées techniques itératives d'OpenAI continuent de redéfinir les frontières du raisonnement synthétique, démontrant que l'intelligence machine peut dépasser les tours de magie conversationnels pour entrer dans une déduction logique complexe et multi-niveaux. La communauté de l'ingénierie doit considérer ces démonstrations de capacités avec autant d'enthousiasme que de scepticisme professionnel. Démontrer une déduction spatiale dans un environnement d'évaluation est fondamentalement différent d'opérer au sein d'une usine d'emboutissage d'acier saturée d'interférences électromagnétiques, de brouillard hydraulique et d'intenses vibrations mécaniques.



Comments
No comments yet. Be the first!