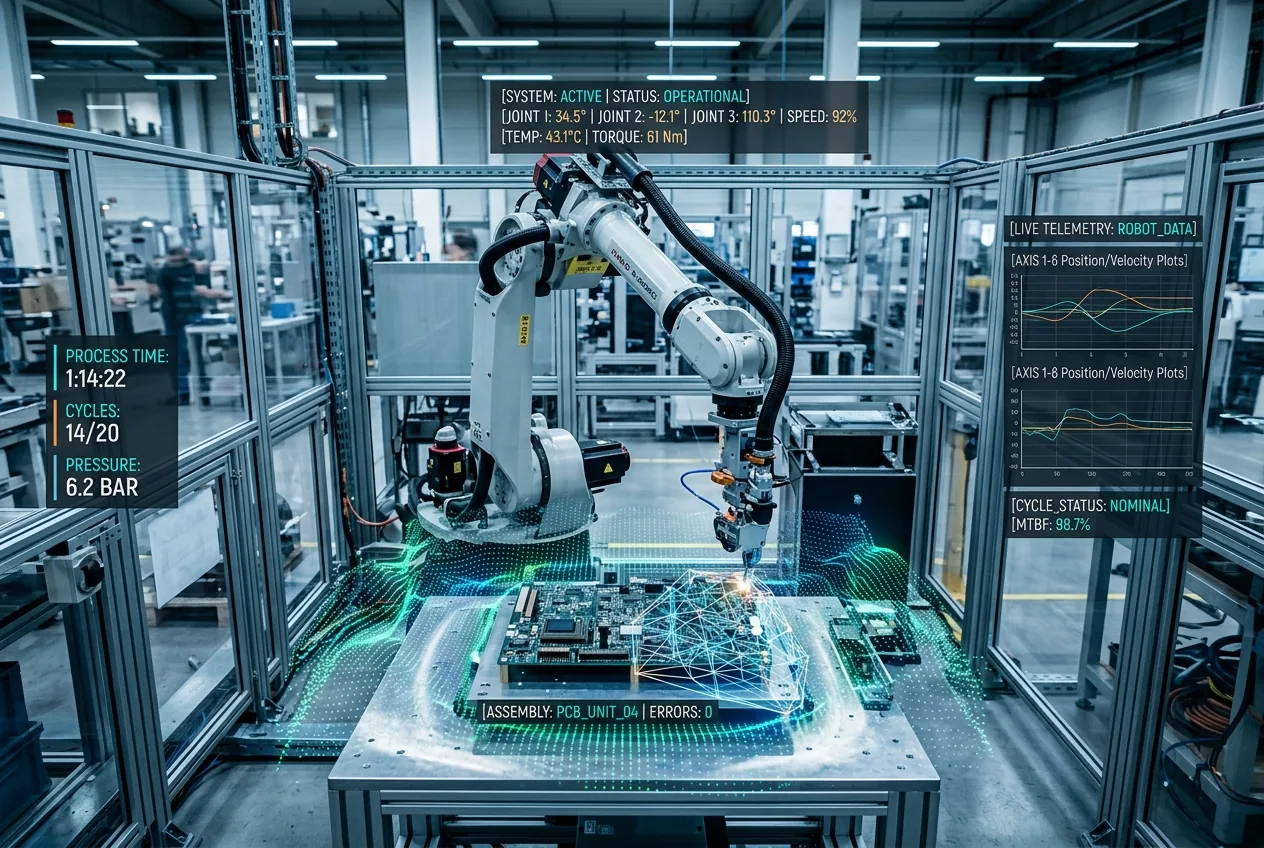
Lorsque OpenAI a présenté ses premiers modèles de texte génératif, la démonstration technologique mettait l'accent sur la fluidité conversationnelle et le mimétisme stylistique. Cependant, la sortie de son architecture GPT-5.6 de nouvelle génération dans le cadre d'une version préliminaire restreinte aux entreprises représente un pivot marqué de son objectif mécanique. Plutôt que de rechercher la nouveauté conversationnelle, cette itération se concentre sur la réduction de la latence architecturale, l'orchestration multi-agents structurée et le raisonnement spatial haute fidélité requis pour interagir avec des systèmes techniques réels. Pour les ingénieurs chargés d'intégrer des logiciels prédictifs dans des environnements industriels, les spécifications techniques de cette version préliminaire indiquent que l'intelligence artificielle fondamentale passe enfin du tableau de bord cloud à l'atelier de production.
L'annonce, diffusée via des canaux de développement ciblés et des partenaires entreprises sélectionnés, présente une famille de modèles optimisés pour une exécution déterministe. Dans les usines de fabrication, les hubs logistiques automatisés et les cellules de travail robotisées lourdes, le défaut principal des réseaux neuronaux à grande échelle antérieurs n'a jamais été un manque de connaissances générales, mais une absence d'exécution bornée et de fiabilité en temps réel. Si une ligne d'assemblage automatisée s'appuie sur un contrôleur agentique pour acheminer l'inventaire des composants ou diagnostiquer l'usure mécanique, la variance probabiliste est une responsabilité intolérable. GPT-5.6 semble avoir été conçu dès la base silicium pour répondre à cette limite, offrant un cadre où les contrôles de raisonnement symbolique et l'inférence à faible latence fonctionnent en parallèle avec les poids génératifs.
Le passage à l'échelle de l'inférence rencontre l'efficacité mécanique dense
Au cœur de l'architecture de GPT-5.6 se trouve un raffinement poussé de l'inférence hybride. Les itérations précédentes de la classe frontière forçaient les développeurs à faire un compromis peu attrayant : soit déployer des modèles denses entraînant des coûts d'inférence punitifs et une latence variable, soit se contenter de modèles de distillation légers qui échouaient fréquemment lors de l'interprétation de documentations techniques denses ou de télémétrie multivariable. GPT-5.6 comble cette lacune en découplant la planification systémique de haut niveau des boucles d'exécution rapides. Le système semble tirer parti d'une allocation dynamique des jetons (tokens), réservant le calcul approfondi au moment du test pour l'analyse architecturale systémique, tout en déléguant l'analyse déterministe routinière à des couches de routage éparses ultra-rapides.
De plus, l'empreinte mémoire requise pour la rétention du contexte a été repensée. Dans les modèles de génération précédente, les fenêtres de contexte long souffraient souvent d'un phénomène architectural connu sous le nom de « pourrissement du contexte », où les règles opérationnelles déclarées des milliers de jetons auparavant étaient silencieusement abandonnées ou remplacées. GPT-5.6 démontre un mécanisme d'attention soutenu, spécifiquement renforcé contre la dérive des instructions sur des horizons de plusieurs millions de jetons. Dans les flux de travail d'ingénierie pratiques, cela permet à l'historique de maintenance complet d'une usine, aux plans des machines et aux schémas de câblage dynamiques de rester ancrés dans la mémoire active sans éroder la précision opérationnelle du système.
Relier l'intention de haut niveau à la cinématique physique
Le saut le plus significatif visible dans la version préliminaire de GPT-5.6 est sa capacité de traduction de la télémétrie spatiale. Les ingénieurs logiciels ont longtemps lutté pour traduire les objectifs ambigus de haut niveau des opérateurs humains en systèmes de coordonnées stricts régis par des intergiciels (middleware) robotiques modernes, tels que le Robot Operating System. Historiquement, les modèles excellaient à expliquer le fonctionnement théorique d'un solveur de cinématique inverse, mais ils échouaient systématiquement lorsqu'ils devaient générer des scripts de trajectoire corrects à six degrés de liberté prenant en compte les limites de couple des articulations et la friction dynamique de la charge utile.
Dans les divulgations techniques préliminaires, GPT-5.6 présente un support direct pour les formats spatiaux natifs, traitant les nuages de points et les données de maillage volumétrique parallèlement aux images visuelles standard. Au lieu d'aplatir une cellule de machine en une image 2D, les couches vision-langage-action analysent la géométrie spatiale avec une compréhension aiguë des limites occultées et des contraintes volumétriques. Pour les robots mobiles automatisés opérant dans des centres de distribution densément encombrés, cette compréhension spatiale permet au modèle de prédire les trajectoires des piétons et des chariots élévateurs quelques secondes avant qu'elles n'intersectent les trajectoires mécaniques.
Cette capacité transforme fondamentalement les procédures de diagnostic automatisé sur les équipements immobilisés. Lorsqu'une machine à mesurer tridimensionnelle automatisée signale un écart dimensionnel sur une aube de turbine en titane moulé, un ingénieur peut alimenter directement GPT-5.6 avec les journaux d'inspection multi-axes. Plutôt que de simplement régurgiter les erreurs de tolérance courantes, le modèle remappe les variances dimensionnelles à travers la séquence cinématique de la machine CNC multi-axes qui a usiné la pièce, isolant le faux-rond de la broche ou la dilatation thermique à travers des passes d'usinage spécifiques. Il y parvient en comprenant la mécanique physique du pipeline de fabrication, et non en se contentant de prédire le mot suivant le plus probable dans un manuel d'ingénierie.
L'économie unitaire du déploiement industriel
Pour les entreprises industrielles évaluant l'adoption, la brillance technique reste secondaire par rapport au calcul fondamental de l'économie unitaire. Au cours des vingt-quatre derniers mois, l'adoption par les entreprises de l'apprentissage automatique avancé a souvent stagné au stade de la preuve de concept en raison d'une facturation imprévisible des jetons et d'un retour sur investissement ambigu. Déployer un modèle qui coûte plusieurs centimes par requête pour surveiller une opération d'assemblage qui génère des marges de fabrication extrêmement faibles est financièrement intenable.
Cette viabilité économique accélère le passage vers des déploiements hybrides localisés. Alors que l'entraînement du modèle fondamental et le raisonnement de haut niveau restent ancrés dans les centres de données cloud hyperscale, la version préliminaire introduit des ensembles d'outils dédiés pour élaguer les poids opérationnels afin de les exécuter sur des appareils d'entreprise distribués. Lorsqu'un constructeur automobile peut déployer une unité d'inférence renforcée et basse consommation directement dans une usine d'emboutissage — capable d'exécuter une surveillance de sécurité agentique de classe GPT-5.6 sans dépendance constante au cloud — le bilan financier opérationnel change complètement. Les temps d'arrêt des équipements immobilisés, qui coûtent régulièrement aux opérations de fabrication lourde des dizaines de milliers de dollars par minute, fournissent un vecteur de ROI immédiat et indéniable.
Contraintes déterministes dans les systèmes critiques
Le dernier obstacle entre l'apprentissage automatique génératif et l'automatisation industrielle a toujours été l'ingénierie de sécurité. Dans le développement logiciel, une hallucination occasionnelle produit un test unitaire échoué ou une page web brisée. Dans une installation de traitement chimique automatisée ou une cellule de fabrication de composites aérospatiaux, une chaîne de commande hallucinée peut provoquer une défaillance structurelle catastrophique, un incendie ou des blessures graves au personnel. La culture de l'ingénierie manufacturière est intrinsèquement défensive, privilégiant par-dessus tout des enveloppes opérationnelles à sécurité intégrée.
Répondant à cette réalité opérationnelle, GPT-5.6 introduit des sorties de vérification formelles, générant des limites d'exécution mathématiquement structurées parallèlement à ses réponses textuelles ou programmatiques. Le modèle peut formater nativement ses sorties en schémas fortement typés qui nécessitent une validation explicite par rapport à des machines à états critiques pour la sécurité avant que tout contrôleur matériel n'agisse sur les instructions. Si le modèle propose une vitesse d'avance modifiée pour un tour industriel, la sortie est accompagnée d'une enveloppe de paramètres déterministes bornée par des limites de sécurité absolues codées en dur dans le contrôleur d'exécution local.
Cette encapsulation structurelle stricte découple le raisonnement exploratoire du modèle de la couche de contrôle direct. Le réseau neuronal n'agit pas comme l'actionneur physique ultime, mais comme une intelligence de supervision avancée opérant dans des contraintes industrielles strictes. Alors que la version préliminaire s'étend à une cohorte plus large de fournisseurs d'automatisation et de fabricants de matériel tout au long du trimestre, la trajectoire est indubitable. OpenAI déplace son attention des assistants logiciels génériques vers le domaine rigoureux et à enjeux élevés des opérations industrielles, où la valeur de l'intelligence ne se mesure pas à la conviction de ses paroles, mais à la fiabilité de ses réalisations.



Comments
No comments yet. Be the first!