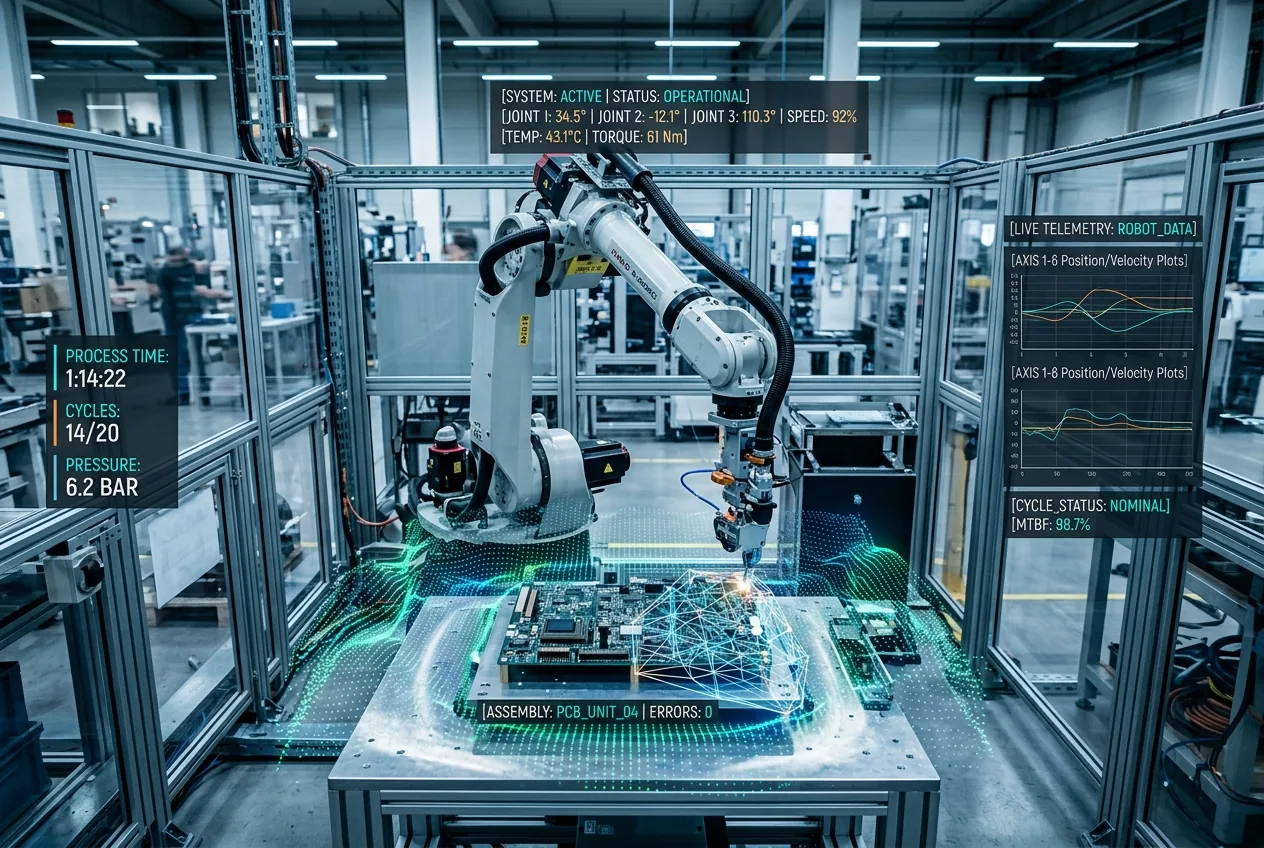
Als OpenAI seine ersten generativen Textmodelle vorstellte, konzentrierte sich die technologische Demonstration auf sprachliche Gewandtheit und stilistische Nachahmung. Die Veröffentlichung seiner GPT-5.6-Architektur der nächsten Generation im Rahmen einer eingeschränkten Enterprise-Vorschau stellt jedoch eine deutliche Neuausrichtung des mechanischen Ziels dar. Anstatt nach sprachlicher Neuheit zu streben, konzentriert sich diese Iteration auf die Verringerung architektonischer Latenzzeiten, die strukturierte Orchestrierung von Multi-Agenten-Systemen und das hochpräzise räumliche Denken, das für die Schnittstelle zu technischen Systemen in der realen Welt erforderlich ist. Für Ingenieure, die mit der Integration prädiktiver Software in industrielle Umgebungen betraut sind, deuten die technischen Spezifikationen hinter dieser Vorschau darauf hin, dass sich die grundlegende künstliche Intelligenz endlich vom Cloud-Dashboard in die Werkshalle bewegt.
Die Ankündigung, die über gezielte Entwicklerkanäle und ausgewählte Unternehmenspartner erfolgte, skizziert eine Modellfamilie, die für deterministische Ausführung optimiert ist. In Fertigungsanlagen, automatisierten Logistikzentren und komplexen Roboterarbeitszellen war der Hauptfehler früherer neuronaler Netze nie ein Mangel an umfassendem Wissen, sondern ein Fehlen von begrenzter Ausführung und Echtzeit-Zuverlässigkeit. Wenn eine automatisierte Montagelinie auf einen agentenbasierten Controller angewiesen ist, um den Bestand an Komponenten zu lenken oder mechanischen Verschleiß zu diagnostizieren, ist probabilistische Varianz ein unerträgliches Risiko. GPT-5.6 scheint von Grund auf darauf ausgelegt zu sein, diese Grenze zu überwinden, indem es ein Framework bietet, in dem symbolische Schlussfolgerungen und Latenz-optimierte Inferenz parallel zu den generativen Gewichten laufen.
Inferenz-Skalierung trifft auf dichte mechanische Effizienz
Im architektonischen Kern von GPT-5.6 liegt eine aggressive Verfeinerung der hybriden Inferenz-Rechenleistung. Frühere Iterationen in der Frontier-Klasse zwangen Entwickler zu einem unangenehmen Kompromiss: Entweder setzten sie dichte Modelle ein, die hohe Inferenzkosten und variable Latenzzeiten verursachten, oder sie entschieden sich für leichtgewichtige Destillationsmodelle, die bei der Interpretation dichter technischer Dokumentationen oder Telemetriedaten mit mehreren Variablen häufig versagten. GPT-5.6 überbrückt diese Lücke durch die Entkopplung der systemischen Planung höherer Ordnung von schnellen Ausführungsschleifen. Das System scheint eine dynamische Token-Zuweisung zu nutzen, wobei tiefgehende Rechenleistung während der Testzeit für systemische Architekturanalysen reserviert wird, während routinemäßiges deterministisches Parsing auf ultraschnelle, spärliche Routing-Layer ausgelagert wird.
Darüber hinaus wurde der für die Kontextspeicherung erforderliche Speicherbedarf überarbeitet. Bei Frontier-Modellen der vorherigen Generation litten Fenster mit langem Kontext oft unter einem architektonischen Phänomen, das als Kontext-Degradierung bekannt ist, bei dem betriebliche Regeln, die tausende Token zuvor deklariert wurden, stillschweigend verworfen oder überschrieben wurden. GPT-5.6 demonstriert einen dauerhaften Aufmerksamkeitsmechanismus, der speziell gegen Instruktionsdrift über anhaltende Horizonte von Millionen von Token gehärtet ist. In praktischen Engineering-Workflows ermöglicht dies, dass die gesamte Wartungshistorie einer Anlage, Maschinenpläne und dynamische Schaltpläne im Arbeitsspeicher bleiben, ohne die operative Präzision des Systems zu beeinträchtigen.
Überbrückung von hoher Absicht und physikalischer Kinematik
Der folgenschwerste Sprung in der GPT-5.6-Vorschau ist die Fähigkeit zur räumlichen Telemetrie-Übersetzung. Softwareentwickler haben lange damit gerungen, die vagen, hochrangigen Ziele menschlicher Bediener in die strengen Koordinatensysteme zu übersetzen, die von moderner Robotik-Middleware wie dem Robot Operating System gesteuert werden. Historisch gesehen zeichneten sich Modelle dadurch aus, dass sie erklärten, wie ein Algorithmus für inverse Kinematik theoretisch funktioniert, versagten aber routinemäßig, wenn sie korrekte Trajektorienskripte mit sechs Freiheitsgraden generieren sollten, die Gelenkmomentgrenzen und dynamische Reibung der Nutzlast berücksichtigten.
In vorläufigen technischen Offenlegungen zeigt GPT-5.6 direkte Unterstützung für native räumliche Formate, wobei Punktwolken und volumetrische Mesh-Daten neben Standard-Bildrahmen verarbeitet werden. Anstatt eine Maschinenzelle in ein 2D-Bild zu reduzieren, analysieren die Vision-Language-Action-Layer die räumliche Geometrie mit einem ausgeprägten Verständnis für verdeckte Grenzen und volumetrische Einschränkungen. Für automatisierte mobile Roboter, die in eng bepackten Verteilzentren arbeiten, ermöglicht dieses räumliche Verständnis dem Modell, die Trajektorien von Fußgängern und Gabelstaplern Sekunden vor einer Kreuzung mit mechanischen Pfaden vorherzusagen.
Diese Fähigkeit verändert grundlegend die automatisierten Diagnoseverfahren bei Investitionsgütern. Wenn eine automatisierte Koordinatenmessmaschine eine dimensionale Abweichung an einer gegossenen Turbinenschaufel aus Titan feststellt, kann ein Ingenieur die mehrachsigen Inspektionsprotokolle direkt in GPT-5.6 einspeisen. Anstatt nur allgemeine Toleranzfehler wiederzugeben, ordnet das Modell die dimensionalen Abweichungen der kinematischen Sequenz der mehrachsigen CNC-Maschine zu, die das Teil gefräst hat, und isoliert Spindelrundlauffehler oder thermische Ausdehnung über spezifische Bearbeitungsdurchgänge hinweg. Es erreicht dies durch das Verständnis der physikalischen Mechanik der Fertigungspipeline, anstatt nur das nächste wahrscheinliche Wort in einem technischen Handbuch vorherzusagen.
Die Stückökonomie des industriellen Einsatzes
Für Industrieunternehmen, die eine Einführung bewerten, bleibt technische Brillanz zweitrangig gegenüber dem grundlegenden Kalkül der Stückökonomie. In den letzten vierundzwanzig Monaten ist die Einführung fortgeschrittener maschineller Lernverfahren in Unternehmen oft im Stadium des Proof-of-Concept steckengeblieben, da unvorhersehbar hohe Token-Abrechnungen und ein unklarer Return on Investment vorlagen. Der Einsatz eines Modells, das pro Abfrage mehrere Cent kostet, um einen Montagevorgang mit hauchdünnen Fertigungsmargen zu überwachen, ist finanziell nicht tragbar.
Diese wirtschaftliche Rentabilität beschleunigt den Wandel hin zu lokalisierten hybriden Einsätzen. Während das grundlegende Modelltraining und die logischen Schlussfolgerungen höherer Ordnung in Hyperscale-Cloud-Rechenzentren verankert bleiben, führt die Vorschau dedizierte Toolsets ein, um operative Gewichte für den Betrieb auf verteilten Unternehmensgeräten zu optimieren. Wenn ein Automobilhersteller eine gehärtete Inferenz-Box mit geringem Stromverbrauch direkt in einem automatisierten Presswerk einsetzen kann – die in der Lage ist, agentenbasierte Sicherheitsüberwachung der GPT-5.6-Klasse ohne ständige Uplink-Abhängigkeit auszuführen –, ändert sich die operative Bilanz vollständig. Ausfallzeiten von Investitionsgütern, die in der Schwerindustrie routinemäßig Zehntausende von Dollar pro Minute kosten, bieten einen sofortigen und unbestreitbaren ROI-Vektor.
Deterministische Einschränkungen in unternehmenskritischen Systemen
Die letzte Hürde zwischen generativem maschinellem Lernen und industrieller Automatisierung war schon immer die Sicherheitstechnik. In der Softwareentwicklung führt eine gelegentliche Halluzination zu einem fehlgeschlagenen Unit-Test oder einer defekten Webseite. In einer automatisierten chemischen Verarbeitungsanlage oder einer Fertigungszelle für Luft- und Raumfahrt-Verbundwerkstoffe kann ein halluzinierter Befehlsstrang katastrophale strukturelle Ausfälle, Feuer oder schwere Personenschäden verursachen. Die Kultur des Fertigungsingenieurwesens ist von Natur aus defensiv und priorisiert ausfallsichere Betriebsumgebungen über alles andere.
Um dieser operativen Realität gerecht zu werden, führt GPT-5.6 formale Verifizierungsausgaben ein, die mathematisch strukturierte Ausführungsgrenzen neben den textuellen oder programmatischen Antworten generieren. Das Modell kann seine Ausgaben nativ in streng typisierte Schemata formatieren, die eine explizite Validierung gegenüber sicherheitskritischen Zustandsmaschinen erfordern, bevor irgendein Hardware-Controller die Anweisungen ausführt. Wenn das Modell eine geänderte Vorschubgeschwindigkeit für eine Industriedrehmaschine vorschlägt, wird die Ausgabe von einem deterministischen Parameterumschlag begleitet, der durch absolute Sicherheitsgrenzen begrenzt ist, die im lokalen Laufzeit-Controller fest kodiert sind.
Diese strenge strukturelle Kapselung entkoppelt die explorative Logik des Modells von der direkten Steuerungsebene. Das neuronale Netz agiert nicht als ultimativer physikalischer Aktor, sondern als fortschrittliche überwachende Intelligenz, die innerhalb strenger industrieller Grenzen operiert. Während sich die Vorschau im Laufe des Quartals auf einen breiteren Kreis von Automatisierungsanbietern und Hardwareherstellern ausweitet, ist die Entwicklung unverkennbar. OpenAI verlagert seinen Fokus weg von generischen Software-Assistenten hin zum risikoreichen, strengen Bereich industrieller Abläufe, in dem der Wert von Intelligenz nicht daran gemessen wird, wie überzeugend sie spricht, sondern wie zuverlässig sie produziert.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!