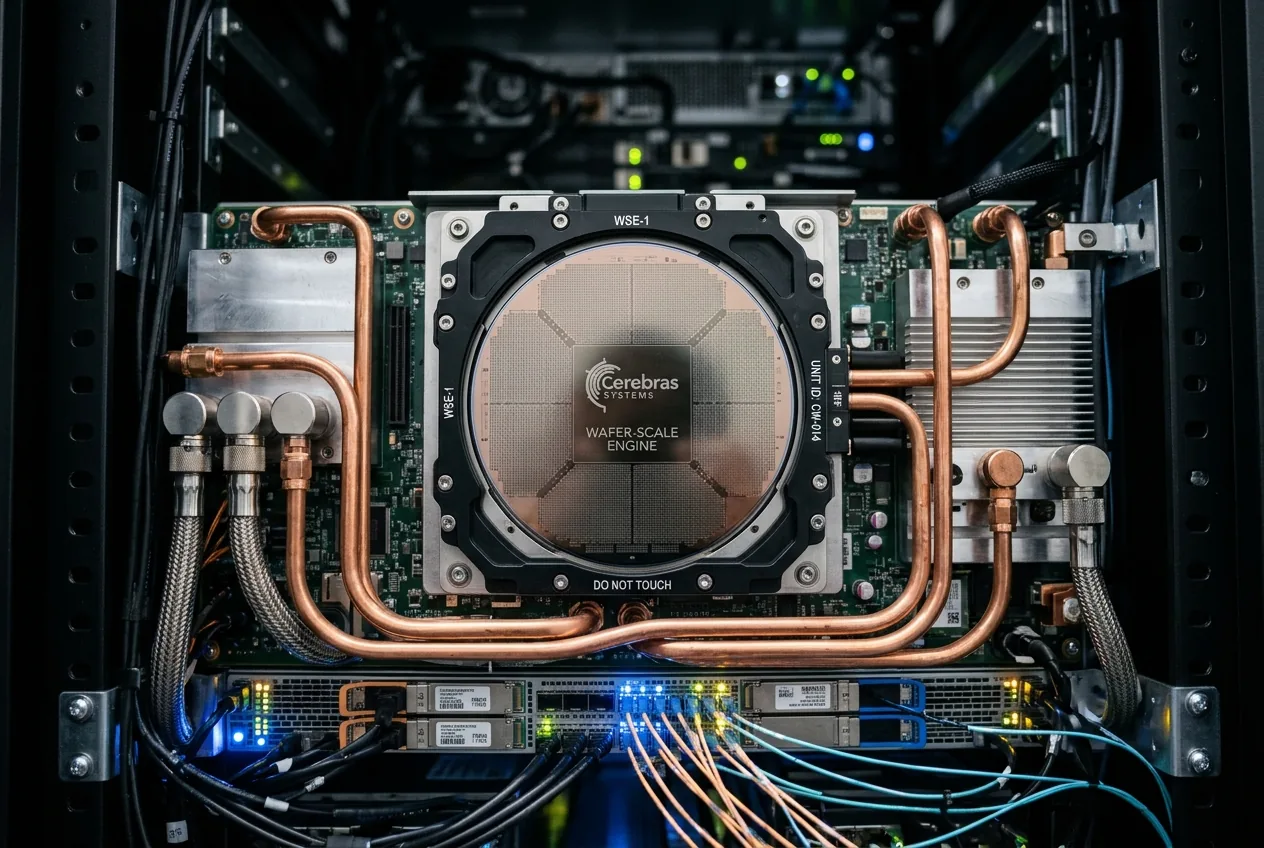
La fisica dietro il collo di bottiglia della memoria
Per comprendere perché 750 token al secondo siano un traguardo importante, bisogna analizzare i limiti di instradamento fisico dei tradizionali cluster di GPU. Quando si esegue l'inferenza su un modello di frontiera attraverso cluster di schede acceleratrici standard, i core di calcolo sprecano numerosi cicli di clock in attesa del trasferimento dei parametri. La larghezza di banda della memoria tra gli stack di High Bandwidth Memory e il die del processore agisce come un collo di bottiglia elettrico. Durante la generazione, in cui i token vengono prodotti sequenzialmente uno alla volta, le dimensioni dei batch vengono spesso limitate per mantenere una latenza utente inferiore al secondo, riducendo l'efficienza di calcolo complessiva.
Poiché i parametri fisici di un modello di frontiera superano la capacità SRAM di un singolo wafer, Cerebras collega più motori utilizzando interconnessioni dedicate a bassa latenza, creando un fabric unificato in cui i layer si estendono attraverso i wafer di silicio. Le penalità di latenza che affliggono i cluster GPU distribuiti su reti InfiniBand sono drasticamente attenuate. I core di calcolo vengono alimentati continuamente senza carenze nella pipeline, traducendosi direttamente nel throughput di output 14 volte superiore osservato nei primi benchmark.
Realtà dei benchmark e compressione del tempo
Le metriche di throughput soffrono spesso di un'inflazione sintetica dovuta al marketing, ma le implicazioni pratiche di una pipeline da 750 token al secondo diventano evidenti quando applicate a compiti di ragionamento iterativo profondo. I sistemi deliberativi a catena lunga — in cui un modello IA esplora molteplici percorsi ipotetici, esegue strumenti di codice esterni e valuta prove interne prima di emettere una risposta definitiva — generano decine di migliaia di token nascosti per ogni paragrafo di output finale.
Si consideri la valutazione comparativa di Cerebras utilizzando la suite di benchmark Humanity’s Last Exam, una raccolta di 2.500 sfide di ragionamento multidisciplinare progettate per portare i modelli di frontiera all'esaurimento computazionale. Eseguito su cluster di acceleratori standard, Claude Fable 5 di Anthropic ha richiesto 78 ore e 27 minuti di calcolo continuo per elaborare l'intero set di dati del benchmark. L'esecuzione di GPT-5.6 Sol sulla pipeline Ultrafast alimentata da Cerebras ha completato la stessa suite da 2.500 domande in 11 ore e 11 minuti. Comprimere tre giorni interi di esecuzione in un'operazione notturna trasforma la verifica in più fasi da un lavoro batch asincrono a un'operazione che può essere integrata negli sprint ingegneristici attivi.
Questo moltiplicatore di velocità cambia completamente l'economia dei cicli di esecuzione del software. Quando un ambiente di sviluppo automatizzato può redigere, compilare, eseguire suite di test e riscrivere complessi codici di sistemi embedded in secondi anziché minuti, il debug passa da uno stato di attesa passiva a un dialogo interattivo tra l'ingegnere umano e la sintesi della macchina.
Evoluzione hardware: dal CS-3 al CS-4 su scala rack
La validazione ingegneristica alla base di Ultrafast si basa su rapide iterazioni del packaging dei server personalizzati di Cerebras. Il livello di implementazione ha inizialmente sfruttato il sistema CS-3, ma Cerebras ha già mostrato il suo successore, il CS-4, costruito sulla sua architettura proprietaria di rack Nexus. Integrando tre processori Wafer-Scale Engine in un telaio rack, il CS-4 raddoppia il throughput di generazione dei token rispetto alle generazioni precedenti e si prevede che supererà i 1.000 token al secondo su modelli con oltre diecimila miliardi di parametri.
Le prime affermazioni sulle prestazioni che circolano negli ambienti hardware suggeriscono che configurazioni sperimentali di GPT-5.6 Sol su hardware CS-4 abbiano raggiunto circa 1.300 token al secondo. Sebbene non verificate in test di laboratorio indipendenti, tali cifre riflettono l'enorme margine teorico derivante dal mantenere i pesi del modello interamente incorporati nei registri SRAM ad alta velocità. La sfida fisica passa dai ritardi di propagazione elettrica all'interno del silicio alla gestione termodinamica, che richiede complessi collettori di raffreddamento a liquido per dissipare decine di kilowatt per unità rack mantenendo un rigoroso equilibrio termico.
Per gli architetti di sistemi aziendali, questa divergenza hardware introduce scelte critiche nella catena di approvvigionamento. I cluster GPU standard rimangono asset altamente fungibili, in grado di alternarsi tra pre-addestramento grezzo del modello, generazione di dati sintetici e inferenza batch parallela. Un rack su scala wafer, al contrario, è uno strumento ultra-specializzato progettato specificamente per l'inferenza limitata dalla memoria e a basso batch. L'implementazione di questi sistemi richiede spazio dedicato, distribuzione energetica su misura e una stretta integrazione con middleware di orchestrazione proprietari.
Il paradosso dei prezzi e la fattibilità della produzione
Nonostante il trionfo tecnico di generare 750 token al secondo, le realtà commerciali introducono attriti. Agli eventi DevDay di OpenAI, l'azienda ha lanciato ufficialmente la struttura dei prezzi Ultrafast per il suo nuovo modello GPT-6 Astra, fatturandolo a sei volte il costo dell'inferenza base — fissando nello specifico le tariffe a sessanta dollari per milione di token di input e trecento dollari per milione di token di output. La funzionalità è stata anche inclusa nei livelli premium come il piano ChatGPT Pro da cinquecento dollari al mese.
Tuttavia, GPT-5.6 Sol Ultrafast rimane curiosamente bloccato. Il modello sottostante è diventato in realtà significativamente più economico, scendendo a quattro dollari per milione di token di input e venti dollari per milione di token di output con le promozioni infrastrutturali standard. Ma la sua variante Ultrafast non ha un listino prezzi pubblico, né una tempistica di accesso generale, ed è limitata alla negoziazione diretta di account aziendali. Ciò crea un paradosso ingegneristico: il modello di punta progettato per dimostrare la fattibilità dell'esecuzione in tempo reale su scala wafer non può essere inserito nel budget da team di sviluppo indipendenti.
La discrepanza evidenzia l'ingente spesa in conto capitale necessaria per servire i modelli a queste frequenze. Sebbene il silicio su scala wafer elimini i ritardi di trasporto della memoria esterna, i rendimenti di produzione su interi wafer rimangono intrinsecamente bassi rispetto ai chip di piccole dimensioni, e i guasti tra i core funzionali richiedono sofisticati instradamenti dei circuiti ridondanti. Il costo per fornire, raffreddare e gestire array multi-wafer per il traffico interattivo in tempo reale rimane straordinariamente alto per singolo thread utente attivo, probabilmente scoraggiando OpenAI dall'aprire un accesso illimitato senza una rigorosa protezione dei margini.
Implicazioni per la robotica e i loop di feedback industriali
Dove potrebbe una tecnologia con rapporti costo-velocità così asimmetrici giustificare i suoi oneri operativi? La risposta non risiede nei chatbot web, ma al confine fisico in cui i sistemi software comandano attuatori fisici: robotica di fascia alta, instradamento automatizzato della catena di approvvigionamento e gestione delle infrastrutture autonome.
I loop di controllo robotici tradizionali operano su cicli di millisecondi, mentre i sistemi cognitivi profondi impiegano secondi per analizzare la telemetria della scena e costruire traiettorie d'azione. Questa disconnessione temporale costringe gli ingegneri industriali a fare affidamento su piccoli modelli localizzati di visione-linguaggio-azione che mancano di un ragionamento causale completo. Se un'anomalia imprevista colpisce una catena di montaggio automatizzata — come una staffa distorta o uno slittamento del nastro trasportatore non indicizzato — i piccoli modelli locali falliscono spesso perché non possono ragionare sulla fisica inedita al volo.
Un livello di inferenza che corre a 750 token al secondo colma questo divario operativo. Un modello di frontiera operante a questa velocità può digerire molteplici input sensoriali multimodali ad alta risoluzione, eseguire dozzine di piani cinematici simulati, identificare casi limite di sicurezza ed emettere correzioni concrete della coppia giuntale entro centinaia di millisecondi. Nelle catene di approvvigionamento industriali e nella produzione di precisione, dove i tempi di inattività imprevisti causano perdite che si misurano in decine di migliaia di dollari al minuto, pagare un premio per milione di token rappresenta una spesa operativa irrilevante.
In definitiva, l'anteprima Ultrafast di OpenAI è una prova ingegneristica fondamentale. Conferma che il "muro della memoria" non è un limite immutabile per l'intelligenza artificiale, ma un attrito meccanico che può essere superato alterando la topologia hardware. Finché l'economia di produzione del silicio su scala wafer non raggiungerà la parità con il packaging dei microchip maturi, tuttavia, il ragionamento di frontiera in tempo reale rimarrà un lusso industriale d'élite piuttosto che un'utility diffusa.



Comments
No comments yet. Be the first!