Die Physik hinter dem Speicherengpass
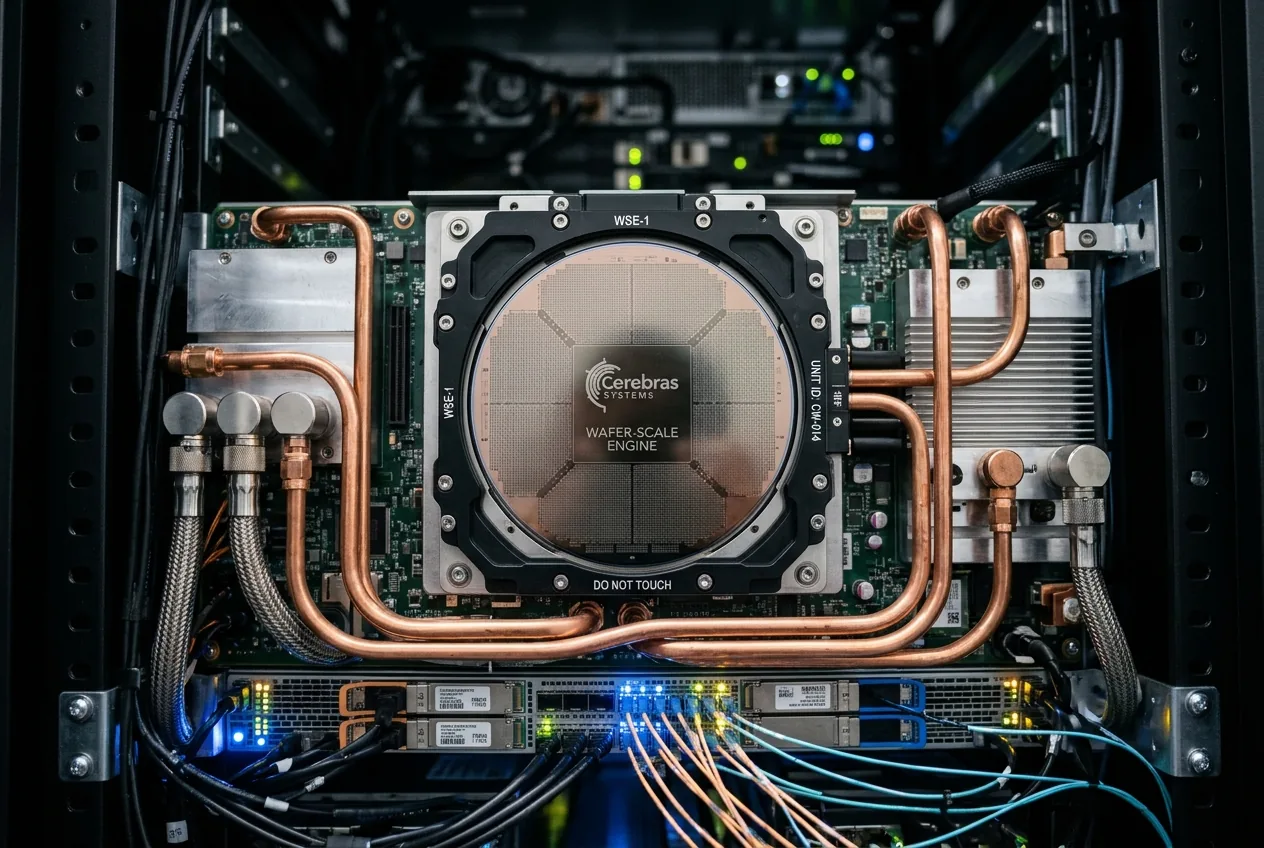
Um zu verstehen, warum 750 Tokens pro Sekunde von Bedeutung sind, muss man die physischen Routing-Beschränkungen traditioneller GPU-Cluster analysieren. Bei der Durchführung von Inferenzvorgängen mit einem Spitzenmodell über Cluster aus Standard-Beschleunigerkarten hinweg verbringen Rechenkerne einen erheblichen Teil ihrer Taktzyklen im Leerlauf, während sie auf Parametertransfers warten. Die Speicherbandbreite zwischen den HBM-Stacks (High Bandwidth Memory) und dem Prozessor-Die fungiert dabei als elektrischer Flaschenhals. Während der Generierung, bei der Tokens nacheinander einzeln erzeugt werden, werden Batch-Größen oft gedrosselt, um eine Latenzzeit von unter einer Sekunde für den Benutzer aufrechtzuerhalten, was die allgemeine Recheneffizienz verringert.
Da die physischen Parameter eines Spitzenmodells die SRAM-Kapazität eines einzelnen Wafers übersteigen, verbindet Cerebras mehrere Engines über dedizierte Interconnects mit niedriger Latenz. So entsteht eine einheitliche Struktur, in der sich die Schichten über Silizium-Wafer erstrecken. Die Latenzstrafen, die verteilte GPU-Cluster über InfiniBand-Netzwerke belasten, werden drastisch abgeschwächt. Rechenkerne werden kontinuierlich ohne Pipeline-Unterbrechungen versorgt, was sich direkt in dem 14-fachen Durchsatz niederschlägt, der in frühen Benchmarks beobachtet wurde.
Benchmark-Realitäten und die Kompression der Zeit
Durchsatzmetriken leiden oft unter einer künstlichen Marketing-Aufblähung, doch die praktischen Auswirkungen einer Pipeline mit 750 Tokens pro Sekunde werden deutlich, wenn sie auf tiefgreifende iterative Schlussfolgerungsaufgaben angewendet werden. Langkettige deliberative Systeme – bei denen ein KI-Modell mehrere hypothetische Pfade erforscht, externe Code-Tools ausführt und interne Beweise bewertet, bevor eine endgültige Antwort ausgegeben wird – generieren zehntausende versteckte Tokens für jeden ausgegebenen Absatz.
Betrachtet man den Vergleichstest von Cerebras unter Verwendung der Benchmark-Suite „Humanity’s Last Exam“, einer Sammlung von 2.500 multidisziplinären Schlussfolgerungsaufgaben, die darauf ausgelegt sind, Spitzenmodelle an ihre rechnerische Erschöpfungsgrenze zu bringen: Auf Standard-Beschleunigerclustern benötigte Anthropic’s Claude Fable 5 insgesamt 78 Stunden und 27 Minuten kontinuierliche Rechenzeit, um den gesamten Benchmark-Datensatz zu verarbeiten. Das Ausführen von GPT-5.6 Sol auf der Cerebras-gestützten Ultrafast-Pipeline bewältigte dieselbe 2.500-Fragen-Suite in 11 Stunden und 11 Minuten. Die Komprimierung von drei vollen Ausführungstagen auf einen Lauf über Nacht verwandelt die mehrstufige Verifizierung von einem asynchronen Batch-Job in einen Vorgang, der sich in aktive Engineering-Sprints integrieren lässt.
Dieser Geschwindigkeitsmultiplikator verändert die Wirtschaftlichkeit von Software-Ausführungsschleifen grundlegend. Wenn eine automatisierte Entwicklungsumgebung komplexe Embedded-System-Codes in Sekunden statt in Minuten entwerfen, kompilieren, testen und umschreiben kann, verschiebt sich das Debugging von einem passiven Wartezustand hin zu einem interaktiven Dialog zwischen dem menschlichen Ingenieur und der maschinellen Synthese.
Hardware-Evolution von CS-3 zu Rack-Scale CS-4
Die technische Validierung hinter Ultrafast basiert auf schnellen Iterationen der kundenspezifischen Server-Verpackung von Cerebras. Die Bereitstellungsebene nutzte ursprünglich das CS-3-System, doch Cerebras hat bereits den Nachfolger, das CS-4, vorgestellt, das auf der proprietären Nexus-Rack-Architektur basiert. Durch das Packen von drei einzelnen Wafer-Scale-Engine-Prozessoren in einen integrierten Rack-Rahmen verdoppelt das CS-4 den Token-Generierungsdurchsatz im Vergleich zu früheren Generationen und soll bei Modellen mit über zehn Billionen Parametern mehr als 1.000 Tokens pro Sekunde liefern.
Erste Leistungsbehauptungen, die in Hardware-Kreisen kursieren, deuten darauf hin, dass experimentelle Konfigurationen von GPT-5.6 Sol auf der CS-4-Hardware etwa 1.300 Tokens pro Sekunde erreicht haben. Obwohl dies in unabhängigen Labortests nicht verifiziert wurde, spiegeln solche Zahlen den schieren theoretischen Spielraum wider, der entsteht, wenn die Modellgewichte vollständig in Hochgeschwindigkeits-SRAM-Registern eingebettet bleiben. Die physikalische Herausforderung verlagert sich von elektrischen Ausbreitungsverzögerungen innerhalb des Siliziums hin zum thermodynamischen Management, was komplexe Flüssigkeitskühlsysteme erfordert, um zehntausende Watt pro Rack-Einheit abzuführen und gleichzeitig ein strenges thermisches Gleichgewicht aufrechtzuerhalten.
Für Unternehmenssystemarchitekten bringt diese Hardware-Divergenz kritische Entscheidungen in der Lieferkette mit sich. Standard-GPU-Cluster bleiben tiefgreifend austauschbare Anlagen, die zwischen rohem Modell-Pre-Training, synthetischer Datengenerierung und paralleler Batch-Inferenz wechseln können. Ein Wafer-Scale-Rack hingegen ist ein spezialisiertes Instrument, das speziell für speichergebundene Low-Batch-Inferenz entwickelt wurde. Der Einsatz dieser Systeme erfordert dedizierte Bodenflächen, eine maßgeschneiderte Stromverteilung und eine enge Integration mit proprietärer Orchestrierungs-Middleware.
Das Preistoxon und die Produktionsfähigkeit
Trotz des technischen Triumphs, dreiviertel eines Tausends von Tokens pro Sekunde zu generieren, führen kommerzielle Realitäten zu Reibungsverlusten. Auf den DevDay-Veranstaltungen von OpenAI startete das Unternehmen offiziell die Ultrafast-Preisstruktur für sein neueres Modell GPT-6 Astra und berechnete diese mit dem Sechsfachen der Basis-Inferenzkosten – konkret wurden Raten von sechzig Dollar pro Million Input-Tokens und dreihundert Dollar pro Million Output-Tokens festgelegt. Das Feature wurde zudem in Premium-Tarife wie den 500-Dollar-Monatsplan ChatGPT Pro gebündelt.
Doch GPT-5.6 Sol Ultrafast bleibt merkwürdigerweise außen vor. Das zugrunde liegende Modell ist tatsächlich deutlich günstiger geworden und fiel im Rahmen von Standard-Infrastruktur-Aktionen auf vier Dollar pro Million Input-Tokens und zwanzig Dollar pro Million Output-Tokens. Die Ultrafast-Variante verfügt jedoch über keine öffentliche Preisliste, keinen allgemeinen Zeitplan für den Zugang und ist hinter direkten Verhandlungen mit Firmenkonten versteckt. Dies schafft ein technisches Paradoxon: Das Flaggschiffmodell, das entwickelt wurde, um die Realisierbarkeit der Wafer-Scale-Echtzeitausführung zu beweisen, kann von unabhängigen Entwicklungsteams nicht budgetiert werden.
Die Diskrepanz verdeutlicht die massiven Investitionsausgaben, die erforderlich sind, um Modelle mit diesen Frequenzen zu bedienen. Während Wafer-Scale-Silizium externe Speicherübertragungsverzögerungen eliminiert, bleiben die Fertigungsausbeuten ganzer Wafer im Vergleich zu kleinen Chips von Natur aus gering, und Ausfälle bei funktionalen Kernen erfordern ein ausgeklügeltes redundantes Schaltungs-Routing. Die Kosten für die Bereitstellung, Kühlung und den Betrieb von Multi-Wafer-Arrays für interaktiven Echtzeitverkehr bleiben pro aktivem Benutzer-Thread außerordentlich hoch, was OpenAI wahrscheinlich davon abhält, einen uneingeschränkten Zugang ohne strikte Margensicherung zu ermöglichen.
Implikationen für Robotik und industrielle Feedbackschleifen
Wo könnte eine Technologie mit einem derart asymmetrischen Verhältnis von Kosten zu Geschwindigkeit ihren operativen Mehraufwand rechtfertigen? Die Antwort liegt nicht bei Web-Chatbots, sondern an der physikalischen Grenze, an der Softwaresysteme physische Aktuatoren steuern: High-End-Robotik, automatisiertes Supply-Chain-Routing und autonomes Infrastrukturmanagement.
Traditionelle Robotersteuerungsschleifen arbeiten im Millisekundenbereich, während tiefe kognitive Systeme Sekunden benötigen, um Szenentelemetrie zu parsen und Aktionspfade zu konstruieren. Diese zeitliche Entkopplung zwingt Industrieingenieure dazu, sich auf kleine, lokalisierte Vision-Language-Action-Modelle zu verlassen, denen es an umfassender kausaler Schlussfolgerung mangelt. Wenn eine unerwartete Anomalie eine automatisierte Montagelinie trifft – wie eine verzogene Halterung oder ein nicht indizierter Förderbandfehler –, scheitern kleine lokale Modelle häufig, weil sie neuartige physikalische Gegebenheiten nicht spontan durchschauen können.
Eine Inferenzebene, die mit 750 Tokens pro Sekunde arbeitet, schließt diese operative Lücke. Ein Spitzenmodell, das mit dieser Geschwindigkeit operiert, kann mehrere hochauflösende multimodale Sensoreingaben verarbeiten, Dutzende von vorwärts simulierten kinematischen Plänen ausführen, Sicherheitsrisiken identifizieren und konkrete Gelenkmomentkorrekturen innerhalb von Hunderten von Millisekunden ausgeben. In industriellen Lieferketten und der Präzisionsfertigung, wo ungeplante Stillstandszeiten Verluste in Höhe von zehntausenden Dollar pro Minute verursachen, stellen die höheren Kosten pro Million Tokens eine unerhebliche betriebliche Ausgabe dar.
Letztendlich ist die Ultrafast-Vorschau von OpenAI ein grundlegender technischer Beweis. Sie bestätigt, dass die Memory Wall keine unveränderliche Obergrenze für künstliche Intelligenz ist, sondern eine mechanische Reibung, die durch die Änderung der Hardware-Topologie überwunden werden kann. Bis die Fertigungsökonomie von Wafer-Scale-Silizium jedoch die Parität mit ausgereiften Mikrochip-Verpackungsmethoden erreicht, wird die Echtzeit-Spitzenmodell-Schlussfolgerung ein exklusiver industrieller Luxus bleiben und kein alltäglicher Nutzwert.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!