内存瓶颈背后的物理学原理
要理解为何每秒 750 个 token 至关重要,就必须剖析传统 GPU 集群的物理路由限制。当在标准加速器卡集群上运行前沿模型的推理任务时,计算核心会花费大量空闲时钟周期等待参数传输。高带宽内存(HBM)堆栈与处理器芯片之间的内存带宽充当了电气瓶颈。在生成过程中,由于 token 是逐个顺序产生的,为了维持亚秒级的用户延迟,批处理大小往往会受到抑制,从而降低了整体计算效率。
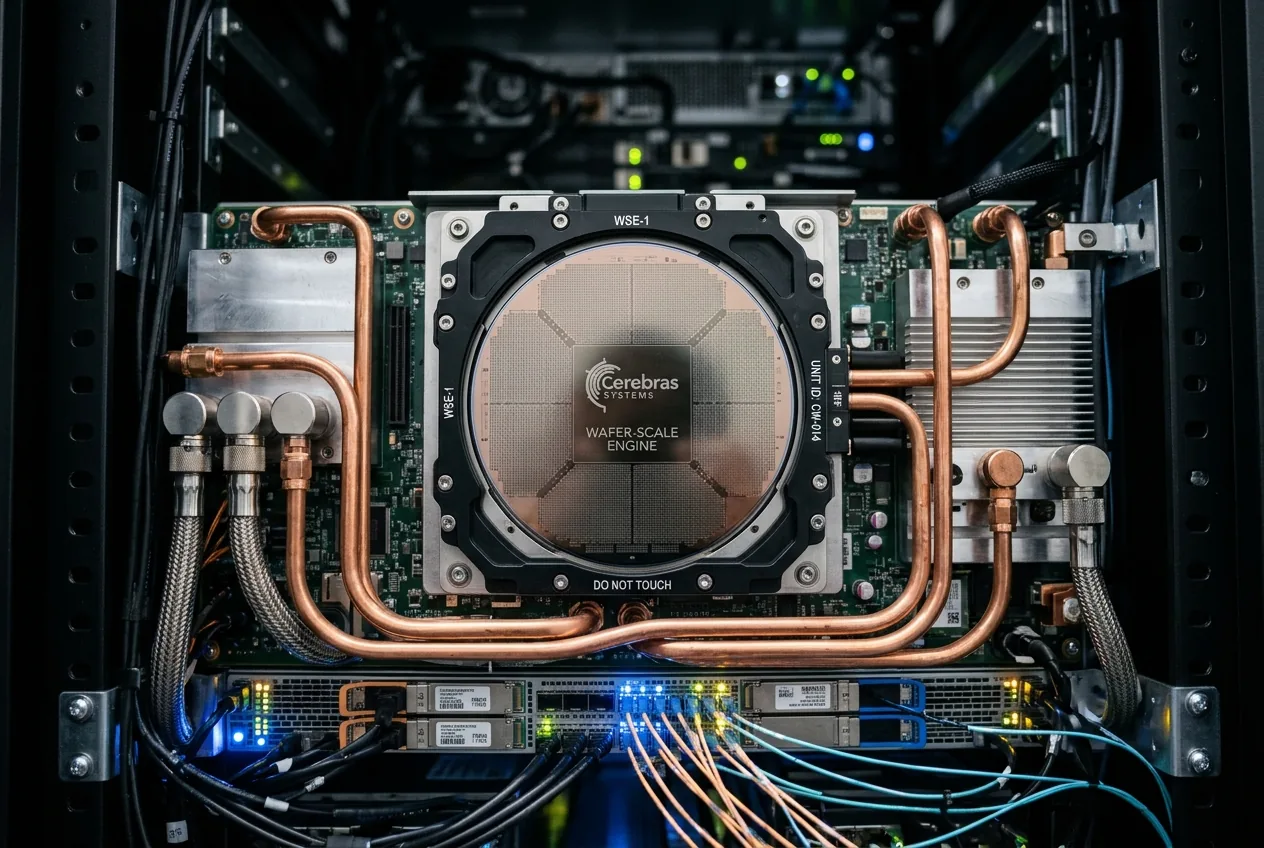
由于前沿模型的物理参数超出了单片晶圆的 SRAM 容量,Cerebras 使用专用的低延迟互联技术将多个引擎连接起来,创建了一个层级跨越硅晶圆的统一架构。这极大地减轻了分布式 GPU 集群在 InfiniBand 网络上所受的延迟惩罚。计算核心得以持续供能,避免了流水线停顿,这直接转化为早期基准测试中所观察到的 14 倍输出吞吐量。
基准测试的现实与时间的压缩
吞吐量指标往往会受到合成营销宣传的影响,但当每秒 750 个 token 的流水线应用于深度迭代推理任务时,其实际意义便凸显出来。长链思考系统——即 AI 模型在给出最终响应前,会探索多种假设路径、执行外部代码工具并评估内部证明——每输出一个最终段落,就会产生数万个隐藏 token。
以 Cerebras 使用“人类终极考试”(Humanity’s Last Exam)基准套件进行的对比评估为例,这是一组包含 2,500 项旨在将前沿模型推向计算极限的多学科推理挑战。在标准加速器集群上运行,Anthropic 的 Claude Fable 5 需要 78 小时 27 分钟的持续计算才能处理完整个基准测试数据集。而在由 Cerebras 驱动的 Ultrafast 流水线上运行 GPT-5.6 Sol,仅用 11 小时 11 分钟就完成了完全相同的 2,500 题测试。将整整三天的执行时间压缩到一夜之间,使多步验证从异步批处理作业转变为可集成到主动工程冲刺中的操作。
这种速度乘数彻底改变了软件执行循环的经济性。当自动化开发环境可以在几秒钟内(而非几分钟)起草、编译、针对测试套件执行并重写复杂的嵌入式系统代码时,调试工作就从被动的等待状态转变为人类工程师与机器合成之间的交互式对话。
从 CS-3 到机架级 CS-4 的硬件演进
Ultrafast 背后的工程验证依赖于 Cerebras 定制服务器封装的快速迭代。部署层级最初利用的是 CS-3 系统,但 Cerebras 已经展示了其继任者 CS-4,该系统构建于其专有的 Nexus 机架架构之上。CS-4 将三个独立的晶圆级引擎处理器集成到一个机架框架中,与前几代相比,token 生成吞吐量翻了一番,预计在参数超过十万亿的模型上可实现每秒超过 1,000 个 token 的性能。
在硬件圈流传的早期性能评估显示,GPT-5.6 Sol 在 CS-4 硬件上的实验性配置已达到每秒约 1,300 个 token。虽然未经独立实验室测试证实,但这些数字反映了将模型权重完全嵌入高速 SRAM 寄存器所带来的巨大理论空间。物理挑战已从硅片内的电信号传播延迟转向热力学管理,这需要复杂的液冷歧管来散发每个机架单元数万瓦的热量,同时保持严格的热平衡。
对于企业系统架构师而言,这种硬件差异带来了关键的供应链选择。标准的 GPU 集群仍然是高度可互换的资产,能够在原始模型预训练、合成数据生成和并行批处理推理之间切换。相比之下,晶圆级机架是一种超专业化的仪器,专为内存受限、低批次推理而设计。部署这些系统需要专门的占地空间、定制的配电系统以及与专有编排中间件的紧密集成。
定价悖论与生产可行性
尽管每秒生成 750 个 token 是一项技术胜利,但商业现实带来了阻力。在 OpenAI 的开发者大会上,该公司正式推出了针对新款 GPT-6 Astra 模型的 Ultrafast 定价结构,其价格是基础推理成本的六倍——具体费率为每百万输入 token 60 美元,每百万输出 token 300 美元。该功能也被捆绑在每月 500 美元的 ChatGPT Pro 等高级套餐中。
然而,GPT-5.6 Sol Ultrafast 的处境却颇为尴尬。在标准基础设施推广下,底层模型的价格实际上已大幅下降,降至每百万输入 token 4 美元,每百万输出 token 20 美元。但其 Ultrafast 变体却没有公开报价,没有通用访问时间表,且被限制在需要直接与企业账户协商的范围内。这造成了一个工程悖论:旨在证明实时晶圆级执行可行性的旗舰模型,独立开发团队却无法将其列入预算。
这一差异凸显了以如此高频率运行模型所需的巨大资本支出。虽然晶圆级芯片消除了外部内存传输延迟,但整片晶圆的制造良率与小尺寸芯片相比依然较低,且功能核心的故障需要复杂的冗余电路路由。为实时交互式流量配置、冷却和运行多晶圆阵列的单位活跃用户线程成本仍然极高,这很可能阻碍了 OpenAI 在没有严格利润保障的情况下开放无限制访问权限。
对机器人技术和工业反馈循环的影响
对于成本与速度比极度不对称的技术,在何处可以证明其运营开销的合理性?答案不在于网络聊天机器人,而在于软件系统指挥物理执行器的物理边界:高端机器人、自动化供应链路由以及自主基础设施管理。
传统的机器人控制回路以毫秒为周期运行,而深度认知系统则需要几秒钟的时间来解析场景遥测数据并构建动作轨迹。这种时间上的脱节迫使工业工程师依赖小型、局部的视觉-语言-动作模型,这些模型缺乏全面的因果推理能力。如果自动化装配线出现意外异常——例如支架变形或传送带打滑——小型本地模型经常会因无法实时通过物理原理进行推理而失效。
运行速度为每秒 750 个 token 的推理层填补了这一运营鸿沟。以这种速度运行的前沿模型可以处理多个高分辨率多模态传感器输入,执行数十个前向模拟运动学方案,识别安全边缘情况,并在数百毫秒内输出具体的关节扭矩修正指令。在计划外停机会造成每分钟数万美元损失的工业供应链和精密制造业中,为每百万 token 支付溢价只是微不足道的运营开销。
归根结底,OpenAI 的 Ultrafast 预览版是一项基础性的工程证明。它证实了内存墙并非人工智能不可逾越的天花板,而是一种可以通过改变硬件拓扑结构来克服的机械摩擦。然而,在晶圆级硅片的制造经济性与成熟的微芯片封装达到平价之前,实时前沿推理仍将是精英级的工业奢侈品,而非普惠的通用工具。



Comments
No comments yet. Be the first!