La física detrás del cuello de botella de memoria
Para comprender por qué 750 tokens por segundo es relevante, es necesario diseccionar las limitaciones físicas de enrutamiento de los clústeres de GPU tradicionales. Al ejecutar la inferencia de un modelo de frontera en clústeres de tarjetas aceleradoras estándar, los núcleos de computación consumen ciclos de reloj inactivos considerables esperando la transferencia de parámetros. El ancho de banda de memoria entre las pilas de High Bandwidth Memory y el die del procesador actúa como un estrangulamiento eléctrico. Durante la generación, donde los tokens se producen secuencialmente uno a uno, los tamaños de lote (batch sizes) suelen limitarse para mantener una latencia de usuario inferior al segundo, lo que reduce la eficiencia general de la computación.
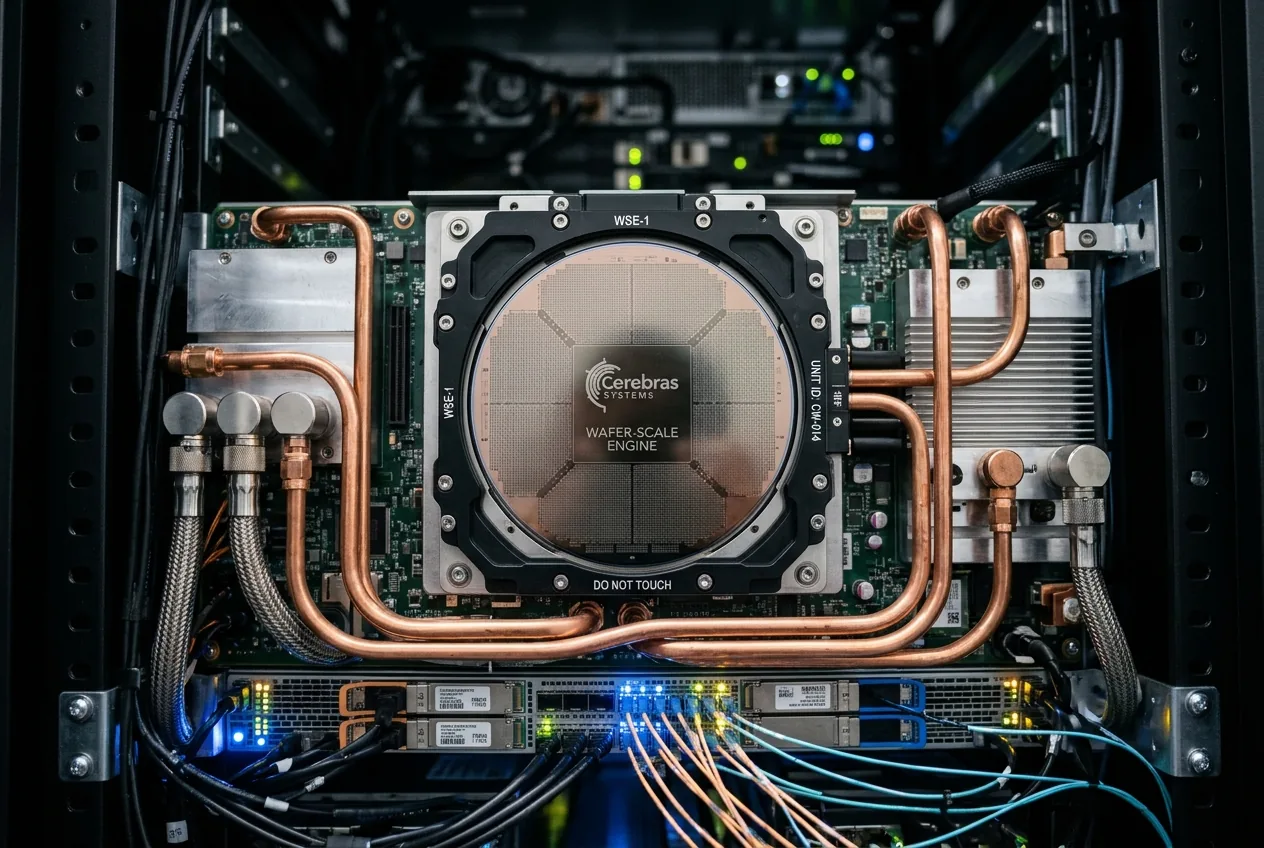
Dado que los parámetros físicos de un modelo de frontera superan la capacidad SRAM de una sola oblea, Cerebras conecta múltiples motores utilizando interconexiones dedicadas de baja latencia, creando un tejido unificado donde las capas se distribuyen a través de las obleas de silicio. Las penalizaciones de latencia que afectan a los clústeres de GPU distribuidos a través de redes InfiniBand se atenúan drásticamente. Los núcleos de computación se alimentan continuamente sin inanición de tuberías (pipeline starvation), lo que se traduce directamente en el rendimiento de salida 14 veces mayor observado en las primeras pruebas de rendimiento (benchmarks).
Realidades de los benchmarks y la compresión del tiempo
Las métricas de rendimiento a menudo sufren de inflación de marketing sintético, pero las implicaciones prácticas de una tubería de 750 tokens por segundo se vuelven evidentes cuando se aplican a tareas de razonamiento iterativo profundo. Los sistemas deliberativos de cadena larga —donde un modelo de IA explora múltiples vías hipotéticas, ejecuta herramientas de código externo y evalúa pruebas internas antes de emitir una respuesta definitiva— generan decenas de miles de tokens ocultos por cada párrafo de salida final.
Considere la evaluación comparativa de Cerebras utilizando el conjunto de benchmarks Humanity’s Last Exam, una colección de 2,500 desafíos de razonamiento multidisciplinario diseñados para llevar a los modelos de frontera al agotamiento computacional. Ejecutado en clústeres aceleradores estándar, Claude Fable 5 de Anthropic requirió 78 horas y 27 minutos de cómputo continuo para procesar el conjunto de datos completo. La ejecución de GPT-5.6 Sol en la tubería Ultrafast impulsada por Cerebras completó exactamente el mismo conjunto de 2,500 preguntas en 11 horas y 11 minutos. Comprimir tres días completos de ejecución en una corrida nocturna desplaza la verificación de múltiples pasos de un trabajo por lotes asíncrono a una operación que puede integrarse en sprints de ingeniería activos.
Este multiplicador de velocidad cambia por completo la economía de los bucles de ejecución de software. Cuando un entorno de desarrollo automatizado puede redactar, compilar, ejecutar conjuntos de pruebas y reescribir código complejo de sistemas embebidos en segundos en lugar de minutos, la depuración pasa de ser un estado de espera pasivo a un diálogo interactivo entre el ingeniero humano y la síntesis de la máquina.
Evolución del hardware: de CS-3 a CS-4 a escala de rack
La validación de ingeniería detrás de Ultrafast se basa en iteraciones rápidas del empaquetado de servidores personalizados de Cerebras. El nivel de despliegue utilizó inicialmente el sistema CS-3, pero Cerebras ya ha demostrado su sucesor, el CS-4, construido sobre su arquitectura de rack patentada Nexus. Al integrar tres procesadores Wafer-Scale Engine individuales en un marco de rack integrado, el CS-4 duplica el rendimiento de generación de tokens en comparación con las generaciones anteriores y se prevé que entregue más de 1,000 tokens por segundo en modelos que excedan los diez billones de parámetros.
Las primeras afirmaciones de rendimiento que circulan en los círculos de hardware sugieren que las configuraciones experimentales de GPT-5.6 Sol en hardware CS-4 han alcanzado aproximadamente 1,300 tokens por segundo. Si bien no han sido verificadas en pruebas de laboratorio independientes, tales cifras reflejan el margen teórico absoluto de mantener los pesos del modelo integrados completamente dentro de registros SRAM de alta velocidad. El desafío físico transita de los retrasos de propagación eléctrica dentro del silicio a la gestión termodinámica, lo que requiere complejos colectores de refrigeración líquida para disipar decenas de kilovatios por unidad de rack mientras se mantiene un estricto equilibrio térmico.
Para los arquitectos de sistemas empresariales, esta divergencia de hardware introduce decisiones críticas en la cadena de suministro. Los clústeres de GPU estándar siguen siendo activos profundamente fungibles, capaces de alternar entre el pre-entrenamiento de modelos brutos, la generación de datos sintéticos y la inferencia por lotes paralelos. Un rack a escala de oblea, por el contrario, es un instrumento ultra especializado diseñado específicamente para la inferencia vinculada a la memoria y de bajo lote. El despliegue de estos sistemas requiere espacio físico dedicado, distribución de energía a medida y una estrecha integración con middleware de orquestación patentado.
La paradoja de precios y la viabilidad de producción
A pesar del triunfo técnico de generar tres cuartos de millar de tokens cada segundo, las realidades comerciales introducen fricción. En los eventos DevDay de OpenAI, la empresa lanzó oficialmente la estructura de precios Ultrafast para su nuevo modelo GPT-6 Astra, facturándolo a seis veces el costo de inferencia base; específicamente, estableciendo tarifas en sesenta dólares por millón de tokens de entrada y trescientos dólares por millón de tokens de salida. La función también se incluyó en niveles premium como el plan ChatGPT Pro de quinientos dólares mensuales.
Sin embargo, GPT-5.6 Sol Ultrafast permanece curiosamente estancado. El modelo subyacente se ha vuelto significativamente más barato, bajando a cuatro dólares por millón de tokens de entrada y veinte dólares por millón de tokens de salida bajo promociones de infraestructura estándar. Pero su variante Ultrafast no tiene una tarjeta de precios pública, ni cronograma de acceso general, y está restringida detrás de una negociación directa de cuenta corporativa. Esto crea una paradoja de ingeniería: el modelo insignia diseñado para probar la viabilidad de la ejecución a escala de oblea en tiempo real no puede ser presupuestado por equipos de desarrollo independientes.
La discrepancia destaca el brutal gasto de capital requerido para servir modelos a estas frecuencias. Si bien el silicio a escala de oblea elimina los retrasos de transporte de memoria externa, los rendimientos de fabricación en obleas completas siguen siendo intrínsecamente bajos en comparación con los chips de troquel pequeño, y las fallas en los núcleos funcionales exigen un sofisticado enrutamiento de circuitos redundantes. El costo de aprovisionar, enfriar y ejecutar arreglos de múltiples obleas para tráfico interactivo en tiempo real sigue siendo extraordinariamente alto por hilo de usuario activo, lo que probablemente disuade a OpenAI de abrir el acceso sin restricciones sin una estricta protección de márgenes.
Implicaciones para la robótica y los bucles de retroalimentación industrial
¿Dónde podría una tecnología con proporciones de costo-velocidad tan asimétricas justificar sus gastos operativos? La respuesta no reside en los chatbots web, sino en el límite físico donde los sistemas de software comandan actuadores físicos: robótica de alta gama, enrutamiento automatizado de cadenas de suministro y gestión de infraestructura autónoma.
Los bucles de control robótico tradicionales operan en ciclos de milisegundos, mientras que los sistemas cognitivos profundos tardan segundos en analizar la telemetría de la escena y construir trayectorias de acción. Esta desconexión temporal obliga a los ingenieros industriales a confiar en modelos pequeños y localizados de visión-lenguaje-acción que carecen de un razonamiento causal integral. Si una anomalía inesperada afecta a una línea de montaje automatizada —como un soporte distorsionado o un deslizamiento de cinta transportadora no indexado— los modelos locales pequeños fallan con frecuencia porque no pueden razonar sobre la física novedosa al vuelo.
Un nivel de inferencia que funciona a 750 tokens por segundo cierra este abismo operativo. Un modelo de frontera operando a esta velocidad puede digerir múltiples entradas de sensores multimodales de alta resolución, ejecutar docenas de planes cinemáticos simulados, identificar casos límite de seguridad y emitir correcciones concretas de par motor en cientos de milisegundos. En las cadenas de suministro industriales y la fabricación de precisión, donde el tiempo de inactividad no planificado genera pérdidas de decenas de miles de dólares por minuto, pagar una prima por millón de tokens representa un gasto operativo insignificante.
En última instancia, la vista previa Ultrafast de OpenAI es una prueba de ingeniería fundamental. Confirma que el muro de memoria no es un techo inmutable para la inteligencia artificial, sino una fricción mecánica que puede superarse alterando la topología del hardware. Sin embargo, hasta que la economía de fabricación del silicio a escala de oblea alcance la paridad con el empaquetado de microchips maduros, el razonamiento de frontera en tiempo real seguirá siendo un lujo industrial de élite en lugar de una utilidad ambiental.



Comments
No comments yet. Be the first!