La physique derrière le goulot d'étranglement de la mémoire
Pour comprendre pourquoi 750 jetons par seconde sont significatifs, il faut disséquer les limites physiques de routage des clusters de GPU traditionnels. Lors de l'exécution de l'inférence sur un modèle de pointe au sein de clusters de cartes accélératrices standard, les cœurs de calcul passent un temps considérable en cycles d'horloge inactifs, attendant les transferts de paramètres. La bande passante mémoire entre les piles de mémoire à haute bande passante (HBM) et la puce du processeur agit comme un étranglement électrique. Pendant la génération, où les jetons sont produits séquentiellement un par un, la taille des lots est souvent limitée pour maintenir une latence utilisateur inférieure à la seconde, ce qui réduit l'efficacité globale du calcul.
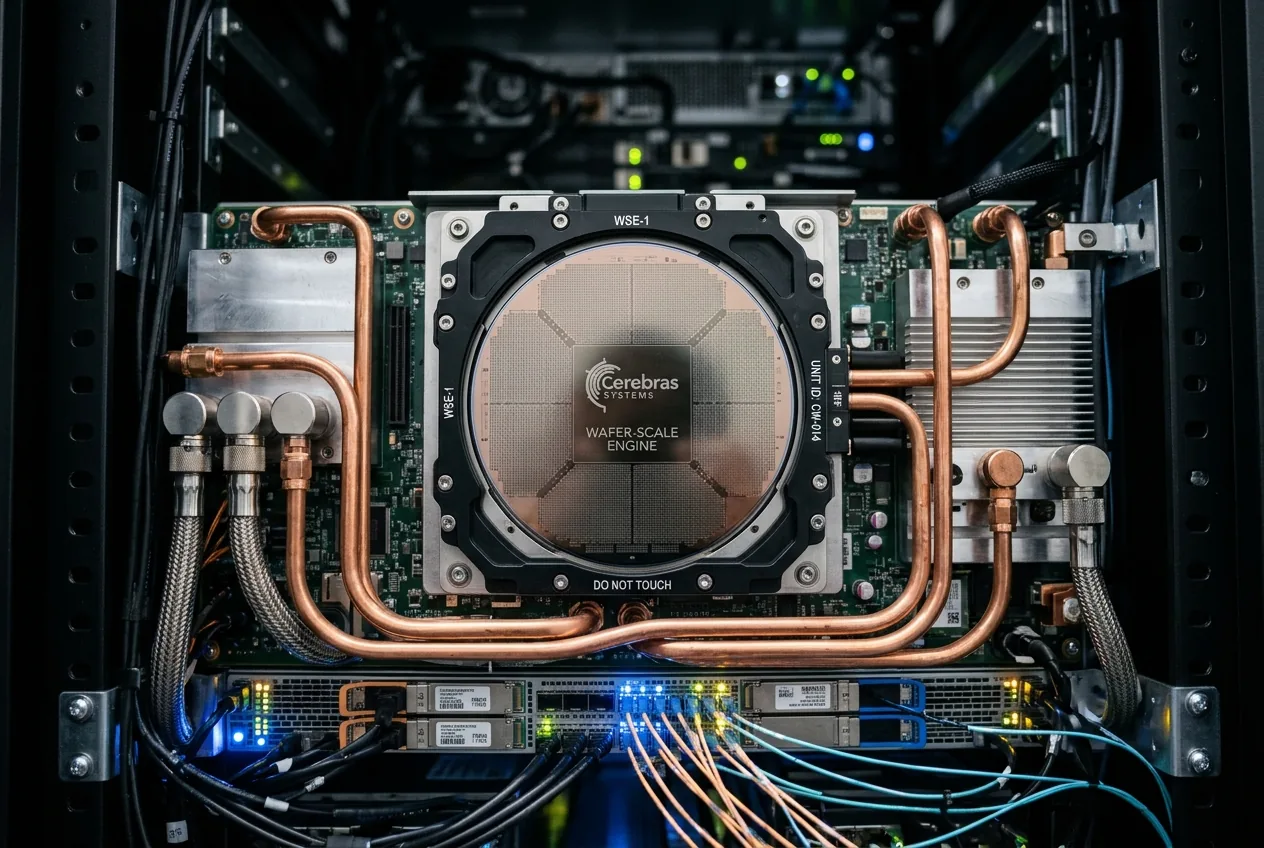
Comme les paramètres physiques d'un modèle de pointe dépassent la capacité SRAM d'une seule galette de silicium, Cerebras relie plusieurs moteurs à l'aide d'interconnexions dédiées à faible latence, créant une structure unifiée où les couches s'étendent sur plusieurs galettes. Les pénalités de latence qui affectent les clusters de GPU distribués sur des réseaux InfiniBand sont considérablement atténuées. Les cœurs de calcul sont alimentés en continu sans rupture de pipeline, ce qui se traduit directement par le débit de sortie 14 fois supérieur observé lors des premiers tests.
Réalités des benchmarks et compression du temps
Les mesures de débit souffrent souvent d'une inflation marketing synthétique, mais les implications pratiques d'un pipeline à 750 jetons par seconde deviennent frappantes lorsqu'elles sont appliquées à des tâches de raisonnement itératif approfondi. Les systèmes délibératifs à longue chaîne — où un modèle d'IA explore plusieurs voies hypothétiques, exécute des outils de code externes et évalue des preuves internes avant d'émettre une réponse définitive — génèrent des dizaines de milliers de jetons cachés pour chaque paragraphe de sortie final.
Considérons l'évaluation comparative de Cerebras utilisant la suite de benchmarks Humanity's Last Exam, une collection de 2 500 défis de raisonnement multidisciplinaires conçus pour pousser les modèles de pointe jusqu'à l'épuisement computationnel. Exécuté sur des clusters d'accélérateurs standard, Claude Fable 5 d'Anthropic a nécessité 78 heures et 27 minutes de calcul continu pour traiter l'ensemble de la suite de tests. L'exécution de GPT-5.6 Sol sur le pipeline Ultrafast propulsé par Cerebras a terminé la même suite de 2 500 questions en 11 heures et 11 minutes. Compresser trois journées complètes d'exécution en une nuit transforme la vérification multi-étapes d'un travail par lots asynchrone en une opération capable de s'intégrer dans des sprints d'ingénierie actifs.
Ce multiplicateur de vitesse change radicalement l'économie des boucles d'exécution logicielle. Lorsqu'un environnement de développement automatisé peut rédiger, compiler, exécuter des suites de tests et réécrire du code complexe de systèmes embarqués en quelques secondes plutôt qu'en quelques minutes, le débogage passe d'un état d'attente passive à un dialogue interactif entre l'ingénieur humain et la synthèse machine.
Évolution du matériel : du CS-3 au CS-4 à l'échelle du rack
La validation technique derrière Ultrafast repose sur des itérations rapides du packaging serveur personnalisé de Cerebras. Le niveau de déploiement a initialement exploité le système CS-3, mais Cerebras a déjà fait la démonstration de son successeur, le CS-4, construit sur son architecture propriétaire Nexus rack. Intégrant trois processeurs Wafer-Scale Engine dans un châssis de rack, le CS-4 double le débit de génération de jetons par rapport aux générations précédentes et devrait atteindre plus de 1 000 jetons par seconde sur des modèles dépassant dix mille milliards de paramètres.
Les premières assertions de performance circulant dans les milieux matériels suggèrent que les configurations expérimentales de GPT-5.6 Sol sur le matériel CS-4 ont frôlé les 1 300 jetons par seconde. Bien que non vérifiés par des tests de laboratoire indépendants, ces chiffres reflètent l'énorme marge de manœuvre théorique offerte par le maintien des poids du modèle entièrement intégrés dans des registres SRAM à haute vitesse. Le défi physique passe de la propagation électrique au sein du silicium à la gestion thermodynamique, nécessitant des collecteurs de refroidissement liquide complexes pour dissiper des dizaines de kilowatts par unité de rack tout en maintenant un équilibre thermique strict.
Pour les architectes de systèmes d'entreprise, cette divergence matérielle introduit des choix cruciaux en matière de chaîne d'approvisionnement. Les clusters GPU standard restent des actifs hautement fongibles, capables d'alterner entre le pré-entraînement brut de modèles, la génération de données synthétiques et l'inférence par lots parallèles. Un rack à l'échelle de la galette, en revanche, est un instrument ultra-spécialisé conçu spécifiquement pour l'inférence à faible taille de lots limitée par la mémoire. Le déploiement de ces systèmes nécessite une surface au sol dédiée, une distribution électrique sur mesure et une intégration étroite avec un middleware d'orchestration propriétaire.
Le paradoxe des prix et la viabilité de la production
Malgré le succès technique de la génération de 750 jetons par seconde, les réalités commerciales introduisent des frictions. Lors des événements DevDay d'OpenAI, l'entreprise a officiellement lancé la structure tarifaire Ultrafast pour son nouveau modèle GPT-6 Astra, la facturant six fois le coût d'inférence de base — fixant spécifiquement les tarifs à soixante dollars par million de jetons d'entrée et trois cents dollars par million de jetons de sortie. La fonctionnalité a également été intégrée aux niveaux premium, comme le plan ChatGPT Pro à cinq cents dollars par mois.
Pourtant, GPT-5.6 Sol Ultrafast reste étrangement bloqué. Le modèle sous-jacent est en réalité devenu nettement moins cher, tombant à quatre dollars par million de jetons d'entrée et vingt dollars par million de jetons de sortie dans le cadre des promotions d'infrastructure standard. Mais sa variante Ultrafast n'affiche aucun prix public, aucun calendrier d'accès général, et est réservée aux négociations directes avec les comptes entreprises. Cela crée un paradoxe d'ingénierie : le modèle phare conçu pour prouver la viabilité de l'exécution en temps réel à l'échelle de la galette ne peut pas être budgétisé par des équipes de développement indépendantes.
La divergence souligne les dépenses d'investissement brutales nécessaires pour servir des modèles à ces fréquences. Bien que le silicium à l'échelle de la galette élimine les délais de transport de mémoire externe, les rendements de fabrication sur des galettes entières restent intrinsèquement faibles par rapport aux puces de petite taille, et les défaillances sur les cœurs fonctionnels exigent un routage redondant sophistiqué. Le coût pour provisionner, refroidir et exploiter des réseaux multi-galettes pour un trafic interactif en temps réel reste extraordinairement élevé par fil d'exécution actif, ce qui dissuade probablement OpenAI d'ouvrir un accès illimité sans protection stricte des marges.
Implications pour la robotique et les boucles de rétroaction industrielle
Où une technologie avec des ratios coût-vitesse aussi asymétriques pourrait-elle justifier ses frais opérationnels ? La réponse ne réside pas dans les chatbots web, mais à la frontière physique où les systèmes logiciels commandent des actionneurs physiques : robotique haut de gamme, routage automatisé de la chaîne d'approvisionnement et gestion des infrastructures autonomes.
Les boucles de contrôle robotique traditionnelles fonctionnent sur des cycles de l'ordre de la milliseconde, tandis que les systèmes cognitifs profonds prennent des secondes pour analyser la télémétrie de la scène et construire des trajectoires d'action. Cette déconnexion temporelle contraint les ingénieurs industriels à s'appuyer sur de petits modèles vision-langage-action localisés, dépourvus de raisonnement causal complet. Si une anomalie inattendue frappe une ligne d'assemblage automatisée — comme un support déformé ou un glissement de convoyeur non indexé — les petits modèles locaux échouent fréquemment car ils ne peuvent pas raisonner sur une physique nouvelle à la volée.
Un niveau d'inférence fonctionnant à 750 jetons par seconde comble ce fossé opérationnel. Un modèle de pointe opérant à cette vitesse peut digérer plusieurs entrées de capteurs multimodaux haute résolution, exécuter des dizaines de plans cinématiques simulés, identifier les cas limites de sécurité et produire des corrections de couple articulaire concrètes en quelques centaines de millisecondes. Dans les chaînes d'approvisionnement industrielles et la fabrication de précision, où les temps d'arrêt non planifiés entraînent des pertes se comptant en dizaines de milliers de dollars par minute, payer une prime par million de jetons représente une dépense opérationnelle négligeable.
En fin de compte, l'aperçu d'Ultrafast par OpenAI est une preuve d'ingénierie fondamentale. Il confirme que le « mur de la mémoire » n'est pas un plafond immuable pour l'intelligence artificielle, mais une friction mécanique qui peut être surmontée en modifiant la topologie matérielle. Tant que l'économie de fabrication du silicium à l'échelle de la galette n'aura pas atteint la parité avec le packaging mature des micropuces, le raisonnement de pointe en temps réel restera toutefois un luxe industriel d'élite plutôt qu'un service banalisé.



Comments
No comments yet. Be the first!